Descrição
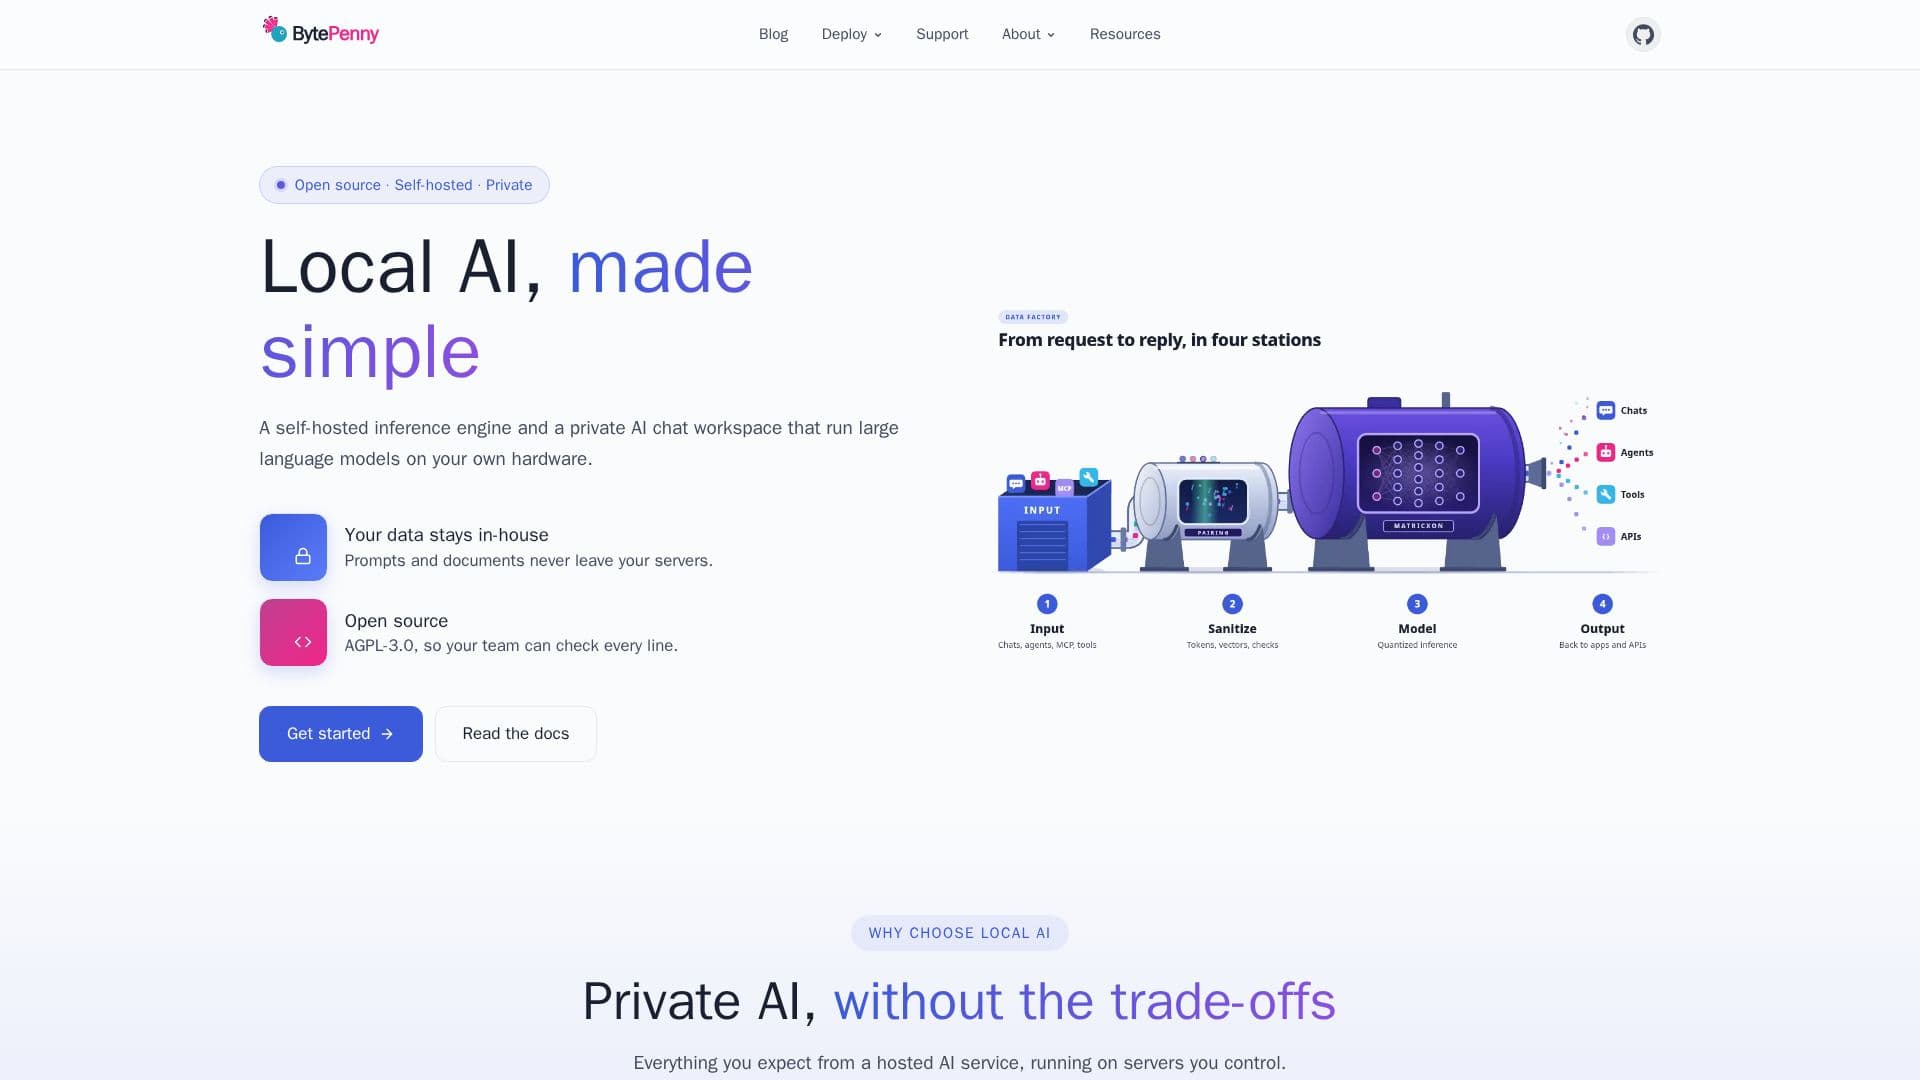
BytePenny fornece um conjunto abrangente de ferramentas de IA de código aberto e auto-hospedadas projetadas para privacidade e controle. A oferta principal inclui Matricxon, um mecanismo de inferência GGUF de código aberto, e pAIring, um espaço de trabalho de chat de IA privado adaptado para equipes. Esses produtos permitem que as organizações executem grandes modelos de linguagem diretamente em seu próprio hardware, garantindo que prompts, documentos e dados de chat nunca deixem seus servidores.
Ler mais
A plataforma enfatiza a privacidade dos dados, operando totalmente offline para manter todas as informações sensíveis internamente. Suporta vários modelos GGUF de fontes como Hugging Face, llama.cpp ou motores Matricxon, e pode se integrar a servidores de ferramentas MCP. BytePenny é construído com uma filosofia de código aberto, utilizando uma licença AGPL-3.0, que permite que as equipes inspecionem e modifiquem cada linha de código, promovendo transparência e confiança.
Matricxon, o mecanismo de inferência, é um runtime LLM leve e legível escrito em Python e PyTorch, apresentando núcleos C nativos para desempenho acelerado. Suporta modelos GGUF para tarefas como chat, geração de texto, embeddings, reranking, modelos de visão-linguagem e previsão de séries temporais, servindo-os via uma API HTTP. Funciona de forma eficiente em CPUs e oferece suporte BETA para GPUs NVIDIA, com planos de expansão para GPUs AMD e Apple Silicon. Matricxon também suporta um modo de cluster para modelos compartilhados e caches de chat em vários nós, gerenciados a partir da interface do usuário do pAIring.
pAIring, o espaço de trabalho de chat de IA privado, é projetado para colaboração em equipe, oferecendo recursos como acesso baseado em funções, canais compartilhados e uma base de conhecimento integrada. Fornece caches de chat criptografados e garante que os prompts nunca sejam usados para treinamento de modelos. O sistema é escalável, permitindo que os usuários comecem com um único servidor e expandam adicionando nós com balanceamento de carga e capacidades de failover. Para cenários que exigem mais poder, pAIring pode se conectar a vários provedores de nuvem como Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq e mais, oferecendo flexibilidade para misturar motores locais e em nuvem.
BytePenny elimina a cobrança por token, permitindo que as organizações aproveitem o hardware existente e mantenham custos fixos à medida que o uso cresce. Toda a pilha é projetada para ser aberta, desde o código AGPL-3.0 até modelos de pesos abertos, tornando-a ideal para redes privadas e fechadas. A segurança é uma preocupação primordial, com recursos como senhas hash bcrypt, segredos armazenados criptografados, caches de chat criptografados com AES-256-GCM e verificações de função do lado do servidor para ações administrativas. Tanto Matricxon quanto pAIring receberam o selo de 'passagem' das Melhores Práticas OpenSSF, demonstrando um compromisso com práticas de desenvolvimento seguro.
- CategoriaMLOps e implantação de modelos
- Modelo de preçosOpen Source (AGPL-3.0), No Per-Token Bills
- ImplantaçãoSelf-Hosted, On-Premise, Cloud (Hybrid)
- PlataformasWindows, Linux
Recursos principais de BytePenny
Mecanismo de inferência de IA auto-hospedado (Matricxon)
Espaço de trabalho de chat de IA privado para equipes (pAIring)
Executa grandes modelos de linguagem em seu próprio hardware
Os dados permanecem internos; prompts e documentos nunca deixam os servidores
Código aberto com licença AGPL-3.0
Funciona totalmente offline
Caches de chat criptografados com AES-256-GCM
Acesso baseado em funções para equipes
Prompts nunca usados para treinamento de modelos
Suporta modelos GGUF de Hugging Face, llama.cpp, Matricxon
Núcleos quantizados para suporte a CPU e GPU NVIDIA
Sem cobrança por token; custos fixos com crescimento do uso
Implantação escalável: único nó, cluster compartilhado ou servidores separados
Conecta-se a mais de 12 provedores de nuvem (Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq, etc.)
Escrito do zero em Python para legibilidade e personalização
Como usar BytePenny?
Implantar BytePenny: Instale Matricxon e pAIring em seus próprios servidores ou infraestrutura de nuvem.
Configurar o Mecanismo de Inferência: Configure Matricxon como o mecanismo de inferência local ou conecte pAIring a um provedor de nuvem preferido.
Adicionar Modelos: Integre modelos GGUF de Hugging Face ou outras fontes, ou utilize modelos hospedados em nuvem via conectores.
Gerenciar Usuários e Equipes: Configure acesso baseado em funções, crie canais compartilhados e estabeleça uma base de conhecimento dentro do pAIring.
Começar a Conversar: Inicie conversas privadas de IA e aproveite a base de conhecimento para colaboração em equipe.
Monitorar e Escalar: Observe o status do sistema, gerencie nós de cluster e expanda o hardware à medida que o uso cresce sem incorrer em custos por token.
Casos de uso de BytePenny
- Chat Privado para Equipes
- Inferência LLM Local
- Análise de Documentos Seguros
- Operações de IA com Controle de Custos
- Fluxos de Trabalho de IA Offline
- Implantação de Modelos Personalizados
- Infraestrutura de IA Escalável
- Desenvolvimento de IA de Código Aberto