Deskripsi
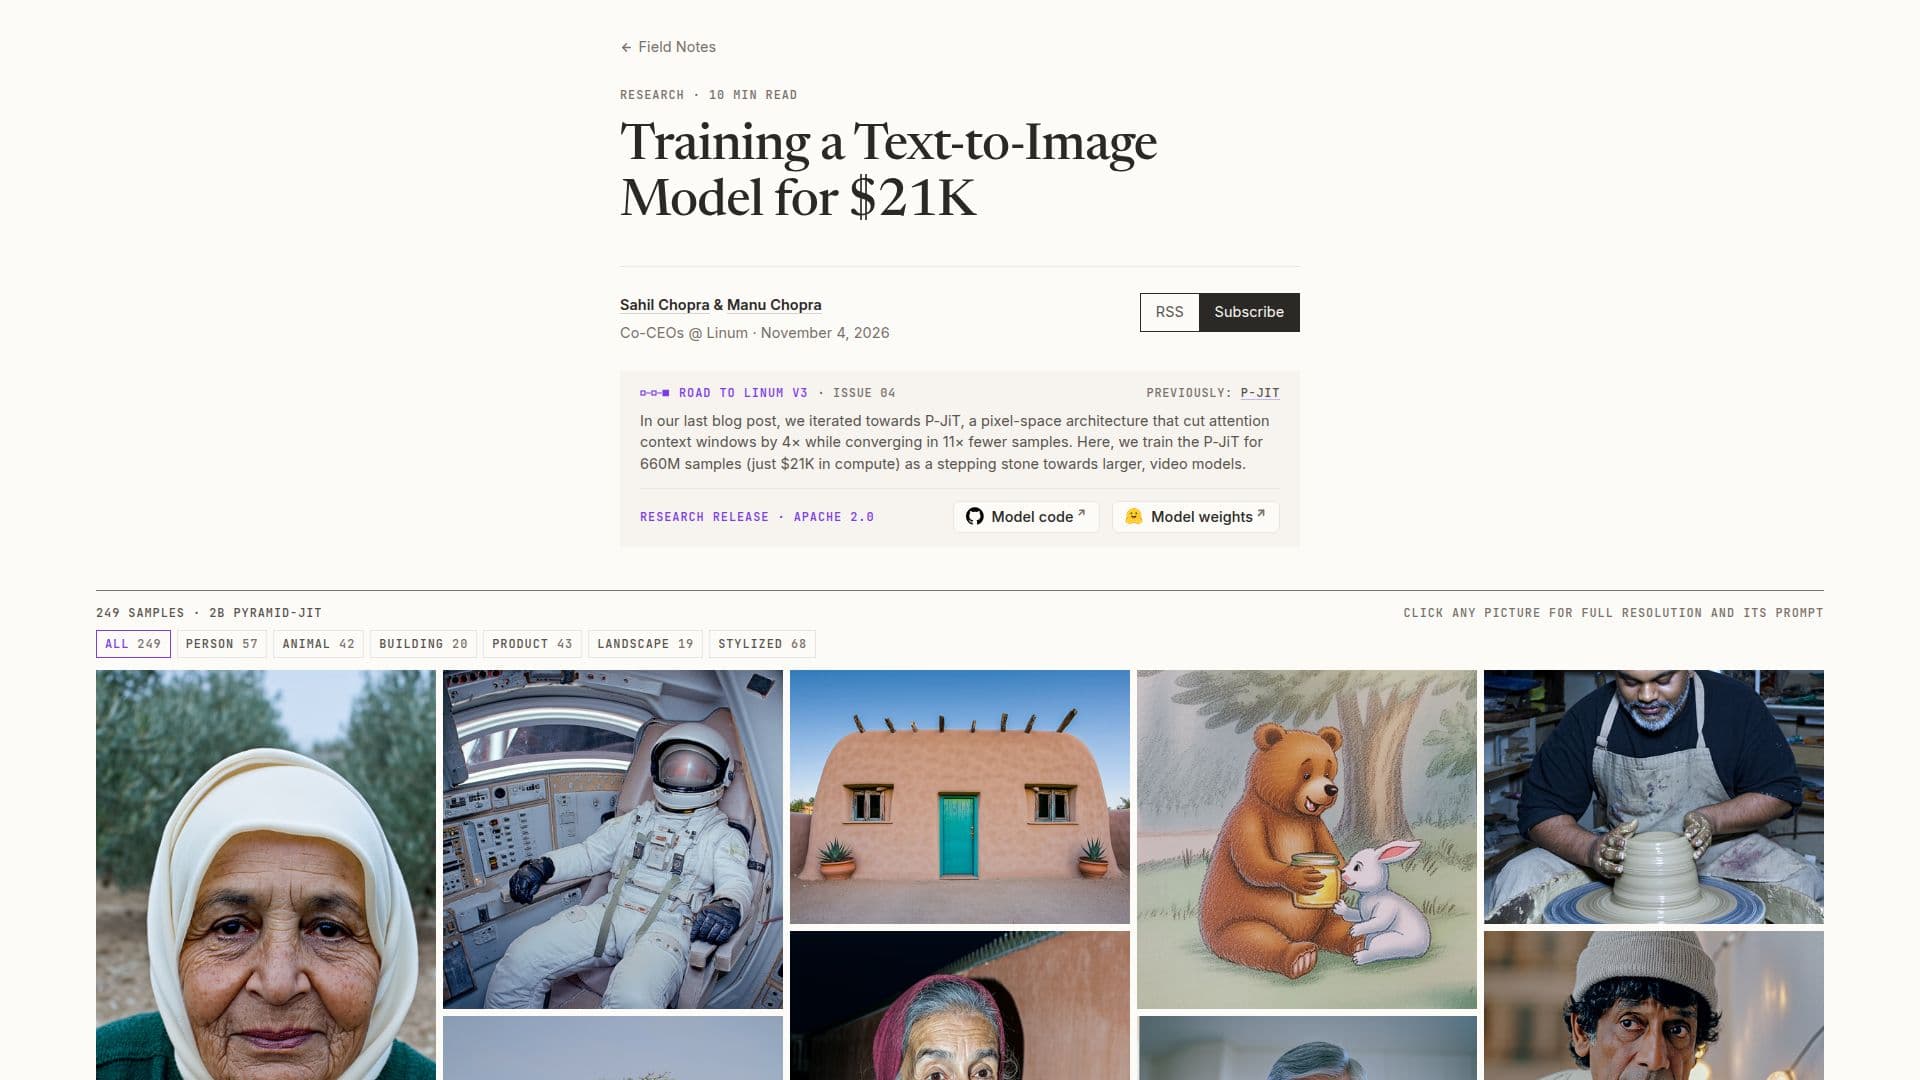
Linum P-JiT adalah model teks-ke-gambar eksperimental yang dikembangkan oleh Linum, sebuah laboratorium penelitian yang terdiri dari dua orang yang didedikasikan untuk melatih model video generatif dari awal. Model khusus ini, Pyramid-JiT (P-JiT) dengan 2B parameter, berfungsi sebagai bukti konsep untuk penelitian mereka yang sedang berlangsung dalam mendemokratisasi akses ke animasi melalui alat generatif yang hemat biaya dan dapat dikendalikan. Biaya pelatihan untuk model ini sekitar $21,038, menunjukkan potensi untuk hasil berkualitas tinggi dengan biaya komputasi yang relatif rendah.
Baca Selengkapnya
Inovasi inti di balik P-JiT adalah kemampuannya untuk mencapai kompresi yang lebih agresif dan pembelajaran yang lebih cepat dengan menghilangkan Variational Autoencoder (VAE) tradisional dari arsitektur model difusi. Sebagai gantinya, model difusi mempelajari ruang laten yang dirancang khusus untuk kasus penggunaannya, memungkinkan kompresi yang lebih besar dan generasi yang lebih baik. Model ruang piksel ini berkonvergensi dalam 11 kali lebih sedikit sampel dibandingkan Linum v2 dan menawarkan pengurangan token yang empat kali lebih agresif, mewakili gambar 512x512 dengan jumlah token yang sama yang sebelumnya digunakan untuk gambar 256x256. Ini berarti pengurangan empat kali lipat dalam jendela konteks perhatian, secara signifikan mengurangi biaya pelatihan dan inferensi.
Arsitektur P-JiT menggabungkan jalur pemrosesan teks dan gambar, di mana setiap modalitas melewati blok "refiner" DiT satu modalitas sebelum bergabung menjadi aliran 22 blok DiT identik. Representasi teks diambil dari model Qwen3.5-4B yang dibekukan, sementara gambar dibagi menjadi patch 32x32 dan dikompresi ke dalam ruang berdimensi 1024. Model ini juga dilengkapi dengan pembacaan PixelREPA yang diselaraskan dengan DINOv3-L dan kepala pembacaan linier tambahan di sepanjang batang untuk mempercepat konvergensi dengan memprediksi versi resolusi rendah dari gambar akhir.
Pelatihan dilakukan dalam beberapa tahap, dimulai pada resolusi 512x512 untuk 610 juta sampel dan kemudian beralih ke resolusi 1024x1024 untuk 50 juta sampel. Kurikulum di atas jadwal kebisingan digunakan, awalnya berkonsentrasi pada kebisingan tinggi untuk mempelajari struktur dasar, kemudian memperlebar distribusi untuk detail halus. Setelah pelatihan, melibatkan varian dari Finite Difference Flow Optimization (FDFO) dengan JEV-Image dan juri manusia dalam loop. Meskipun model menunjukkan hasil yang menjanjikan, ia memiliki keterbatasan, terutama dalam generasi tubuh penuh, banyak entitas, interaksi multi-orang, dan pengetahuan dunia, yang umum untuk model seukuran ini. Model ini tidak dilatih dengan gambar teks yang dirender, sehingga tidak dapat menghasilkan teks atau poster.
- KategoriModel AI & LLM
- Model HargaOpen source
- PenerapanCloud
- PlatformWeb
Fitur Inti Linum P-JiT
Arsitektur Pyramid-JiT (P-JiT): Model ruang piksel baru untuk generasi yang efisien
DiT 2B-Parameter: Ukuran model transformator difusi inti
Pengkode Teks 4B: Menggunakan model Qwen3.5-4B yang dibekukan untuk representasi teks
Desain Tanpa VAE: Menghilangkan VAE untuk kompresi yang lebih agresif dan pembelajaran yang lebih cepat
Pengurangan Token 4x: Mewakili gambar 512x512 dengan 4x lebih sedikit token dibandingkan Linum v2
Konvergensi 11x Lebih Cepat: Mencapai hasil dengan sampel pelatihan yang jauh lebih sedikit
Pelatihan Multi-Tahap: Berproses dari resolusi 512x512 ke 1024x1024
Jadwal Kebisingan Kurikulum: Mengadaptasi distribusi kebisingan untuk pembelajaran struktur dan detail
Pembacaan PixelREPA: Menyelaraskan ruang laten ke DINOv3-L untuk pembelajaran detail yang lebih baik
Kepala Pembacaan Linier: Memprediksi gambar bersih pada seperempat dan setengah resolusi untuk mempercepat konvergensi
Optimisasi Aliran Perbedaan Hingga (FDFO): Digunakan untuk penyempurnaan pasca-pelatihan
Lisensi Apache 2.0: Bobot dirilis di bawah lisensi sumber terbuka
Pelatihan Hemat Biaya: Mencapai hasil berkualitas tinggi dengan biaya sekitar $21K
Fokus pada Penelitian Video Generatif: Langkah menuju model video masa depan
Cara menggunakan Linum P-JiT?
Pahami Arsitektur: Tinjau detail arsitektur P-JiT, termasuk alur pemrosesan teks dan gambar.
Periksa Regime Pelatihan: Pelajari tentang proses pelatihan multi-tahap, jadwal kebisingan, dan transisi resolusi.
Jelajahi Keterbatasan Model: Pahami keterbatasan saat ini terkait generasi tubuh penuh, banyak entitas, dan generasi teks.
Akses Pengaturan Pelatihan: Rujuk ke Lampiran A untuk parameter dan konfigurasi pelatihan yang terperinci.
Tinjau Rincian Biaya: Lihat rincian biaya komputasi sebelum dan sesudah pelatihan.
Analisis Contoh Kegagalan: Pelajari contoh kegagalan model yang disediakan untuk memahami kemampuan saat ini dan area untuk perbaikan.
Kasus Penggunaan Linum P-JiT
- Penelitian Generasi Teks-ke-Gambar
- Pelatihan Model Hemat Biaya
- Pengembangan Model Video Generatif
- Pengujian Inovasi Arsitektur
- Eksperimen AI Sumber Terbuka