Deskripsi
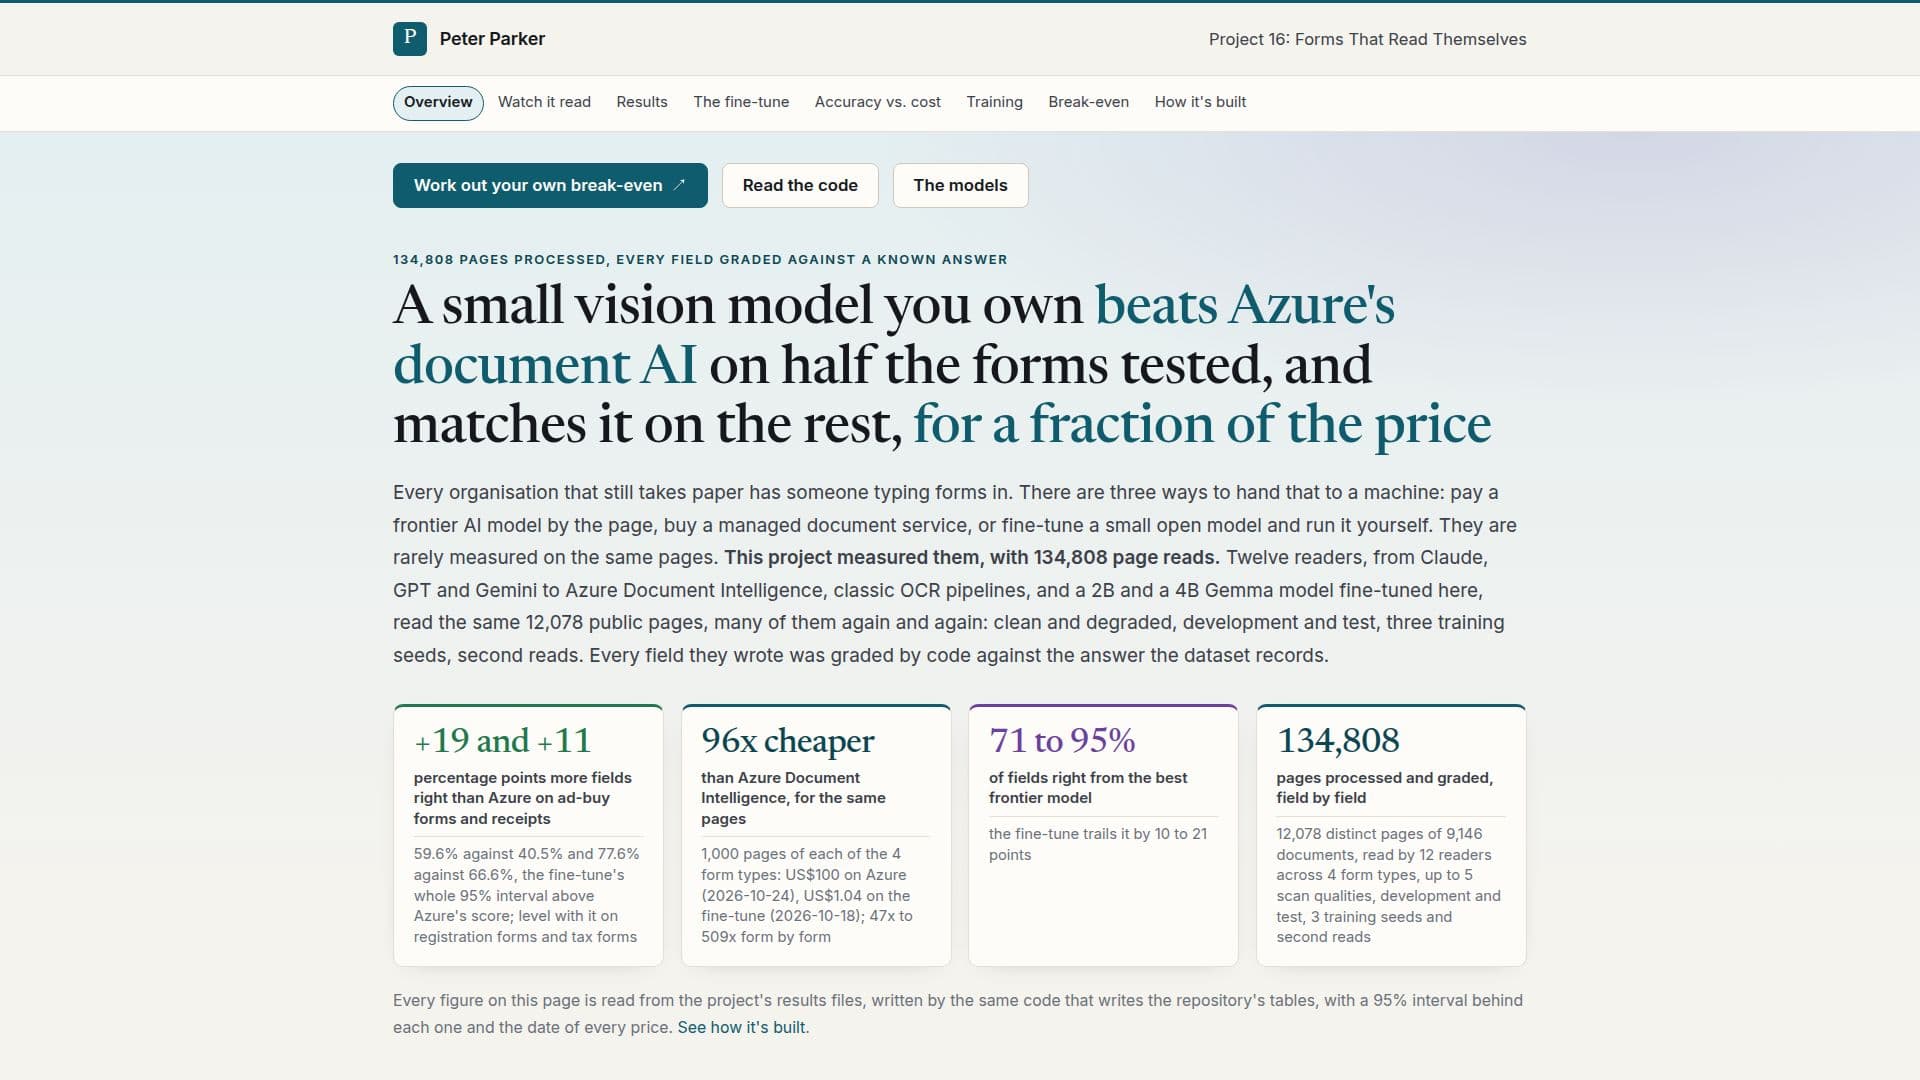
Forms That Read Themselves memperkenalkan evaluasi komprehensif dari dua belas pembaca berbeda untuk formulir yang dipindai, mulai dari API visi mutakhir hingga model kustom 2B parameter yang disesuaikan khusus untuk tujuan ini. Penawaran inti adalah model visi kecil yang dapat dimiliki dan dioperasikan oleh pengguna, memberikan alternatif yang hemat biaya untuk solusi komersial seperti Azure Document Intelligence.
Baca Selengkapnya
Platform ini secara teliti menilai setiap pembaca secara mendetail pada dataset publik dengan jawaban yang diketahui, termasuk NIST Special Database 2 untuk formulir pajak AS 1988, pengajuan Foreign Agents Registration Act, pesanan iklan politik FCC, dan kwitansi CORD v2. Benchmarking yang ketat ini mengungkapkan bahwa model yang disesuaikan mengungguli Azure Document Intelligence pada setengah dari jenis formulir yang diuji dan mencocokkan kinerjanya pada sisanya, semuanya sambil beroperasi dengan biaya yang jauh lebih rendah. Misalnya, pada formulir pembelian iklan, model yang disesuaikan mencapai akurasi 59,6% dibandingkan dengan 40,5% milik Azure, dan pada kwitansi, 77,6% dibandingkan dengan 66,6%.
Temuan kunci adalah dampak transformasional dari penyetelan pada model yang lebih kecil. Model yang tidak disetel seperti Gemma 4 E2B menunjukkan akurasi yang jauh lebih rendah (misalnya, 15,0% pada formulir pajak), yang secara dramatis meningkat menjadi 73,6% setelah penyetelan. Proses ini, yang dapat memakan waktu antara 8 menit hingga 4,9 jam pada GPU sewaan, menjadikan model-model kecil ini sangat kompetitif. Model yang disesuaikan juga menunjukkan tingkat penginventaran nilai yang lebih rendah dibandingkan dengan model terdepan pada jenis formulir tertentu, seperti formulir pendaftaran dan kwitansi, yang sangat penting untuk aplikasi di mana kolom kosong lebih disukai daripada entri yang yakin tetapi salah.
Sementara model visi terdepan seperti GPT-6.1 Sol dan Gemini 3.8 Flash umumnya mencapai akurasi yang lebih tinggi, model yang disesuaikan menawarkan keseimbangan yang menarik antara kinerja dan biaya. Misalnya, pada kwitansi, ia mencapai akurasi 77,6% dengan biaya US$0,16 per seribu halaman, dibandingkan dengan 76,7% milik Claude Haiku 5.5 dengan biaya US$0,38. Keuntungan signifikan dari memiliki dan menjalankan model pada GPU konsumen adalah peningkatan privasi data, karena tidak ada halaman yang perlu meninggalkan jaringan pengguna.
Proyek ini juga menyoroti ketahanan model visi terhadap degradasi pemindaian. Berbeda dengan pipeline berbasis OCR, yang mengalami penurunan akurasi drastis dengan kualitas pemindaian yang buruk, model visi yang membaca piksel secara langsung mempertahankan kinerja tinggi. Namun, penting untuk dicatat bahwa tidak ada pembaca yang mencapai akurasi 99% pada semua kolom, yang berarti verifikasi manusia tetap diperlukan untuk aplikasi kritis. Model ini terutama mengotomatiskan proses pengetikan, bukan pemeriksaan akhir.
Arsitektur melibatkan pelatihan model Gemma 4 E2B dan E4B dengan bobot terbuka menggunakan QLoRA, membekukan bobot model dasar dalam 4 bit sambil melatih matriks adaptor kecil. Adaptor ini disajikan dengan vLLM pada GPU RTX 3090, memungkinkan penerapan yang efisien di tempat. Situs ini menyediakan kalkulator untuk menentukan titik impas antara biaya API dan sewa GPU, menekankan bahwa biaya sebenarnya dari model yang dimiliki tergantung pada pemanfaatannya.
- KategoriAlat Computer Vision
- Model HargaGPU Rental Cost
- PenerapanOn-Premise
- PlatformWeb
Fitur Inti Forms That Read Themselves
Model visi yang disesuaikan untuk ekstraksi formulir yang dipindai
Benchmarking terhadap API visi terdepan (GPT-6.1 Sol, Claude Sonnet, Gemini Flash)
Perbandingan dengan Azure Document Intelligence
Dukungan untuk berbagai jenis formulir: pendaftaran, pembelian iklan, kwitansi, formulir pajak
Penilaian akurasi secara mendetail pada dataset publik
Alternatif hemat biaya untuk API komersial
Kemampuan penerapan di tempat pada GPU konsumen (misalnya, RTX 3090)
Pengurangan penginventaran nilai pada jenis formulir tertentu
Ketahanan terhadap degradasi pemindaian (noise, blur, skew, hilangnya kontras)
Metrik kinerja terperinci termasuk kolom yang benar dan biaya per seribu halaman
Model dasar dengan bobot terbuka (Gemma 4 E2B, E4B) digunakan untuk penyetelan
Resep penyetelan QLoRA untuk pelatihan efisien pada GPU tunggal
vLLM untuk menyajikan model yang disesuaikan
Kalkulator untuk analisis titik impas biaya API vs. GPU yang dimiliki
Privasi data dengan menjaga halaman dalam jaringan Anda
Cara menggunakan Forms That Read Themselves?
Pilih Pembaca: Pilih dari berbagai model visi atau pipeline OCR untuk membandingkan kinerjanya.
Sesuaikan Kualitas Pemindaian: Simulasikan berbagai tingkat degradasi (noise, blur, skew, hilangnya kontras) untuk mengamati dampaknya pada akurasi.
Tinjau Hasil Per Kolom: Lihat kolom mana yang berhasil diekstraksi dengan benar oleh setiap pembaca, ditandai dengan hijau, dan mana yang salah, ditandai dengan merah dan garis putus-putus.
Analisis Akurasi dan Biaya: Bandingkan proporsi kolom yang benar dan biaya per seribu halaman untuk berbagai pembaca dan jenis formulir.
Pahami Dampak Penyetelan: Amati bagaimana penyetelan secara signifikan meningkatkan akurasi model yang lebih kecil pada jenis formulir tertentu.
Evaluasi Biaya Penerapan: Gunakan kalkulator yang disediakan untuk menentukan kelayakan ekonomi menyewa GPU dibandingkan menggunakan API komersial berdasarkan volume Anda.
Akses Adaptor: Unduh adaptor yang telah disesuaikan untuk kwitansi, formulir pembelian iklan, dan formulir pajak dari Hugging Face.
Kasus Penggunaan Forms That Read Themselves
- Ekstraksi Data Formulir Otomatis
- Pemrosesan Dokumen Hemat Biaya
- Pemrosesan Data Di Tempat
- Benchmarking Model Visi AI
- Meningkatkan Akurasi OCR
- Pengembangan Model Kustom