Deskripsi
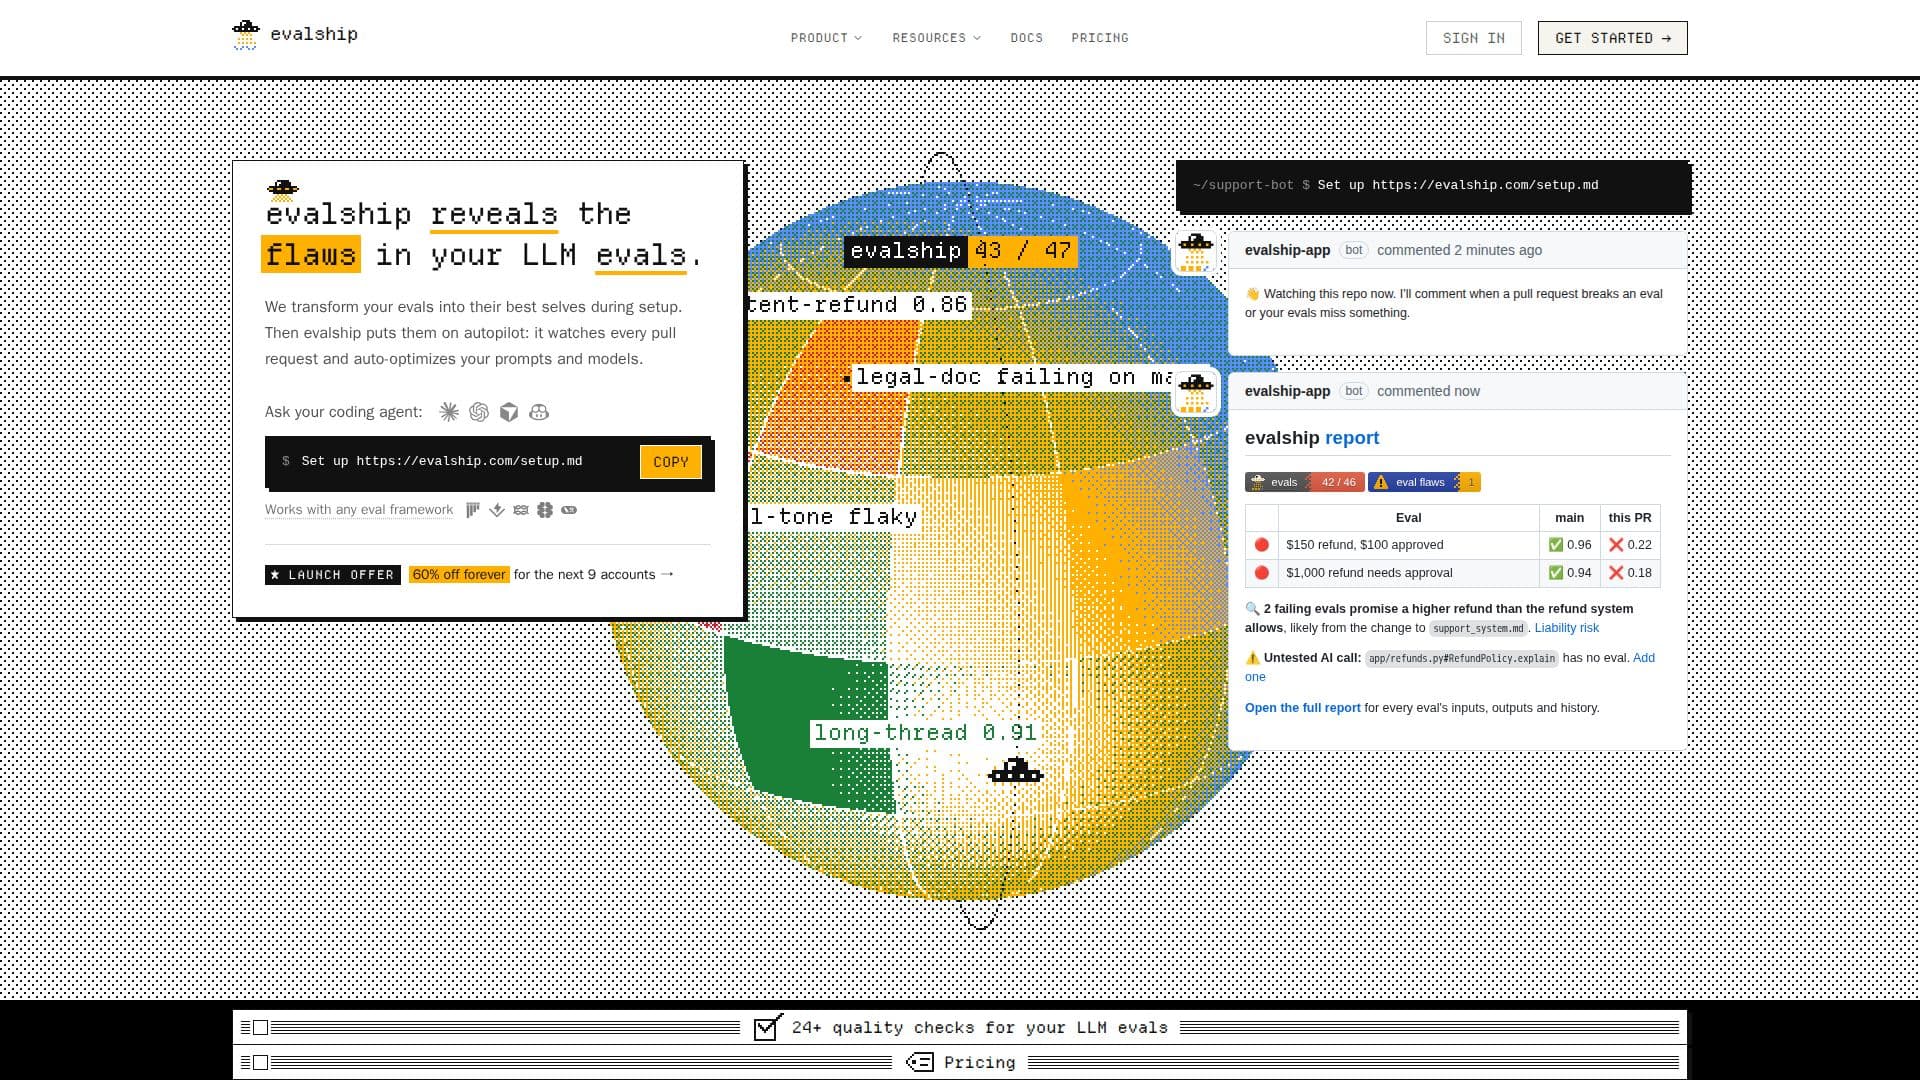
evalship menawarkan solusi kontrol kualitas yang komprehensif yang dirancang khusus untuk evaluasi Model Bahasa Besar (LLM). Ini terintegrasi langsung ke dalam alur kerja GitHub Anda, bertindak sebagai penjaga yang waspada untuk proses pengembangan LLM Anda. Tujuan utama evalship adalah untuk mengidentifikasi dan mengatasi cacat dalam pengaturan evaluasi Anda, memastikan bahwa LLM Anda berfungsi seperti yang diharapkan dan tidak memperkenalkan regresi.
Baca Selengkapnya
Setelah pengaturan, evalship secara menyeluruh meninjau evaluator, juri, dan prompt yang ada untuk menentukan kelemahan seperti evaluasi yang salah lulus atau aturan yang tidak memiliki cakupan pengujian yang tepat. Kemudian, ia memantau setiap permintaan tarik, memberikan umpan balik segera tentang apa yang rusak, mengapa itu rusak, dan kemungkinan penyebabnya. Ini termasuk menandai panggilan AI yang tidak diuji dan memisahkan regresi yang nyata dari hasil evaluasi yang tidak konsisten dengan menganalisis kinerja historis di cabang default Anda.
Platform ini bekerja dengan mulus dengan berbagai kerangka eval, termasuk yang menghasilkan JUnit XML, promptfoo JSON, atau evalship JSON, seperti pytest, Vitest, Jest, RSpec, Go, Java, PHPUnit, Rust, Langfuse, Braintrust, dan LangSmith. Ini tidak menjalankan evaluasi Anda secara langsung; sebaliknya, alur kerja GitHub Actions atau agen pengkodean Anda menjalankannya menggunakan kunci API Anda, dan evalship memproses hasilnya.
Selain mengidentifikasi masalah, evalship membantu mengoptimalkan prompt dan model Anda. Melalui agen pengkodean Anda, ia menguji berbagai perubahan di mesin Anda, seperti model yang lebih murah atau aturan yang lebih jelas, dan melaporkan perubahan mana yang memberikan perbaikan yang signifikan secara statistik. Ini memungkinkan tim untuk membuat keputusan berbasis data untuk meningkatkan kinerja model dan efisiensi biaya. evalship juga menyediakan laporan mingguan yang merangkum kinerja evaluasi dan menyoroti masalah kritis yang terdeteksi sebelum mencapai produksi.
Harga mencakup tingkat gratis untuk repositori publik dan satu repositori pribadi dengan satu pengguna, menawarkan 100 analisis PR dan 30 hari riwayat evaluasi. Rencana berbayar (Tim, Pro, Bisnis) menawarkan pengguna yang lebih banyak, repositori pribadi, analisis PR, dan riwayat evaluasi yang lebih lama, dengan opsi untuk penagihan bulanan atau tahunan. Penawaran peluncuran memberikan diskon signifikan untuk pengguna awal. evalship memastikan keamanan dengan tidak menyimpan kode sumber atau kunci API Anda, hanya memproses perbedaan dan hasil evaluasi.
- KategoriPeninjauan Kode & Pengujian AI
- Model HargaFreemium
- PenerapanCloud
- PlatformWeb
Fitur Inti evalship
Mengidentifikasi cacat dalam evaluasi LLM selama pengaturan
Memberikan komentar pada setiap permintaan tarik dengan rincian mendetail tentang kegagalan evaluasi
Mengoptimalkan prompt dan model secara otomatis berdasarkan data kinerja
Bekerja dengan kerangka eval yang ada (JUnit XML, promptfoo, evalship JSON)
Menyediakan lebih dari 24 pemeriksaan kualitas untuk evaluasi LLM
Memisahkan regresi dari evaluasi yang tidak konsisten menggunakan data historis
Mendeteksi panggilan AI yang tidak diuji dalam permintaan tarik
Memblokir penggabungan yang melanggar aturan evaluasi (dapat dikonfigurasi)
Membuka blokir permintaan tarik setelah masalah diperbaiki
Mengirim email laporan evaluasi mingguan yang merangkum kinerja dan masalah
Mendukung monorepos dan beberapa alur kerja evaluasi
Mengintegrasikan dengan Langfuse, Braintrust, dan LangSmith tanpa memerlukan perubahan
Menawarkan tinjauan gratis untuk evaluasi saat pengaturan
Memungkinkan agen pengkodean untuk memeriksa perubahan sebelum membuka permintaan tarik
Memastikan keamanan dengan tidak menyimpan kode sumber atau kunci API
Cara menggunakan evalship?
Set up: Hubungkan repositori GitHub Anda dan minta agen pengkodean Anda untuk mengatur evalship, yang meninjau evaluasi Anda dan membuat permintaan tarik pengaturan.
Monitor pull requests: evalship secara otomatis memantau setiap permintaan tarik, memberikan komentar tentang perubahan yang merusak evaluasi atau memperkenalkan panggilan AI yang tidak diuji.
Review reports: Akses laporan mendetail untuk setiap input, output, dan riwayat evaluasi untuk memahami apa yang rusak dan mengapa.
Optimize: Gunakan fitur optimasi evalship untuk menguji perubahan prompt dan model dengan agen pengkodean Anda, mengidentifikasi perbaikan yang lebih dari sekadar kebetulan.
Receive reports: Dapatkan laporan email mingguan yang merangkum kinerja evaluasi dan menyoroti masalah kritis yang terdeteksi sebelum penggabungan.
Kasus Penggunaan evalship
- Kontrol Kualitas Evaluasi LLM
- Tinjauan Permintaan Tarik Otomatis
- Optimasi Prompt dan Model
- Pencegahan Regresi
- Deteksi Panggilan AI yang Tidak Diuji
- Manajemen Evaluasi yang Tidak Konsisten
- Mitigasi Risiko Kepatuhan dan Tanggung Jawab
- Peningkatan Alur Kerja Pengembang