Deskripsi
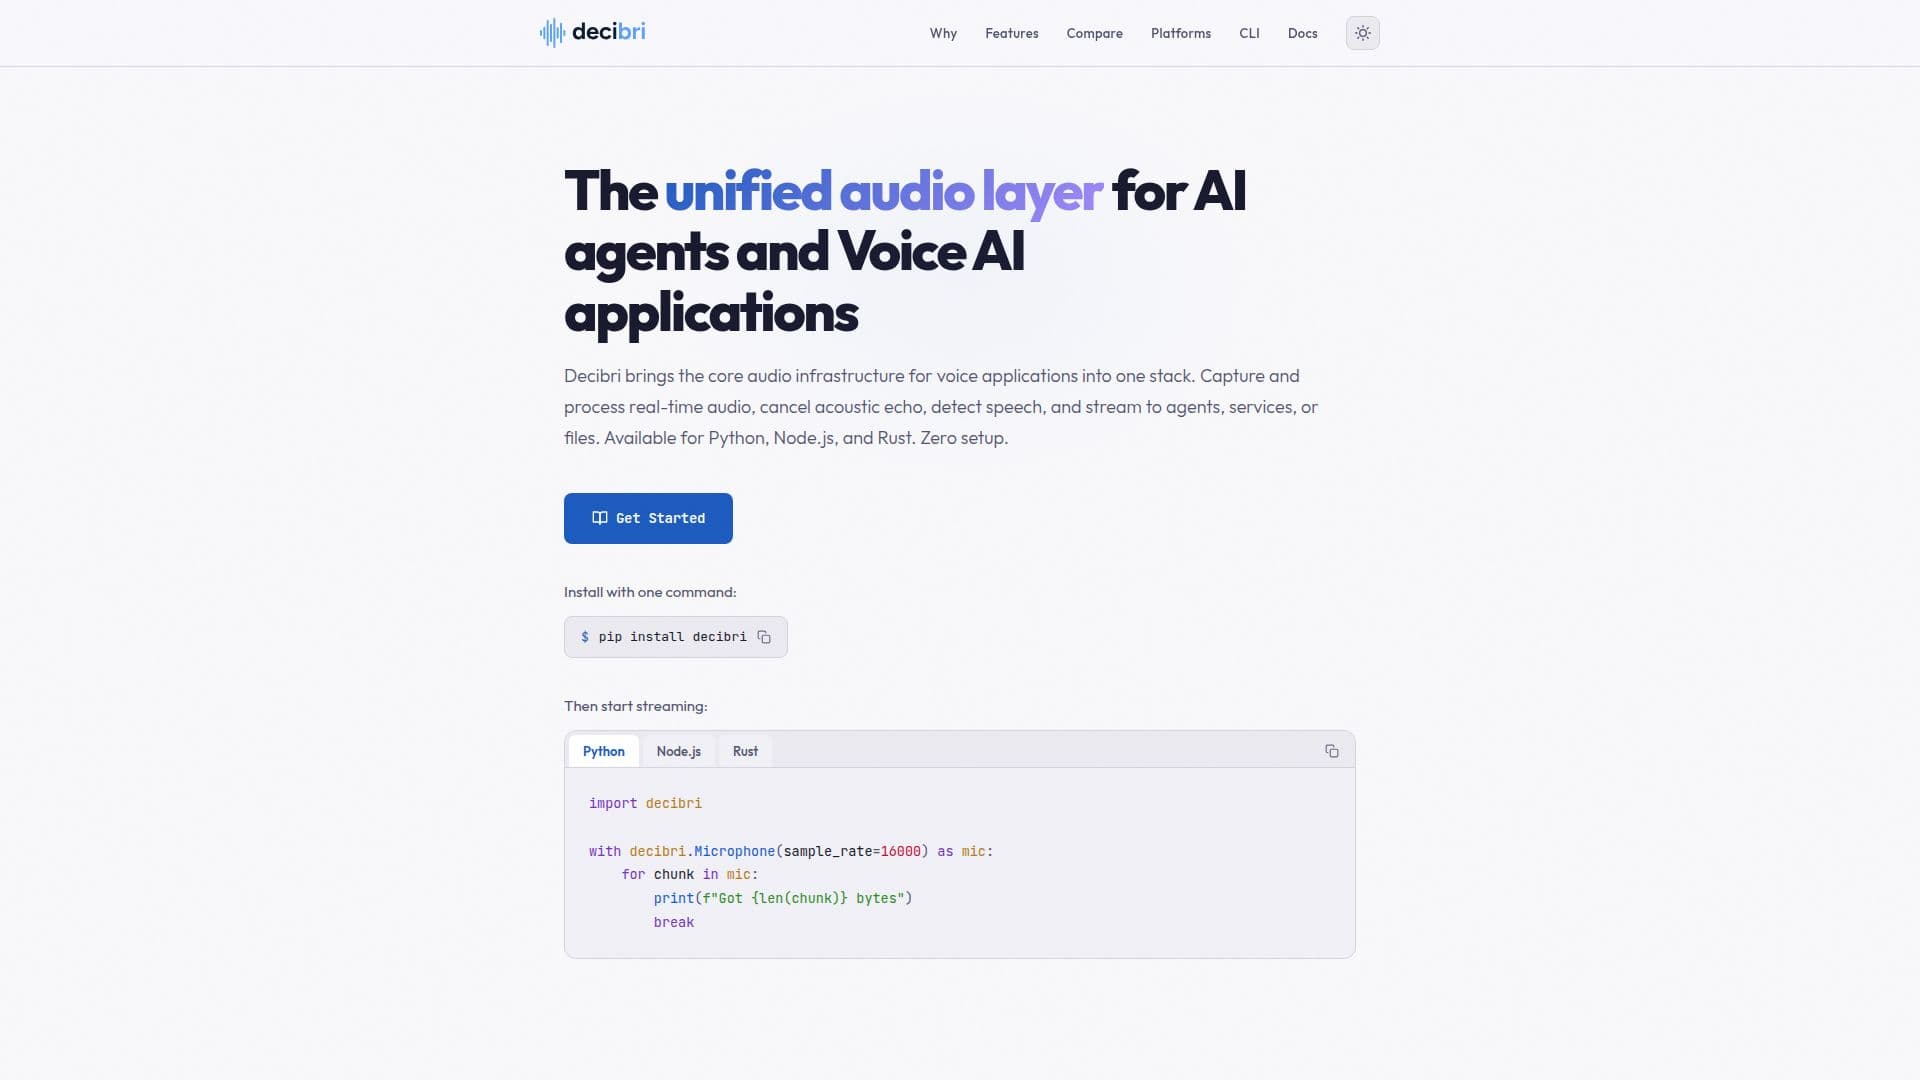
Decibri berfungsi sebagai lapisan audio terpadu yang dirancang khusus untuk agen AI dan aplikasi Voice AI. Ini menyediakan kemampuan audio waktu nyata yang penting, termasuk pengambilan mikrofon, keluaran speaker, dan deteksi aktivitas suara (VAD). Platform ini mendukung beberapa bahasa pemrograman, yaitu Python, Node.js, dan Rust, menjadikannya serbaguna untuk berbagai lingkungan pengembangan.
Baca Selengkapnya
Salah satu keuntungan utama Decibri adalah kemudahan instalasi dan kompatibilitas lintas platform. Ini menawarkan biner yang sudah dibangun untuk Python dan Node.js di semua platform yang didukung (Windows, macOS, Linux), menghilangkan kebutuhan untuk kompilasi atau alat pembangunan yang kompleks. Pendekatan "zero setup" ini memastikan pengembang dapat dengan cepat mengintegrasikan fungsionalitas audio waktu nyata ke dalam proyek mereka. Inti Rust, yang mendukung paket Python, Node.js, dan Rust, dikompilasi menjadi kode asli, memastikan audio latensi rendah yang dapat diprediksi langsung dari lapisan audio sistem operasi.
Decibri menangkap audio langsung dari lapisan audio OS, menyediakan potongan audio 100ms secara default dalam format PCM integer bertanda 16-bit, yang merupakan standar yang diharapkan oleh sebagian besar mesin suara dan kata bangun seperti Vosk, sherpa-onnx, dan whisper.cpp. Format float 32-bit juga tersedia. Ini mendukung idiom aliran asli untuk setiap bahasa, memungkinkan pengembang untuk mengalirkan audio ke file, WebSockets, atau agen suara dengan efisien. Platform ini juga menyertakan model Silero VAD v6.2 yang terbundel untuk deteksi suara yang akurat di lingkungan bising, berjalan secara lokal melalui ONNX Runtime tanpa memerlukan API cloud.
Selain pengambilan dan pemutaran dasar, Decibri menawarkan fitur pemrosesan audio lanjutan melalui Audio Capture Engine (ACE), termasuk penghapusan DC, pengurangan kebisingan, penyaringan high-pass, kontrol penguatan otomatis, dan pembatasan. Ini juga menyediakan Pembatalan Echo Akustik (AEC) untuk menghilangkan suara speaker dari pengambilan mikrofon. Untuk pemrosesan offline, Audio File Processor (AFP) memungkinkan pengkondisian sampel yang direkam atau dalam memori. Decibri terintegrasi dengan banyak penyedia speech-to-text (STT), baik berbasis cloud (AssemblyAI, AWS Transcribe, Azure AI Speech, Deepgram, Google Cloud Speech-to-Text, Mistral Voxtral, OpenAI Realtime API) maupun lokal (Sherpa-ONNX, Whisper.cpp), serta text-to-speech (TTS) lokal dengan model Kokoro dan pemantauan kata kunci (KWS) dengan Sherpa-ONNX.
Decibri dibangun untuk sistem waktu nyata, memastikan I/O audio latensi rendah tanpa alat audio eksternal atau penanganan spesifik platform. Ini mendukung operasi asinkron di Python dengan `asyncio` dan bekerja di lingkungan Node.js dan browser dari satu paket. Alat `decibri-cli` menyediakan kemampuan baris perintah untuk pengambilan audio, pemutaran, dan enumerasi perangkat, lebih lanjut memperluas utilitasnya untuk skrip dan pipeline CI/CD.
- KategoriPembuat Agen AI
- Model HargaGratis
- PenerapanLokal
- PlatformWindows, macOS, Linux, Browser
Fitur Inti Decibri
Pengambilan Mikrofon Waktu Nyata
Keluaran dan Pemutaran Speaker
Deteksi Aktivitas Suara (VAD)
Dukungan Lintas Platform (Python, Node.js, Rust)
Biner yang Sudah Dibangun untuk Zero Setup
Akses Langsung ke Lapisan Audio OS
Keluaran Audio PCM 16-bit dan Float 32-bit
Dukungan API Asinkron (asyncio untuk Python)
Kompatibilitas Browser (paket Node.js)
Mesin Pengambilan Audio (penghapusan DC, pengurangan kebisingan, AGC)
Pembatalan Echo Akustik (AEC)
Deteksi Suara ML Lokal (Silero VAD)
Integrasi dengan Layanan STT Cloud
Integrasi dengan Model STT/TTS/KWS Lokal
Antarmuka Baris Perintah (decibri-cli)
Cara menggunakan Decibri?
Instal Decibri: Gunakan `pip install decibri` untuk Python atau `npm install decibri` untuk Node.js untuk mendapatkan biner yang sudah dibangun.
Buka Mikrofon: Gunakan `decibri.Microphone.open()` di Python atau `new Microphone()` di Node.js untuk mulai menangkap audio.
Alirkan Audio: Baca potongan audio menggunakan iterator Python, aliran Readable Node.js, atau saluran Rust.
Proses Audio: Terapkan pengkondisian bawaan seperti penghapusan DC, pengurangan kebisingan, atau pembatalan echo akustik.
Deteksi Suara: Aktifkan model Silero VAD yang terbundel untuk deteksi aktivitas suara lokal.
Integrasi dengan Layanan AI: Alirkan audio PCM mentah ke layanan speech-to-text, agen suara, atau model AI lainnya.
Putar Audio: Gunakan API Speaker Decibri untuk memutar audio melalui speaker sistem.
Rekam ke File: Gunakan `record_to_file()` untuk perekaman audio sederhana atau kontrol streaming penuh untuk kasus penggunaan yang lebih kompleks.
Kasus Penggunaan Decibri
- Agen Suara AI Waktu Nyata
- Integrasi Speech-to-Text
- Deteksi Aktivitas Suara
- Perekaman Audio untuk ASR
- Aplikasi Audio Lintas Platform
- Backend Suara Sisi Server
- Pemantauan Kata Kunci
- Komunikasi Audio Duplex Penuh