Deskripsi
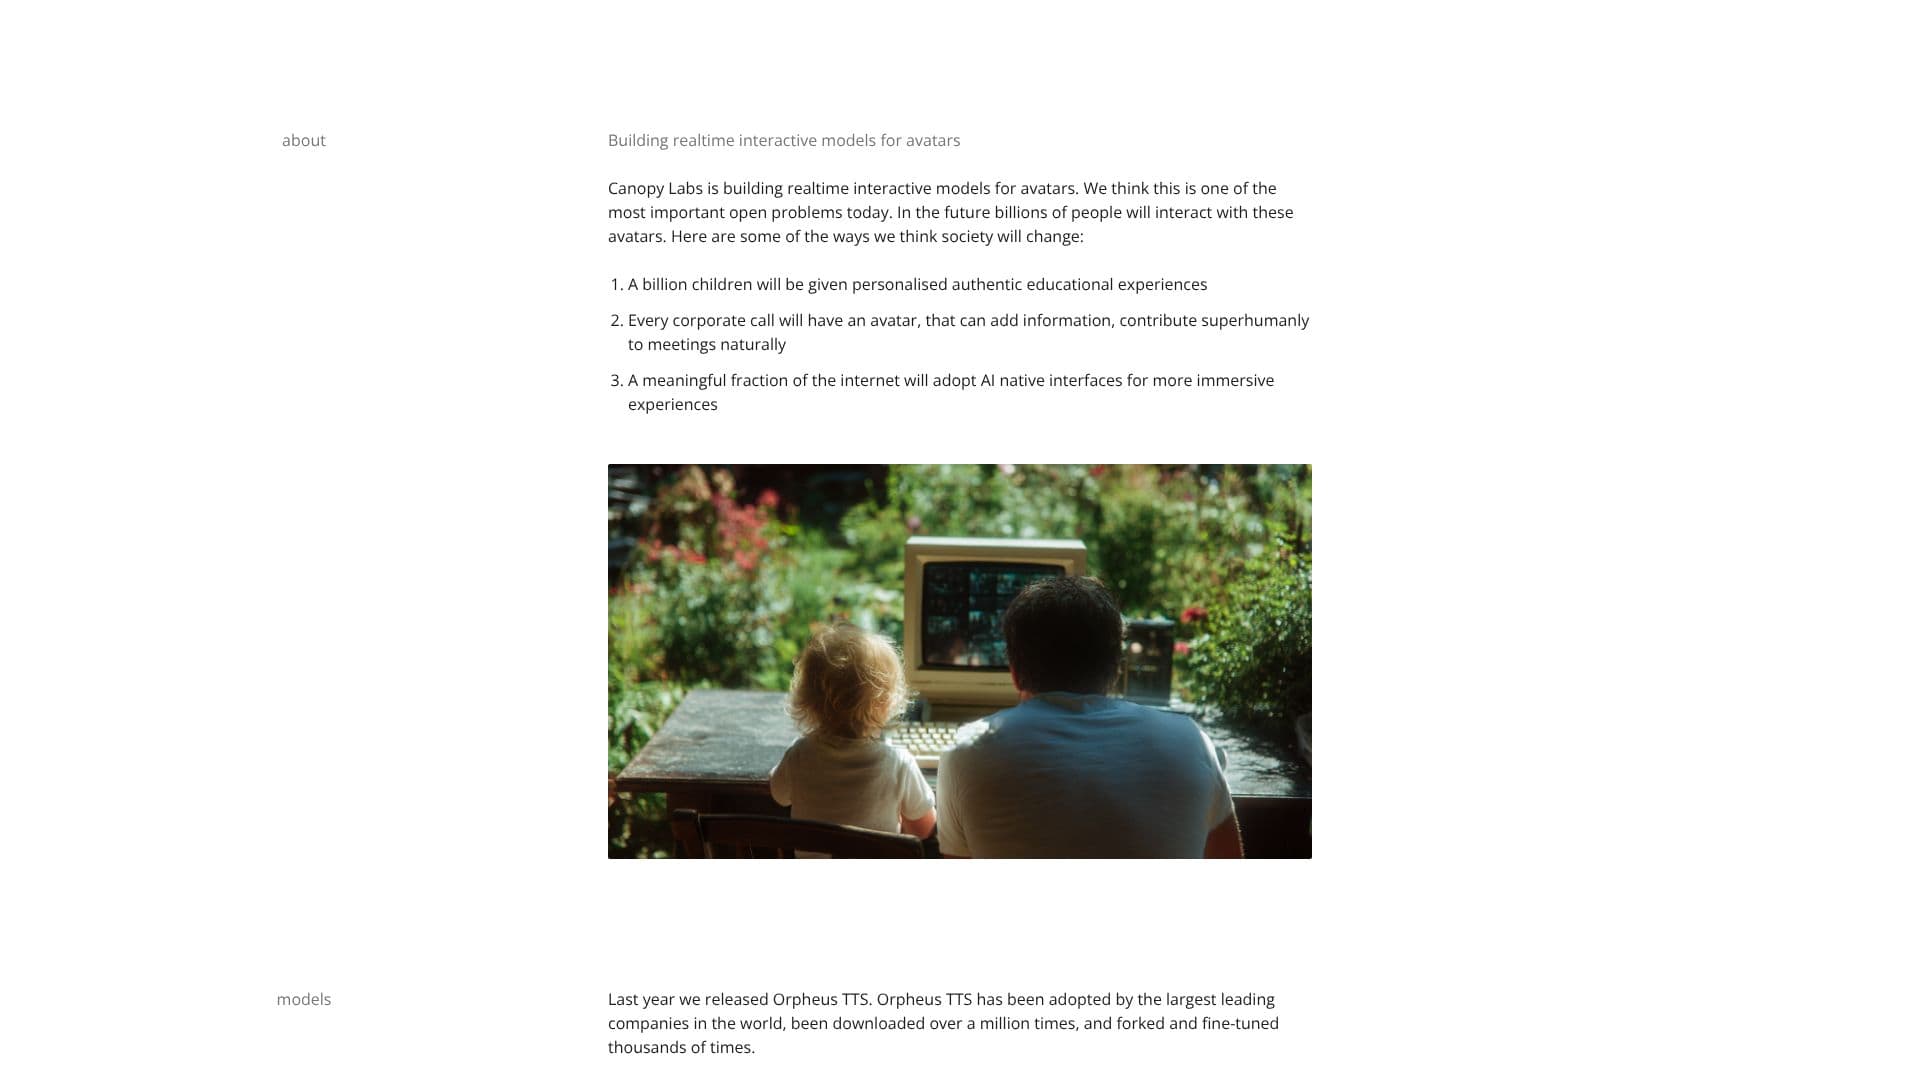
Canopy Labs menggambarkan pekerjaannya sebagai membangun model interaktif waktu nyata untuk avatar, dengan tujuan yang dinyatakan untuk mengembangkan manusia digital yang tidak dapat dibedakan dari yang nyata. Perusahaan ini menganggap ini sebagai masalah riset terbuka yang diharapkan dapat mengubah cara orang berinteraksi dengan perangkat lunak, mencantumkan skenario seperti pengalaman pendidikan yang dipersonalisasi dan avatar yang berpartisipasi dalam pertemuan perusahaan sebagai arah yang diharapkan dapat diaktifkan oleh teknologi ini; ini adalah visi yang dinyatakan oleh perusahaan itu sendiri daripada fitur yang diluncurkan.
Baca Selengkapnya
Canopy Labs sebelumnya merilis Orpheus TTS, yang dikatakan telah diadopsi oleh perusahaan, diunduh lebih dari satu juta kali, dan di-fork atau di-fine-tune ribuan kali (angka dari perusahaan itu sendiri). Sejak saat itu, Canopy Labs menyatakan telah mengumpulkan $17 juta dan sedang mengembangkan model suara dan avatar lebih lanjut yang belum dipublikasikan.
Produk yang tersedia saat ini adalah Orpheus v1, model teks-ke-suara yang ditawarkan dalam dua tingkatan, Base dan Flash. Ini secara native multibahasa, mendukung bahasa Inggris, Hindi, Mandarin, Jerman, Jepang, Prancis, Italia, Portugis, Rusia, Spanyol, dan Korea, serta mendukung arahan panggung inline dalam skrip, seperti menandai sebuah kalimat sebagai terbata-bata atau emosional, untuk membentuk cara penyampaiannya. Canopy Labs menyatakan model ini memiliki latensi ultra-rendah, dengan waktu respons p99 dalam 30 milidetik dari baseline-nya. Sebuah perpustakaan suara dilengkapi dengan lebih dari 30 suara preset, dan kloning suara profesional atau satu kali dapat membangun suara merek kustom dari beberapa jam audio.
Untuk pelanggan perusahaan, Orpheus dapat diterapkan di tempat atau di cloud pribadi dengan dukungan prioritas dan SLA, bukan hanya melalui API yang dihosting. Di situsnya, Canopy Labs mendemonstrasikan model tersebut di berbagai gaya penyampaian preset, termasuk suara dukungan pelanggan, nada reflektif diri, pembacaan teatrikal, narasi pembelajaran bahasa, dan suara pelatih meditasi, untuk menunjukkan model yang sama menangani berbagai register. Canopy Labs tidak menerbitkan harga publik untuk Orpheus di situsnya.
- KategoriGenerator Avatar AI
- PenerapanCloud
- PlatformWeb
Fitur Inti Canopy Labs
Model teks-ke-suara (Orpheus v1) tersedia dalam tingkatan Base dan Flash
Secara native multibahasa di sebelas bahasa termasuk Inggris, Hindi, dan Mandarin
Mendukung arahan panggung inline untuk mengontrol penyampaian emosional dari sebuah kalimat
Menawarkan kloning suara profesional dan satu kali dari beberapa jam audio
Menyediakan perpustakaan lebih dari 30 suara preset
Mengklaim latensi ultra-rendah, dengan p99 dalam 30 milidetik dari baseline
Mendukung penerapan perusahaan di tempat atau cloud pribadi dengan dukungan SLA
Meneliti model avatar interaktif waktu nyata di luar produk suara yang diluncurkan
Cara menggunakan Canopy Labs?
Pilih tingkatan model: Pilih Orpheus v1 Base atau Flash tergantung pada kebutuhan latensi dan kualitas.
Pilih atau kloning suara: Gunakan suara dari perpustakaan atau kloning suara kustom dari audio contoh.
Tulis skrip: Tambahkan arahan panggung untuk membentuk penyampaian, seperti nada atau emosi.
Pilih penerapan: Gunakan model yang dihosting atau atur penerapan di tempat atau cloud pribadi.
Integrasikan output: Masukkan suara yang dihasilkan ke dalam produk, avatar, atau alur kerja dukungan.
Kasus Penggunaan Canopy Labs
- Prototipe produk suara
- Suara dukungan pelanggan
- Narasi pembelajaran bahasa
- Penerapan perusahaan di tempat