Deskripsi
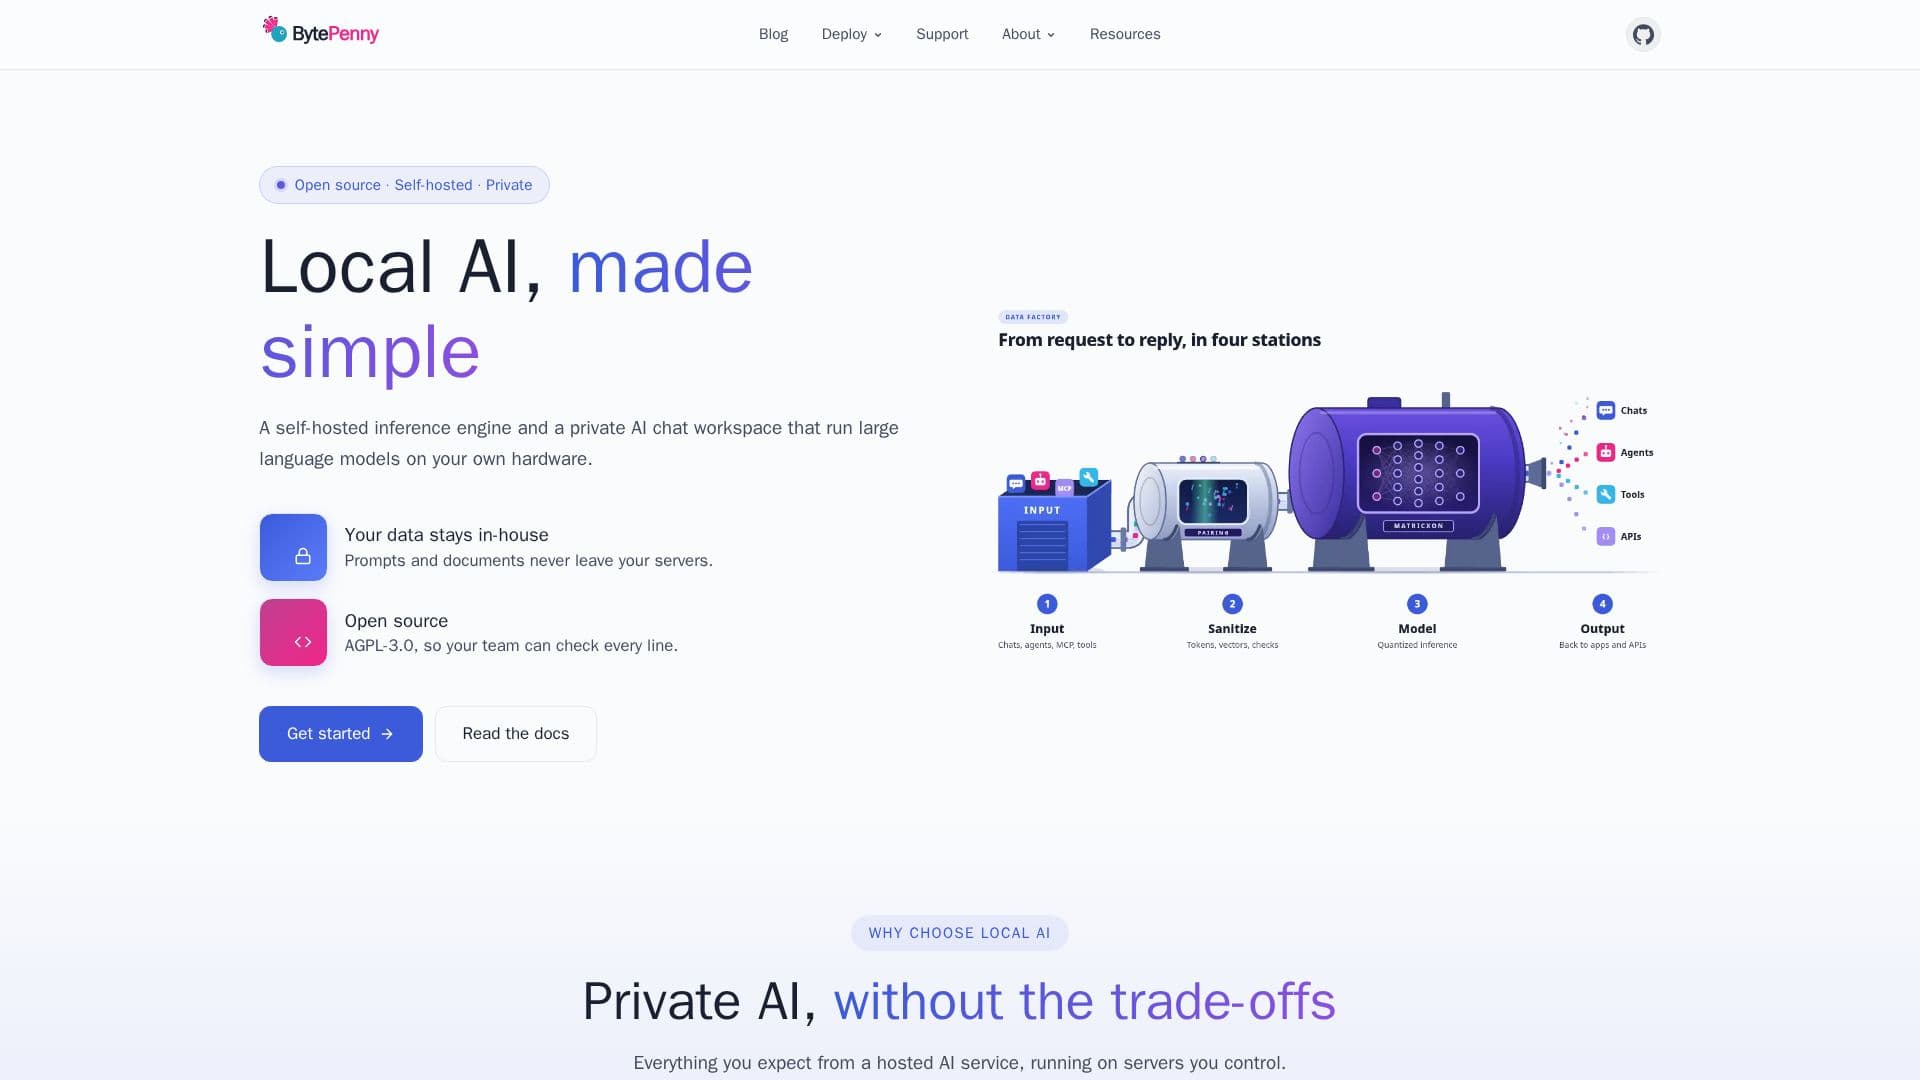
BytePenny menyediakan rangkaian lengkap alat AI sumber terbuka yang dihosting sendiri yang dirancang untuk privasi dan kontrol. Penawaran inti mencakup Matricxon, mesin inferensi GGUF sumber terbuka, dan pAIring, ruang kerja obrolan AI pribadi yang disesuaikan untuk tim. Produk-produk ini memungkinkan organisasi untuk menjalankan model bahasa besar langsung di perangkat keras mereka sendiri, memastikan bahwa prompt, dokumen, dan data obrolan tidak pernah meninggalkan server mereka.
Baca Selengkapnya
Platform ini menekankan privasi data, beroperasi sepenuhnya offline untuk menjaga semua informasi sensitif di dalam rumah. Ini mendukung berbagai model GGUF dari sumber seperti Hugging Face, llama.cpp, atau mesin Matricxon, dan dapat terintegrasi dengan server alat MCP. BytePenny dibangun dengan filosofi sumber terbuka, menggunakan lisensi AGPL-3.0, yang memungkinkan tim untuk memeriksa dan memodifikasi setiap baris kode, mendorong transparansi dan kepercayaan.
Matricxon, mesin inferensi, adalah runtime LLM yang ringan dan dapat dibaca yang ditulis dalam Python dan PyTorch, dengan kernel C bawaan untuk kinerja yang dipercepat. Ini mendukung model GGUF untuk tugas seperti obrolan, generasi teks, embedding, peringkat ulang, model bahasa-visual, dan peramalan deret waktu, menyajikannya melalui API HTTP. Ini berjalan efisien di CPU dan menawarkan dukungan BETA untuk GPU NVIDIA, dengan rencana untuk memperluas ke GPU AMD dan Apple Silicon. Matricxon juga mendukung mode cluster untuk model bersama dan cache obrolan di beberapa node, dikelola dari UI pAIring.
pAIring, ruang kerja obrolan AI pribadi, dirancang untuk kolaborasi tim, menawarkan fitur seperti akses berbasis peran, saluran bersama, dan basis pengetahuan terintegrasi. Ini menyediakan cache obrolan terenkripsi dan memastikan bahwa prompt tidak pernah digunakan untuk pelatihan model. Sistem ini dapat diskalakan, memungkinkan pengguna untuk memulai dengan satu server dan memperluas dengan menambahkan node dengan kemampuan penyeimbangan beban dan failover. Untuk skenario yang memerlukan lebih banyak daya, pAIring dapat terhubung ke berbagai penyedia cloud seperti Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq, dan lainnya, menawarkan fleksibilitas untuk mencampur mesin lokal dan cloud.
BytePenny menghilangkan penagihan per-token, memungkinkan organisasi untuk memanfaatkan perangkat keras yang ada dan mempertahankan biaya tetap seiring pertumbuhan penggunaan. Seluruh tumpukan dirancang untuk terbuka, dari kode AGPL-3.0 hingga model berat terbuka, menjadikannya ideal untuk jaringan pribadi dan tertutup. Keamanan adalah perhatian utama, dengan fitur seperti kata sandi yang di-hash bcrypt, rahasia yang disimpan terenkripsi, cache obrolan terenkripsi AES-256-GCM, dan pemeriksaan peran sisi server untuk tindakan admin. Baik Matricxon maupun pAIring telah mendapatkan lencana 'lulus' Praktik Terbaik OpenSSF, menunjukkan komitmen terhadap praktik pengembangan yang aman.
- KategoriMLOps & Penerapan Model
- Model HargaOpen Source (AGPL-3.0), No Per-Token Bills
- PenerapanSelf-Hosted, On-Premise, Cloud (Hybrid)
- PlatformWindows, Linux
Fitur Inti BytePenny
Mesin inferensi AI yang dihosting sendiri (Matricxon)
Ruang kerja obrolan AI pribadi untuk tim (pAIring)
Menjalankan model bahasa besar di perangkat keras Anda sendiri
Data tetap di dalam; prompt dan dokumen tidak pernah meninggalkan server
Sumber terbuka dengan lisensi AGPL-3.0
Bekerja sepenuhnya offline
Cache obrolan terenkripsi dengan AES-256-GCM
Akses berbasis peran untuk tim
Prompt tidak pernah digunakan untuk pelatihan model
Mendukung model GGUF dari Hugging Face, llama.cpp, Matricxon
Kernel terkuantisasi untuk dukungan CPU dan GPU NVIDIA
Tanpa penagihan per-token; biaya tetap seiring pertumbuhan penggunaan
Penerapan yang dapat diskalakan: node tunggal, cluster bersama, atau server terpisah
Terhubung ke lebih dari 12 penyedia cloud (Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq, dll.)
Ditulis dari awal dalam Python untuk keterbacaan dan kustomisasi
Cara menggunakan BytePenny?
Terapkan BytePenny: Instal Matricxon dan pAIring di server atau infrastruktur cloud Anda sendiri.
Konfigurasi Mesin Inferensi: Siapkan Matricxon sebagai mesin inferensi lokal atau hubungkan pAIring ke penyedia cloud pilihan.
Tambahkan Model: Integrasikan model GGUF dari Hugging Face atau sumber lain, atau gunakan model yang dihosting di cloud melalui konektor.
Kelola Pengguna dan Tim: Konfigurasi akses berbasis peran, buat saluran bersama, dan bangun basis pengetahuan dalam pAIring.
Mulai Obrolan: Mulai percakapan AI pribadi dan manfaatkan basis pengetahuan untuk kolaborasi tim.
Pantau dan Skalakan: Amati status sistem, kelola node cluster, dan perluas perangkat keras seiring pertumbuhan penggunaan tanpa biaya per-token.
Kasus Penggunaan BytePenny
- Obrolan Tim Pribadi
- Inferensi LLM Lokal
- Analisis Dokumen Aman
- Operasi AI yang Terkontrol Biaya
- Alur Kerja AI Offline
- Penerapan Model Kustom
- Infrastruktur AI yang Dapat Diskalakan
- Pengembangan AI Sumber Terbuka