Deskripsi
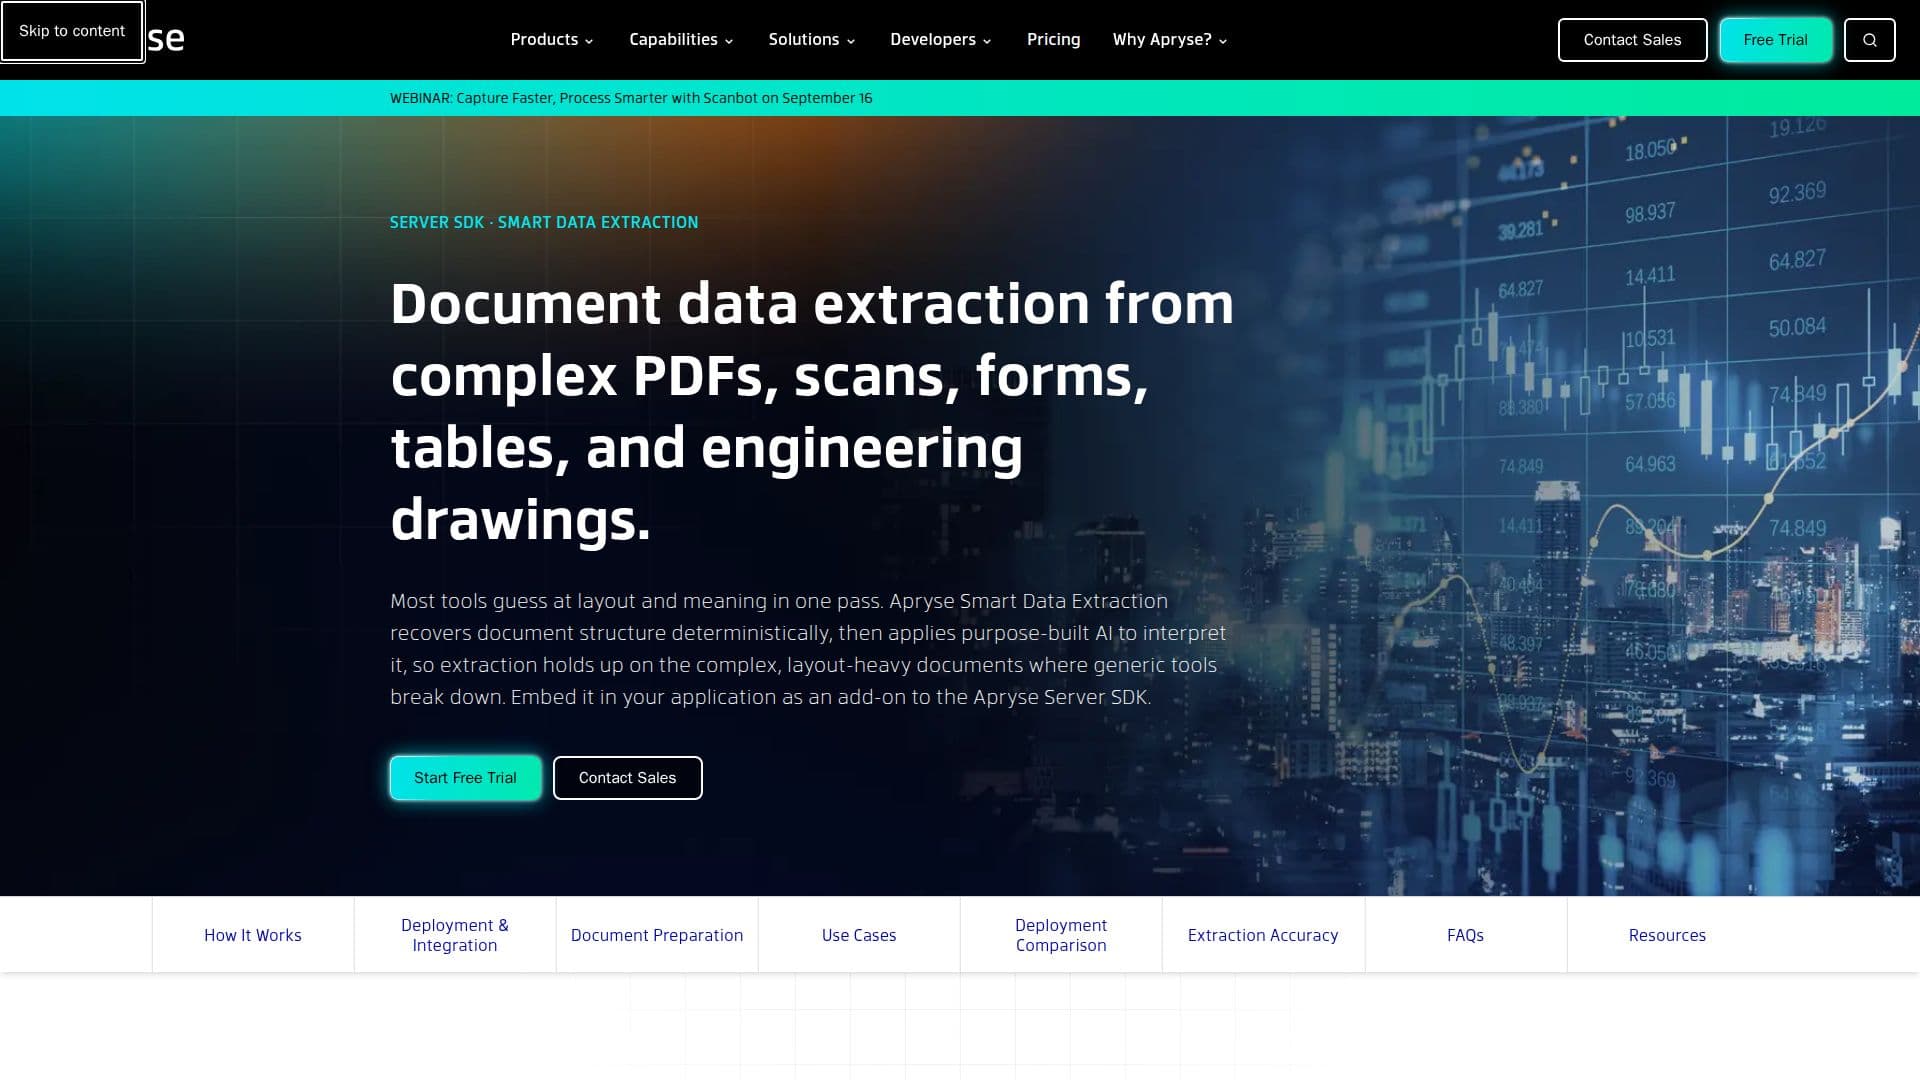
Apryse PDF Data Extraction adalah solusi yang kuat untuk mengubah PDF tidak terstruktur menjadi data terstruktur, cocok untuk analisis, otomatisasi, dan pelatihan model. SDK yang dihosting sendiri ini dirancang untuk mengekstrak tabel, formulir, dan kode batang dengan presisi dan kecepatan, memastikan total kedaulatan data. Berbeda dengan API berbasis cloud, ini menghilangkan risiko residensi data dan menghindari biaya 'per-halaman'. Ekstraksi Data Cerdas Apryse dapat mengklasifikasikan dokumen secara otomatis, memberikan kategori dan skor kepercayaan di tingkat halaman. Ini mengidentifikasi pasangan kunci-nilai tanpa memerlukan koordinat tetap, menjadikannya serbaguna untuk berbagai tata letak dokumen.
SDK ini dapat mengekstrak tabel dari PDF yang kompleks, memulihkan baris, kolom, dan struktur dari tabel bersarang dan halaman multi-kolom. Deteksi bidang formulir mengidentifikasi dan memberi label pada bidang seperti kotak teks dan bidang tanda tangan, sementara OCR dan ICR mengubah dokumen yang dipindai dan tulisan tangan menjadi teks yang dapat dibaca mesin. Kemampuan ini sangat penting untuk dokumen dengan kualitas gambar dan kompleksitas tata letak yang bervariasi.
Solusi Apryse berjalan secara offline dan di tempat, mendukung Windows dan Linux pada x64, dengan pengikatan untuk berbagai bahasa pemrograman termasuk .NET, Java, Python, dan lainnya. Ini menawarkan output JSON terstruktur dengan skor kepercayaan, menjadikannya kompatibel dengan pipeline LLM untuk pemrosesan data lebih lanjut. SDK ini merupakan alternatif untuk AI dokumen cloud, memberikan kontrol atas penyebaran dan integrasi dalam infrastruktur yang dikendalikan oleh pelanggan.
Harga untuk Ekstraksi Data Cerdas didasarkan pada lisensi paket daripada pengukuran per halaman, menawarkan model komersial yang dapat diprediksi. Ini menjadikannya cocok untuk pemrosesan volume tinggi di industri seperti layanan keuangan, asuransi, hukum, kesehatan, dan pemerintah. Solusi Apryse sangat ideal untuk tim yang membutuhkan ekstraksi dokumen yang dapat diandalkan yang terintegrasi dalam aplikasi mereka, terutama saat menangani informasi sensitif atau format dokumen yang kompleks.
Fitur Inti Apryse PDF Data Extraction
Klasifikasi dokumen dengan skor kepercayaan
Ekstraksi pasangan kunci-nilai tanpa koordinat tetap
Ekstraksi tabel dari tata letak kompleks
Deteksi bidang formulir untuk bidang teks dan tanda tangan
OCR dan ICR untuk dokumen yang dipindai dan tulisan tangan
Penyebaran offline dan di tempat
Output JSON terstruktur dengan skor kepercayaan
Integrasi dengan pipeline LLM
Cara menggunakan Apryse PDF Data Extraction?
Konfigurasi: Siapkan SDK di aplikasi Anda
Gunakan: Ekstrak data dari PDF menggunakan SDK
Optimalkan: Sesuaikan pengaturan untuk jenis dokumen tertentu
Kasus Penggunaan Apryse PDF Data Extraction
- Layanan keuangan
- Asuransi
- Hukum
- Kesehatan
- Pemerintah