Description
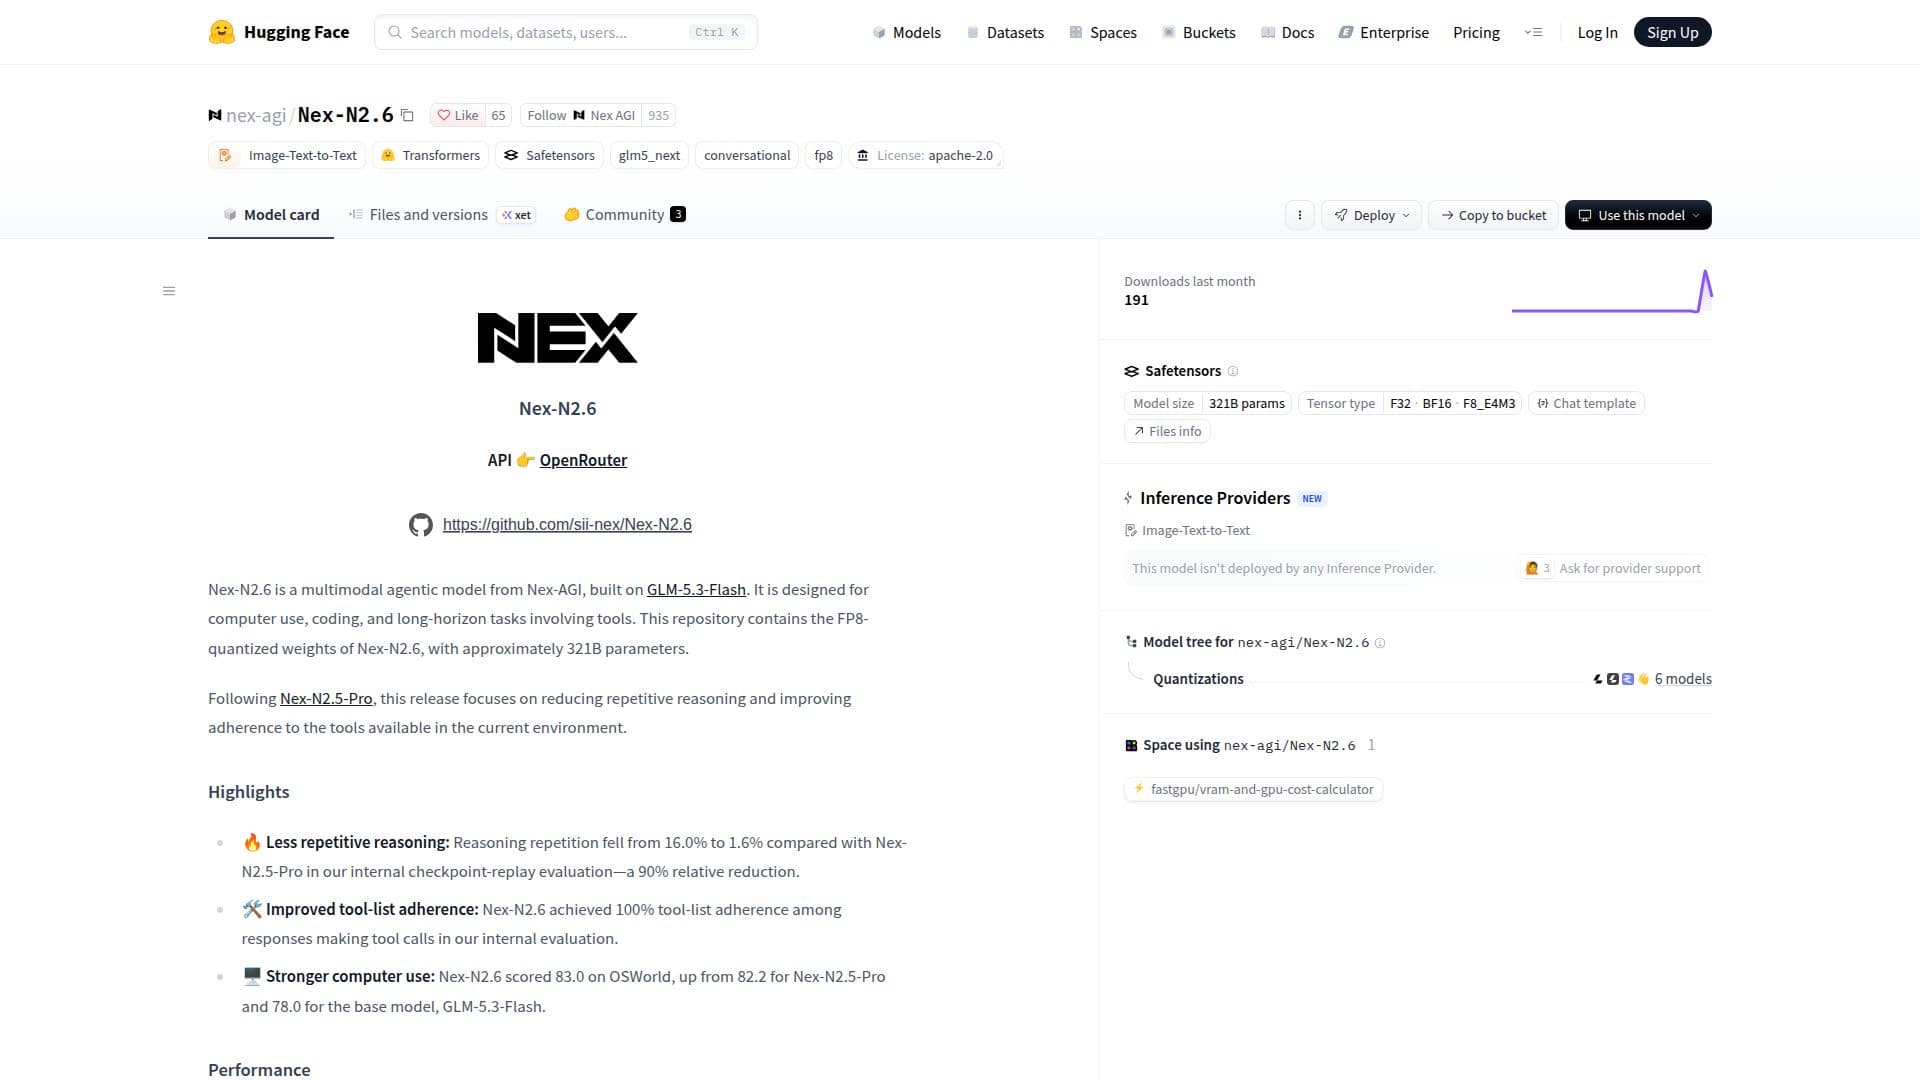
Nex-N2.6 est un modèle agentique multimodal avancé développé par Nex-AGI, tirant parti de l'architecture fondamentale GLM-5.3-Flash. Ce modèle est spécifiquement conçu pour exceller dans des environnements computationnels exigeants, y compris des tâches de codage complexes et des opérations à long terme nécessitant une intégration et une utilisation sophistiquées des outils. La version actuelle se concentre sur la fourniture de performances améliorées en abordant des domaines clés tels que l'efficacité du raisonnement et l'adhérence aux outils.
Lire la suite
Un point fort de Nex-N2.6 est sa réduction remarquable du raisonnement répétitif. Les évaluations internes montrent une diminution dramatique de la répétition du raisonnement, passant de 16,0 % dans son prédécesseur, Nex-N2.5-Pro, à seulement 1,6 %. Cela représente une réduction relative de 90 %, indiquant une amélioration substantielle de la capacité du modèle à traiter l'information plus efficacement et à éviter les processus de pensée redondants. De plus, le modèle démontre une adhérence parfaite à la liste des outils, atteignant 100 % dans les évaluations internes pour les réponses impliquant des appels d'outils. Cela garantit que Nex-N2.6 utilise systématiquement uniquement les outils déclarés dans une demande, conduisant à des résultats plus fiables et prévisibles.
En termes d'application pratique, Nex-N2.6 présente des capacités renforcées en utilisation informatique. Il a obtenu un score de 83,0 sur le benchmark OSWorld, surpassant Nex-N2.5-Pro (82,2) et le modèle de base GLM-5.3-Flash (78,0). Des gains de performance similaires sont observés dans d'autres benchmarks, tels que Terminal-Bench 2.1, où Nex-N2.6 a obtenu 84,1, et AutomationBench, où il a atteint 45,7. Ces résultats, rapportés par l'équipe de Nex-AGI, soulignent la performance robuste du modèle à travers diverses tâches computationnelles.
Pour le déploiement, Nex-N2.6 fournit des poids quantifiés en FP8, le rendant adapté aux temps d'inférence qui prennent en charge GLM-5.3-Flash. Les utilisateurs peuvent auto-héberger le modèle en suivant le guide de déploiement officiel de SGLang, garantissant une configuration compatible avec FP8. Le modèle de chat inclus prend en charge différents niveaux d'effort de raisonnement (faible, élevé, maximum) et permet des entrées d'image via des temps d'exécution pris en charge. Pour les opérations basées sur des outils, les utilisateurs doivent fournir les outils disponibles avec chaque demande, le cadre client ou agent étant responsable de l'exécution des appels d'outils et du retour des résultats. La communauté Nex offre une plateforme pour des retours d'expérience, des discussions sur les flux de travail et des connexions entre développeurs.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementAuto-hébergé
- PlateformesWeb
Points forts de Nex-N2.6
Modèle agentique multimodal
Construit sur l'architecture GLM-5.3-Flash
Conçu pour une utilisation informatique et le codage
Optimisé pour des tâches à long terme impliquant des outils
Poids quantifiés en FP8 disponibles
321 milliards de paramètres
Réduction relative de 90 % de la répétition du raisonnement
Adhérence à 100 % à la liste des outils dans les appels d'outils
Performance élevée sur le benchmark OSWorld (score de 83,0)
Scores élevés sur Terminal-Bench 2.1 (84,1) et AutomationBench (45,7)
Prend en charge les valeurs d'effort de raisonnement : faible, élevé, maximum
Compatible avec des blocs de contenu d'image pour les entrées d'image
Intégration de l'API OpenRouter
Soutien communautaire pour les retours d'expérience et les flux de travail
Premiers pas avec Nex-N2.6
Accéder à la page du modèle : Naviguez vers la page du modèle Nex-N2.6 sur Hugging Face.
Télécharger les poids : Téléchargez les poids quantifiés en FP8 de Nex-N2.6.
Configurer le temps d'exécution : Utilisez un temps d'inférence avec le support de GLM-5.3-Flash, ou auto-hébergez en utilisant SGLang avec une configuration compatible FP8.
Définir le chemin du modèle : Remplacez le chemin du modèle par le répertoire Nex-N2.6 téléchargé et définissez `--served-model-name Nex-N2.6`.
Assurer le Tokenizer/Processor : Conservez le tokenizer, le processeur et le modèle de chat fournis avec les poids.
Envoyer des invites : Une fois que le serveur compatible OpenAI écoute, envoyez des invites, en spécifiant `reasoning_effort` (faible, élevé, maximum) selon les besoins.
Fournir des outils : Pour l'utilisation des outils, fournissez les outils disponibles avec chaque demande ; le cadre client ou agent exécutera les appels et retournera les résultats.
Utiliser des entrées d'image : Pour les entrées d'image, utilisez des blocs de contenu d'image pris en charge par votre temps d'exécution.
Cas d'utilisation de Nex-N2.6
- Tâches de codage complexes
- Automatisation à long terme
- Interaction avec les systèmes informatiques
- Traitement de données multimodales
- Développement de flux de travail agentiques
- Évaluation des performances
- Réduction du raisonnement répétitif