Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

Mage-VL

LLM#20Modèles d'IA et LLMOpen source · Web

Mage-VL est un modèle de fondation multimodal natif codec et de streaming proactif conçu pour une compréhension efficace des images et des vidéos. Il utilise un encodeur visuel unique et un décodeur causal pour améliorer la perception du streaming en temps réel tout en réduisant les exigences computationnelles.

Visiter l'URL
Partager
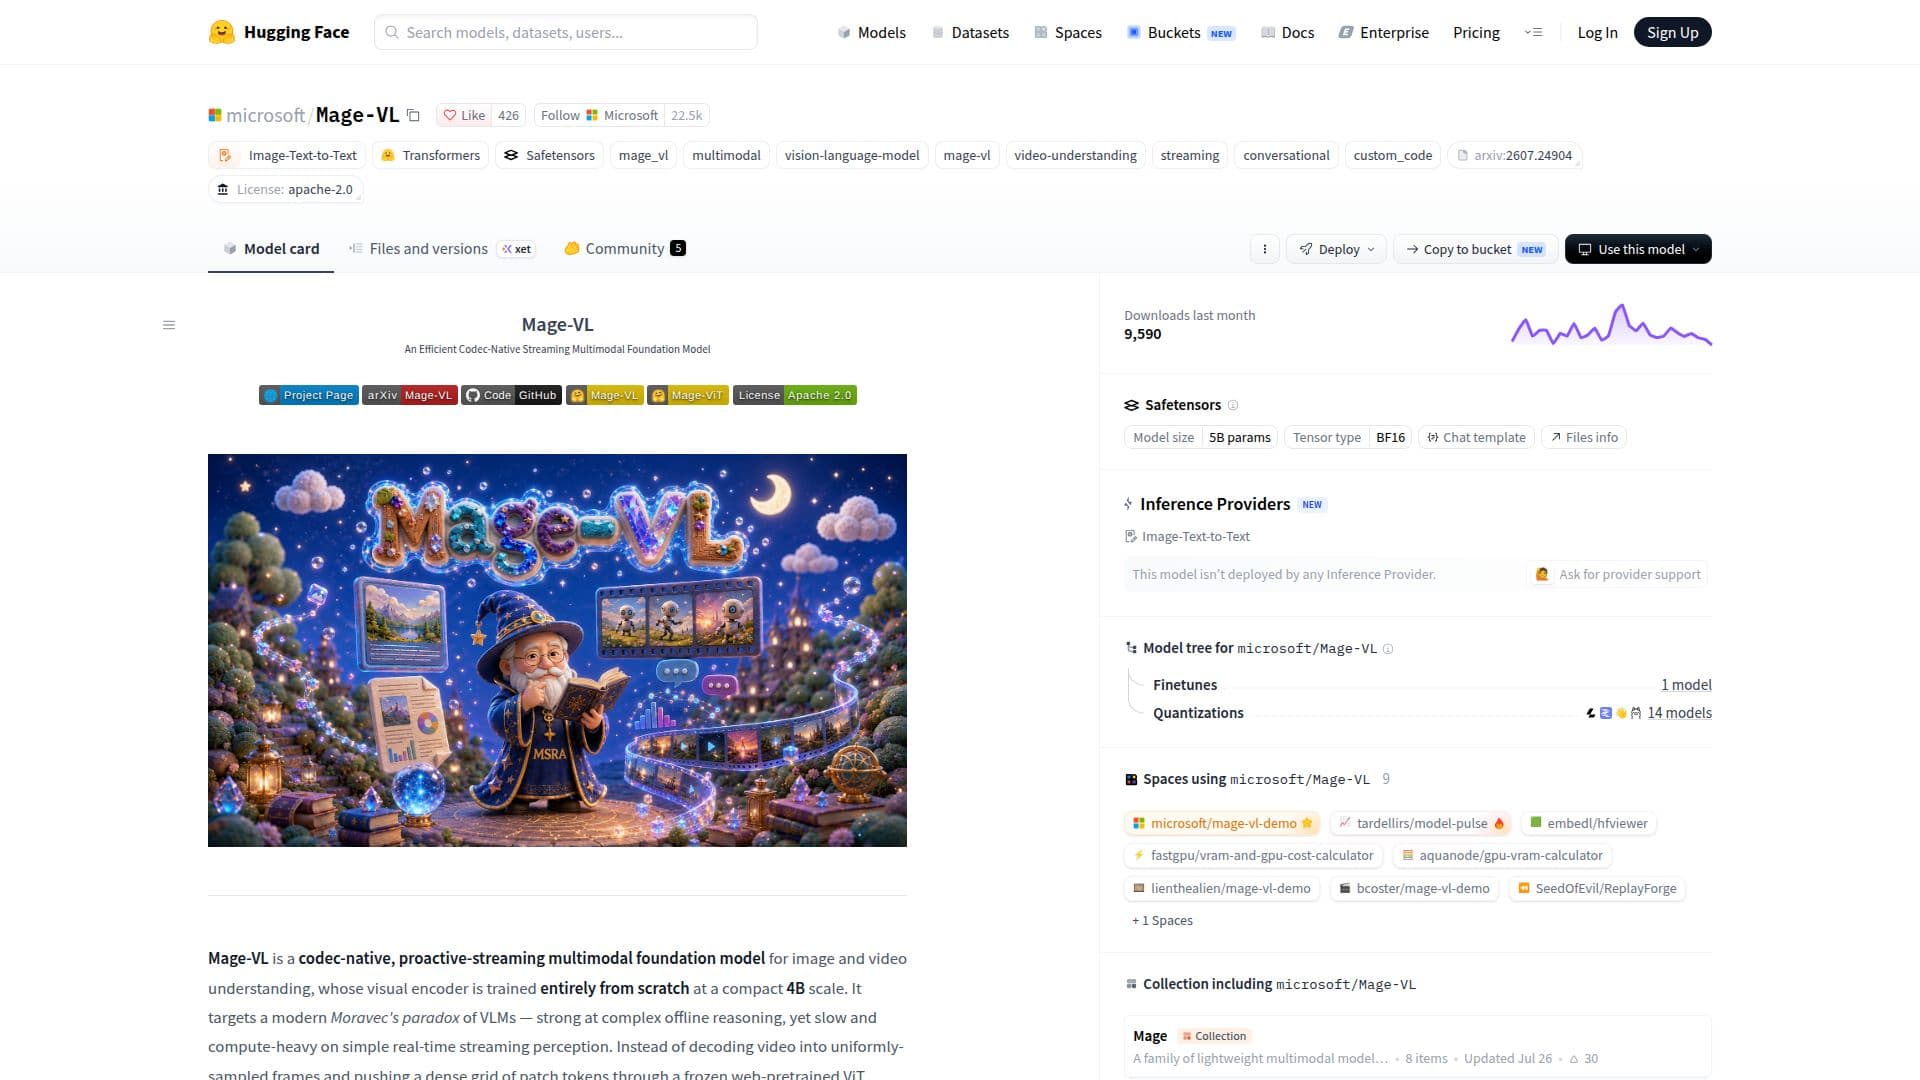
Capture d’écran de Mage-VL

Mage-VL est un modèle de fondation multimodal innovant développé pour relever les défis de la compréhension des images et des vidéos. Il est conçu comme un modèle natif codec et de streaming proactif qui traite efficacement les données visuelles. L'encodeur visuel du modèle, Mage-ViT, est entraîné depuis le début et fonctionne à une échelle compacte de 4B. Cet encodeur est unique dans sa capacité à allouer des tokens en fonction de l'importance spatio-temporelle dérivée du codec, lui permettant de traiter des vidéos jusqu'à huit fois plus longues sous le même budget computationnel.

Lire la suite

L'architecture de Mage-VL comprend un décodeur causal Qwen3-4B, qui est le seul composant pré-entraîné. Ce décodeur fonctionne en tandem avec Mage-ViT pour gérer des flux de tokens de longueur variable, supportant une interface unifiée pour les images et les vidéos de longueurs variées. La conception à double processus du modèle intègre une porte de cognition qui permet un streaming proactif en surveillant le contenu et en activant le modèle de langage visuel complet uniquement lorsque cela est nécessaire.

L'approche native codec du modèle réduit considérablement la consommation de tokens visuels de plus de 75 %, entraînant un gain de vitesse de 3,5× en inférence par rapport aux méthodes traditionnelles. Cette efficacité est atteinte sans compromettre la précision, faisant de Mage-VL un outil puissant pour l'analyse et la compréhension vidéo en temps réel.

Mage-VL est particulièrement performant dans la compréhension vidéo et l'intelligence spatiale, surpassant des modèles comparables sur plusieurs benchmarks. Ses capacités de streaming proactif sont démontrées par ses performances sur les tâches de streaming SoccerNet, où il fournit des commentaires à faible latence et activés par des événements.

Dans l'ensemble, Mage-VL représente une avancée significative dans les modèles d'IA multimodaux, offrant une solution efficace en données pour des tâches visuelles complexes. Sa nature open-source et ses capacités complètes en font une ressource précieuse pour les développeurs et les chercheurs dans le domaine de l'intelligence artificielle.

  • CatégorieModèles d'IA et LLM
  • Modèle tarifaireOpen source
  • DéploiementCloud
  • PlateformesWeb

  • Encodeur visuel natif codec

  • Porte de streaming proactive

  • Décodeur causal Qwen3-4B

  • Accélération de l'inférence de 3,5×

  • Tokeniseur efficace en données

  • Pré-entraînement à résolution variable

  • Modèle unifié pour images et vidéos

  • Commentaire activé par événements

  1. Accéder à la page du modèle : Visitez le dépôt Hugging Face

  2. S'authentifier : Utilisez vos identifiants de compte Hugging Face

  3. Configurer : Configurez les paramètres et l'environnement du modèle

  4. Envoyer des invites : Saisissez vos données d'image ou de vidéo pour traitement

  5. Ajuster : Modifiez les paramètres du modèle pour des tâches spécifiques

  • Analyse Vidéo en Temps Réel
  • Intelligence Spatiale
  • Commentaire Activé par Événements
  • Compréhension d'Image
  • Streaming Proactif

Outils IA populaires comme Mage-VL

Qwen3.5-4B est un modèle de langage causal avec un encodeur visuel, conçu pour un apprentissage multimodal haute performance. Il prend en charge 201 langues et offre une…

Modèles d'IA et LLM
Voir l'outil

Qwen3.5-4B est un modèle de langage causal avec un encodeur visuel, conçu pour un apprentissage multimodal haute performance. Il prend en charge 201 langues et offre une…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

DeepSeek-V4-Flash-Vision-Exp est un modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…

Modèles d'IA et LLM
Voir l'outil

Modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…DeepSeek-V4-Flash-Vision-Exp est un modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…

Modèles d'IA et LLM
Voir le Top 50 LLM

MiniMax M3 est un modèle d'IA avancé excelling dans les tâches de codage et agentiques. Il dispose d'une fenêtre de contexte de 1M et d'une compréhension multimodale native,…

Modèles d'IA et LLM

N°49 en LLM

Voir l'outil

Modèle d'IA avancé excelling dans les tâches de codage et agentiques. Il dispose d'une fenêtre de contexte de 1M et d'une compréhension multimodale native,…MiniMax M3 est un modèle d'IA avancé excelling dans les tâches de codage et agentiques. Il dispose d'une fenêtre de contexte de 1M et d'une compréhension multimodale native,…

Modèles d'IA et LLM
N°49 en LLM

Ideogram 4

Modèles IA

Ideogram 4 est un modèle de pointe de génération d'images à partir de texte, offrant un contrôle sans précédent sur la composition, le style et la mise en page des images. Il…

Modèles d'IA et LLM
Voir l'outil

Modèles IA

Modèle de pointe de génération d'images à partir de texte, offrant un contrôle sans précédent sur la composition, le style et la mise en page des images. Il…Ideogram 4 est un modèle de pointe de génération d'images à partir de texte, offrant un contrôle sans précédent sur la composition, le style et la mise en page des images. Il…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

Modèle avancé de compréhension vidéo conçu pour fonctionner efficacement sur divers appareils. Il offre des capacités d'analyse vidéo et de raisonnement visuel…SmolVLM2 est un modèle avancé de compréhension vidéo conçu pour fonctionner efficacement sur divers appareils. Il offre des capacités d'analyse vidéo et de raisonnement visuel…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

Pixtral-12B-2409 est un modèle d'IA multimodal avec 12 milliards de paramètres et un encodeur de vision de 400 millions de paramètres, conçu pour des tâches avancées de traitement…

Modèles d'IA et LLM
Voir l'outil

Pixtral-12B-2409 est un modèle d'IA multimodal avec 12 milliards de paramètres et un encodeur de vision de 400 millions de paramètres, conçu pour des tâches avancées de traitement…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

V-JEPA

Dépôts GitHub d'IA

V-JEPA est une implémentation PyTorch pour l'apprentissage auto-supervisé à partir de vidéos. Elle utilise une architecture prédictive à joint-embedding pour apprendre des…

Modèles d'IA et LLM
Voir l'outil

Dépôts GitHub d'IA

Implémentation PyTorch pour l'apprentissage auto-supervisé à partir de vidéos. Elle utilise une architecture prédictive à joint-embedding pour apprendre des…V-JEPA est une implémentation PyTorch pour l'apprentissage auto-supervisé à partir de vidéos. Elle utilise une architecture prédictive à joint-embedding pour apprendre des…

Modèles d'IA et LLM
Voir le Top 250 Dépôts GitHub d'IA

LTX-2

Modèles IA

LTX-2 est un modèle de fondation audio-vidéo basé sur DiT, conçu pour générer des vidéos et des audios synchronisés. Il combine des techniques modernes de génération vidéo avec…

Modèles d'IA et LLM
Voir l'outil

Modèles IA

Modèle de fondation audio-vidéo basé sur DiT, conçu pour générer des vidéos et des audios synchronisés. Il combine des techniques modernes de génération vidéo avec…LTX-2 est un modèle de fondation audio-vidéo basé sur DiT, conçu pour générer des vidéos et des audios synchronisés. Il combine des techniques modernes de génération vidéo avec…

En vedetteModèles d'IA et LLM
Voir le Top 5 Modèles IA
1 sur 8