Description
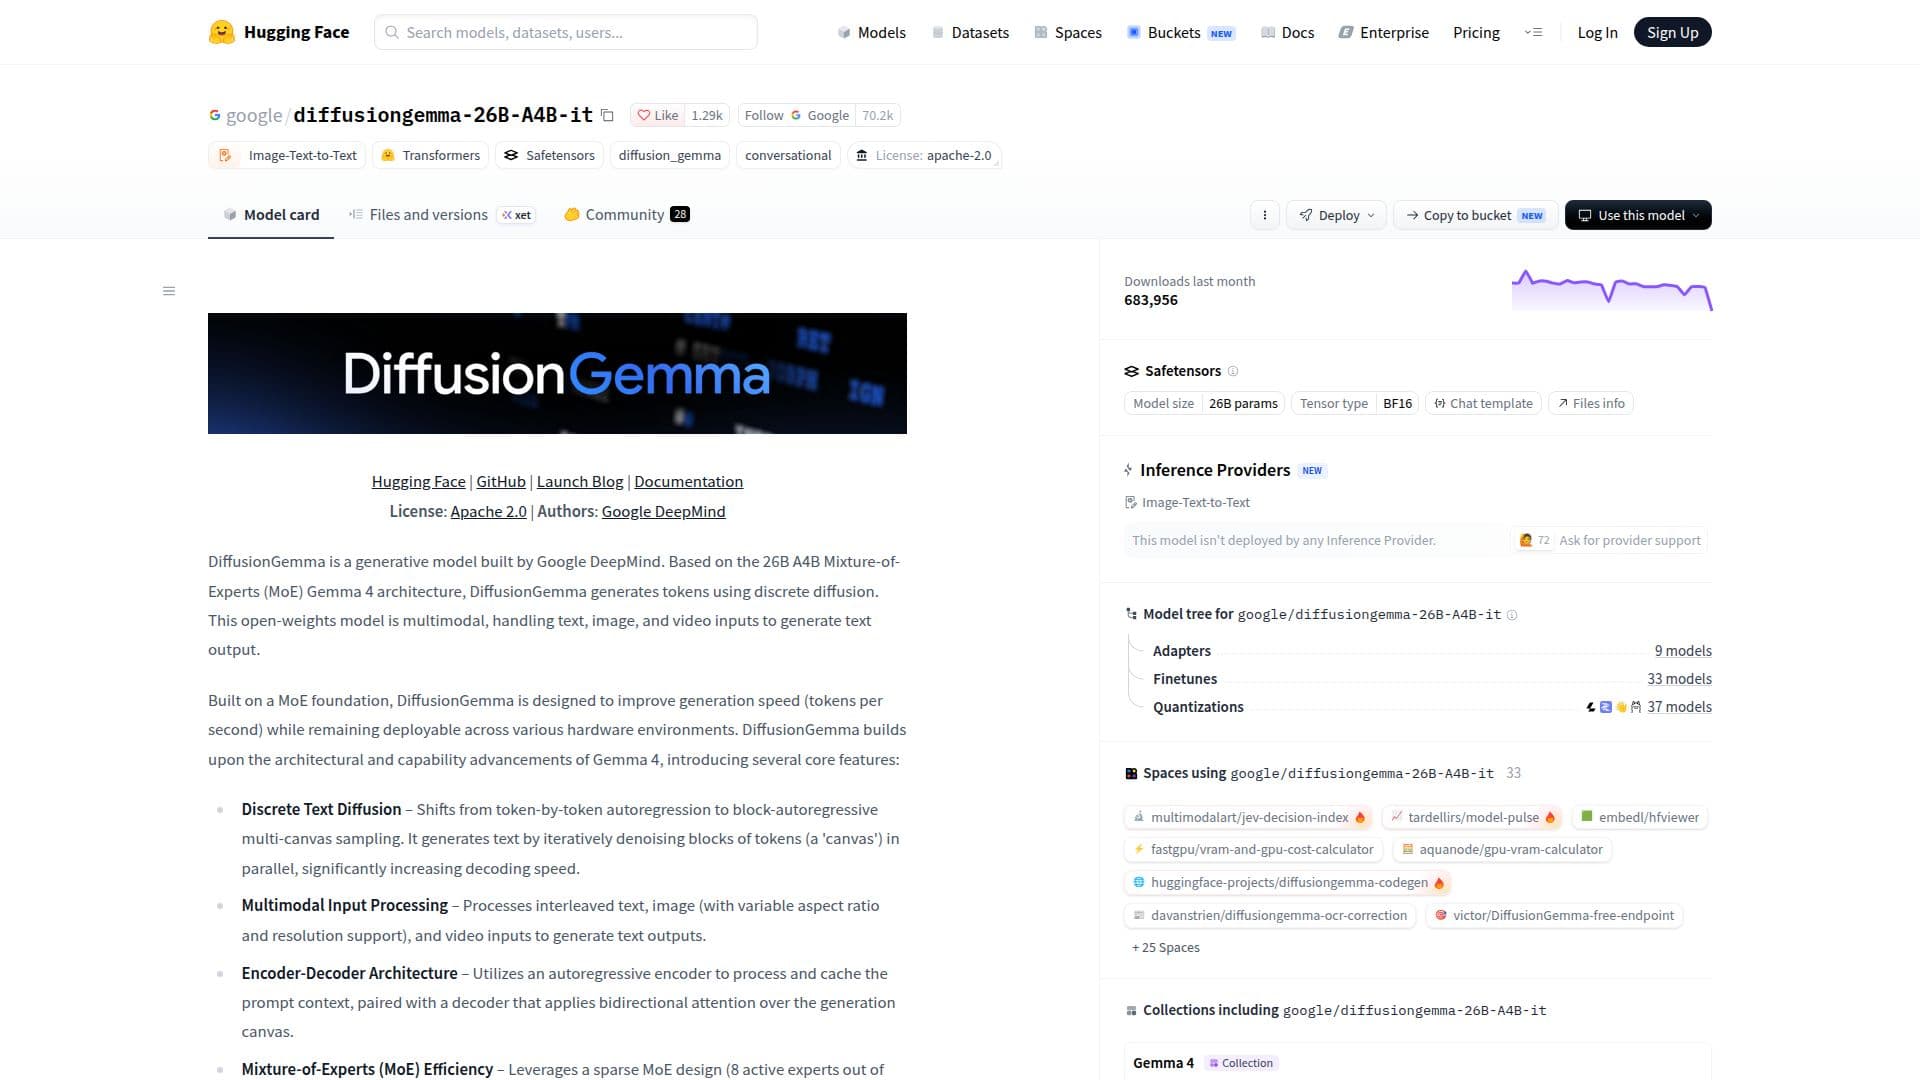
DiffusionGemma, développé par Google DeepMind, est un modèle génératif qui exploite l'architecture Mixture-of-Experts (MoE) Gemma 4 de 26B A4B. Il est conçu pour générer des sorties textuelles à partir d'entrées multimodales, y compris du texte, des images et des vidéos. Le modèle utilise une diffusion discrète pour améliorer la vitesse de génération des tokens, ce qui le rend adapté à un déploiement sur divers environnements matériels.
Lire la suite
L'architecture du modèle présente une méthode d'échantillonnage multi-canvas autoregressive par blocs, qui augmente considérablement la vitesse de décodage en débruitant des blocs de tokens en parallèle. Cette approche permet à DiffusionGemma de générer du texte à une vitesse supérieure par rapport aux modèles autoregressifs traditionnels. L'architecture encodeur-décodeur utilise un encodeur autoregressif pour traiter et mettre en cache le contexte de l'invite, tandis que le décodeur applique une attention bidirectionnelle sur le canevas de génération.
La conception MoE sparse de DiffusionGemma, avec 8 experts actifs sur 128, offre de solides capacités de raisonnement tout en maintenant une faible empreinte mémoire. Cette efficacité le rend adapté à une exécution locale et optimisé pour l'inférence à petite taille de lot, atteignant une génération à grande vitesse sur un seul accélérateur capable.
Le modèle prend en charge les mises à jour d'invite système natives, permettant des conversations structurées et contrôlables. Il comprend également un mode de réflexion configurable pour des capacités de raisonnement améliorées. Avec une fenêtre de contexte allant jusqu'à 256K tokens, DiffusionGemma peut gérer efficacement des tâches à long contexte.
DiffusionGemma a été évalué par rapport à divers benchmarks, montrant des performances compétitives dans les tâches de génération de texte et de raisonnement. Il prend en charge des capacités multilingues, pré-entraîné sur plus de 140 langues, et offre des fonctionnalités robustes de compréhension d'images et de vidéos, y compris la détection d'objets, l'analyse de documents et l'analyse de contenu vidéo.
Dans l'ensemble, DiffusionGemma est un modèle polyvalent conçu pour la génération de texte multimodale à grande vitesse, adapté à un large éventail d'applications dans la création de contenu, la recherche et l'éducation.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen Weights
- DéploiementCloud
- PlateformesWeb
Points forts de DiffusionGemma
Diffusion de texte discrète
Traitement d'entrées multimodales
Architecture encodeur-décodeur
Efficacité Mixture-of-Experts
Mode de réflexion
Optimisé pour l'inférence à petite taille de lot
Support natif des invites système
Gestion de long contexte
Premiers pas avec DiffusionGemma
Accéder à la page du modèle : Visitez la page du modèle Hugging Face
S'authentifier : Connectez-vous ou créez un compte
Configurer : Configurez les paramètres du modèle
Envoyer des invites : Saisissez des invites textuelles, d'images ou de vidéos
Ajuster : Modifiez les paramètres pour des tâches spécifiques
Cas d'utilisation de DiffusionGemma
- Génération de texte
- Extraction de données d'images
- Compréhension vidéo
- Support multilingue
- Recherche et éducation