Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

Cactus Runtime

LLM#82MLOps et déploiement de modèlesOpen source · macOS, Linux, Windows

Cactus Runtime fournit des binaires précompilés pour les modèles Needle 3, Whistle et Mirage, permettant l'exécution locale de tâches de texte, de parole et de vision. Il prend en charge un large éventail de plateformes, y compris macOS, Linux, Windows, Android, iOS, tvOS, watchOS et les environnements web. Les développeurs peuvent l'intégrer via l'API Python ou des exécuteurs natifs, avec des poids de modèle gérés séparément.

Visiter l'URL
Partager
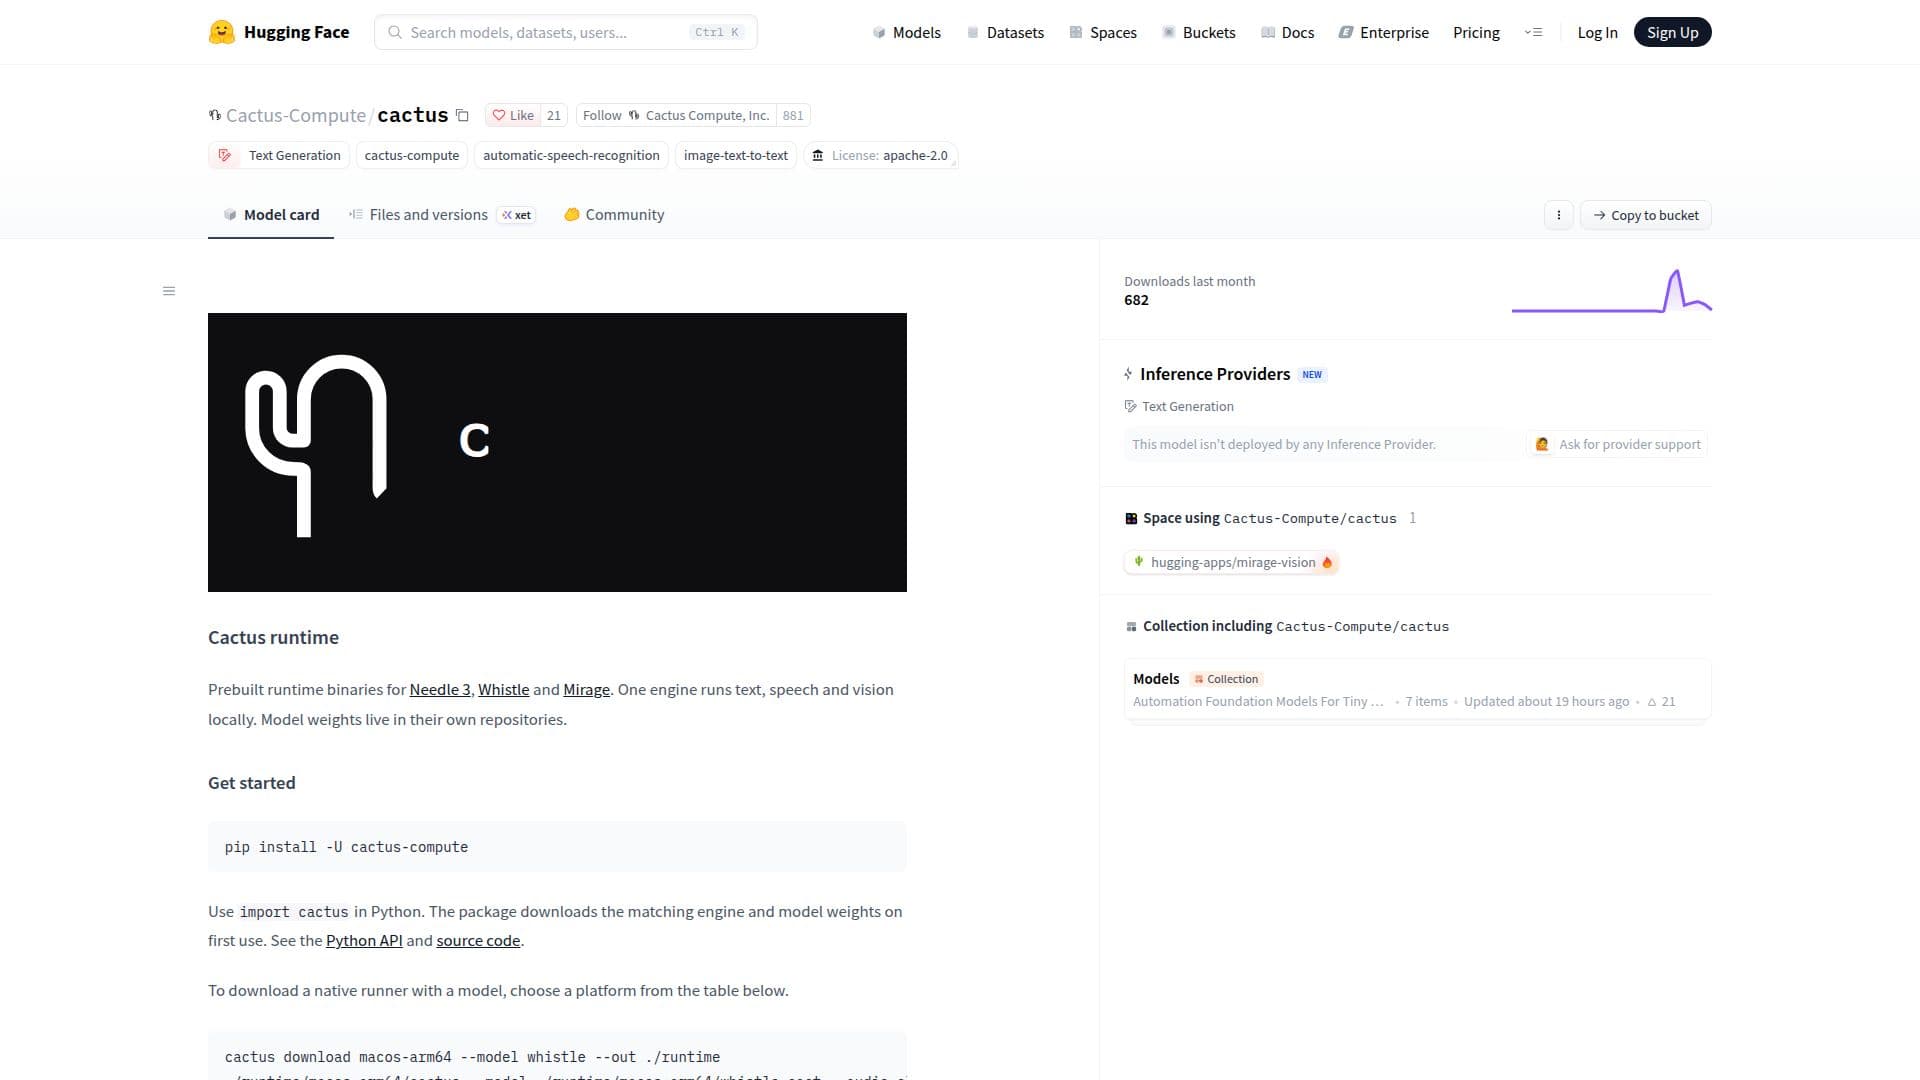
Capture d’écran de Cactus Runtime

Cactus Runtime est un moteur polyvalent conçu pour exécuter des modèles de texte, de parole et de vision localement sur divers systèmes d'exploitation et environnements. Il offre des binaires d'exécution précompilés pour des modèles spécifiques comme Needle 3, Whistle et Mirage, permettant aux développeurs d'intégrer des capacités d'IA puissantes directement dans leurs applications.

Lire la suite

La fonctionnalité principale de Cactus consiste à fournir un moteur unifié capable de gérer diverses tâches d'IA. Les poids des modèles sont stockés dans leurs propres dépôts, garantissant flexibilité et modularité. Pour les développeurs Python, l'intégration est simple : il suffit d'importer `cactus`, et le package télécharge automatiquement le moteur correspondant et les poids des modèles lors de la première utilisation. Une API Python complète et le code source sont disponibles pour une mise en œuvre détaillée.

Cactus prend en charge une liste étendue de plateformes, ce qui le rend hautement adaptable à différents scénarios de déploiement. Cela inclut macOS Apple Silicon, diverses distributions Linux (x86-64, ARM64, ARMv7, RISC-V, MIPS32el), Windows (x64, ARM64), Android (ARM64, ARMv7, RISC-V), iOS (ARM64, Simulateur ARM64), tvOS ARM64, watchOS ARM64, et même des environnements de navigateur et Node.js via WebAssembly (WASM). Cette large compatibilité garantit que les développeurs peuvent déployer leurs modèles d'IA sur presque n'importe quel appareil ou système cible.

Pour une intégration native, les développeurs peuvent télécharger des exécuteurs spécifiques pour leur plateforme choisie. Ces exécuteurs sont conçus pour charger les poids `.cact` à l'exécution. Des bibliothèques statiques, y compris `cactus.h`, sont fournies pour les applications C et C++, facilitant une intégration profonde dans les bases de code natives existantes. Les roues d'exécution Python étendent encore ce support, couvrant les architectures de bureau et de serveur courantes.

Cactus propose également un composant WASI, exportant `cactus:runtime/[email protected]`, et est disponible en tant qu'artéfact OCI signé. Cela permet un déploiement dans des environnements WebAssembly System Interface, élargissant son utilisation aux fonctions sans serveur et à d'autres applications modernes cloud-native. Le projet met l'accent sur des téléchargements reproductibles, fournissant des sommes de contrôle SHA-256 et des balises de révision spécifiques pour les artéfacts de version. Un guide de déploiement détaillé est disponible pour aider à l'intégration native, à l'utilisation dans le navigateur et à la configuration hors ligne.

  • CatégorieMLOps et déploiement de modèles
  • Modèle tarifaireOpen source
  • DéploiementExécution locale, Cloud
  • PlateformesmacOS, Linux, Windows

  • Exécution locale de modèles de texte, de parole et de vision

  • Binaires d'exécution précompilés pour Needle 3, Whistle et Mirage

  • API Python pour une intégration facile

  • Téléchargements automatiques du moteur et des poids des modèles lors de la première utilisation (Python)

  • Support pour macOS Apple Silicon

  • Support pour Linux x86-64, ARM64, ARMv7, RISC-V, MIPS32el

  • Support pour Windows x64 et ARM64

  • Support pour Android ARM64, ARMv7, RISC-V

  • Support pour iOS ARM64, Simulateur iOS ARM64

  • Support pour tvOS ARM64 et watchOS ARM64

  • Support WebAssembly (WASM) pour le navigateur et Node.js

  • Composant WASI pour les environnements WebAssembly System Interface

  • Bibliothèques statiques (libcactus.a, cactus.h) pour les applications C/C++

  • Poids des modèles gérés dans des dépôts séparés

  • Sommes de contrôle SHA-256 pour des téléchargements reproductibles

  1. Installer le package Python : Utilisez `import cactus` en Python pour télécharger automatiquement le moteur et les poids des modèles.

  2. Télécharger l'exécuteur natif : Choisissez une plateforme dans la liste des supports et téléchargez les binaires correspondants.

  3. Spécifier le modèle : Utilisez `--model needle3` ou `--model mirage` lors de l'exécution des exécuteurs natifs pour sélectionner un modèle spécifique.

  4. Intégrer avec C/C++ : Incluez `cactus.h` et liez `libcactus.a` dans vos applications C/C++.

  5. Déployer avec WASI : Utilisez le composant WASI `cactus:runtime/[email protected]` ou l'artéfact OCI pour les environnements WASI.

  6. Accéder à l'API Python : Consultez la documentation de l'API Python pour des exemples d'utilisation détaillés et de code source.

  • Exécution locale de modèles d'IA
  • Développement d'IA multiplateforme
  • Systèmes d'IA embarqués
  • Applications d'IA basées sur le web
  • Intégration d'applications natives
  • Développement d'IA en Python
  • Traitement d'IA hors ligne

Chez Cactus Compute

Une fonctionnalité de Cactus Compute.

Avis sur Cactus Runtime

Chargement...

Outils IA populaires comme Cactus Runtime

Cactus Compute

Dépôts GitHub d'IA

Cactus Compute est un projet open-source axé sur la quantification, les noyaux, l'exécution et les moteurs d'inférence pour les appareils mobiles, les dispositifs portables, les…

Plateformes de machine learning

N°182 en Dépôts GitHub d'IA

Voir l'outil

Dépôts GitHub d'IA

Projet open-source axé sur la quantification, les noyaux, l'exécution et les moteurs d'inférence pour les appareils mobiles, les dispositifs portables, les…Cactus Compute est un projet open-source axé sur la quantification, les noyaux, l'exécution et les moteurs d'inférence pour les appareils mobiles, les dispositifs portables, les…

Plateformes de machine learning
N°182 en Dépôts GitHub d'IA

SGLang-Omni

Dépôts GitHub d'IA

SGLang-Omni est un cadre de service haute performance conçu pour les modèles audio tels que TTS et ASR, ainsi que pour les modèles multimodaux unifiés. Il offre un support robuste…

MLOps et déploiement de modèles

N°78 en Générateurs de voix IA

Voir l'outil

Dépôts GitHub d'IA

Cadre de service haute performance conçu pour les modèles audio tels que TTS et ASR, ainsi que pour les modèles multimodaux unifiés. Il offre un support robuste…SGLang-Omni est un cadre de service haute performance conçu pour les modèles audio tels que TTS et ASR, ainsi que pour les modèles multimodaux unifiés. Il offre un support robuste…

MLOps et déploiement de modèles
N°78 en Générateurs de voix IA

Runware

Applications IA

Runware est une plateforme d'inférence d'IA générative qui fournit une API unifiée pour les modèles d'image, de vidéo, d'audio, 3D, LLM et de vision. Elle propose plus de 400 000…

MLOps et déploiement de modèles
Voir l'outil

Applications IA

Plateforme d'inférence d'IA générative qui fournit une API unifiée pour les modèles d'image, de vidéo, d'audio, 3D, LLM et de vision. Elle propose plus de 400 000…Runware est une plateforme d'inférence d'IA générative qui fournit une API unifiée pour les modèles d'image, de vidéo, d'audio, 3D, LLM et de vision. Elle propose plus de 400 000…

MLOps et déploiement de modèles
Voir le Top 250 Applications IA

Replicate fournit une API cloud pour exécuter et affiner des modèles d'apprentissage automatique open source. Déployez des modèles personnalisés avec une seule ligne de code.…

MLOps et déploiement de modèles
Voir l'outil

Fournit une API cloud pour exécuter et affiner des modèles d'apprentissage automatique open source. Déployez des modèles personnalisés avec une seule ligne de code.…Replicate fournit une API cloud pour exécuter et affiner des modèles d'apprentissage automatique open source. Déployez des modèles personnalisés avec une seule ligne de code.…

En vedetteMLOps et déploiement de modèles
Voir le Top 150 Plateformes IA

SiliconFlow

Plateformes IA

Une plateforme d'infrastructure IA pour les développeurs afin de déployer, d'affiner et d'exécuter plus de 200 LLM optimisés et modèles multimodaux via une API compatible OpenAI…

MLOps et déploiement de modèles
Voir l'outil

Plateformes IA

Une plateforme d'infrastructure IA pour les développeurs afin de déployer, d'affiner et d'exécuter plus de 200 LLM optimisés et modèles multimodaux via une API compatible OpenAI…

En vedetteMLOps et déploiement de modèles
Voir le Top 150 Plateformes IA

Baseten

Plateformes IA

La plateforme d'inférence de Baseten permet aux utilisateurs de déployer et de mettre à l'échelle des modèles d'IA open-source et personnalisés de manière efficace. Elle offre une…

MLOps et déploiement de modèles

N°72 en Plateformes IA

Voir l'outil

Plateformes IA

La plateforme d'inférence de Baseten permet aux utilisateurs de déployer et de mettre à l'échelle des modèles d'IA open-source et personnalisés de manière efficace. Elle offre une…

En vedetteMLOps et déploiement de modèles
N°72 en Plateformes IA

SGLang

Frameworks IA

SGLang est un cadre de service haute performance conçu pour les grands modèles de langage et multimodaux. Il offre un support matériel étendu et un écosystème robuste pour les…

MLOps et déploiement de modèles
Voir l'outil

Frameworks IA

Cadre de service haute performance conçu pour les grands modèles de langage et multimodaux. Il offre un support matériel étendu et un écosystème robuste pour les…SGLang est un cadre de service haute performance conçu pour les grands modèles de langage et multimodaux. Il offre un support matériel étendu et un écosystème robuste pour les…

En vedetteMLOps et déploiement de modèles
Voir le Top 50 Frameworks IA

TensorFold

Dépôts GitHub d'IA

TensorFold est un moteur d'inférence LLM open-source conçu pour le calcul haute performance sur diverses plateformes matérielles. Il prend en charge Metal, CUDA et Vulkan, offrant…

MLOps et déploiement de modèles
Voir l'outil

Dépôts GitHub d'IA

Moteur d'inférence LLM open-source conçu pour le calcul haute performance sur diverses plateformes matérielles. Il prend en charge Metal, CUDA et Vulkan, offrant…TensorFold est un moteur d'inférence LLM open-source conçu pour le calcul haute performance sur diverses plateformes matérielles. Il prend en charge Metal, CUDA et Vulkan, offrant…

MLOps et déploiement de modèles
Voir le Top 250 Dépôts GitHub d'IA
1 sur 8