

Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

Modèles Multilingues BERT

LLM#50Modèles d'IA et LLMOpen source · Web

BERT propose deux modèles multilingues : Cased et Uncased, prenant en charge plus de 100 langues. Le modèle Cased est recommandé pour les alphabets non latins et l'usage général, tandis que le modèle Uncased est une version plus ancienne. Ces modèles sont conçus pour les tâches de compréhension du langage naturel et peuvent être affinés pour des applications spécifiques.

Visiter l'URL
Partager
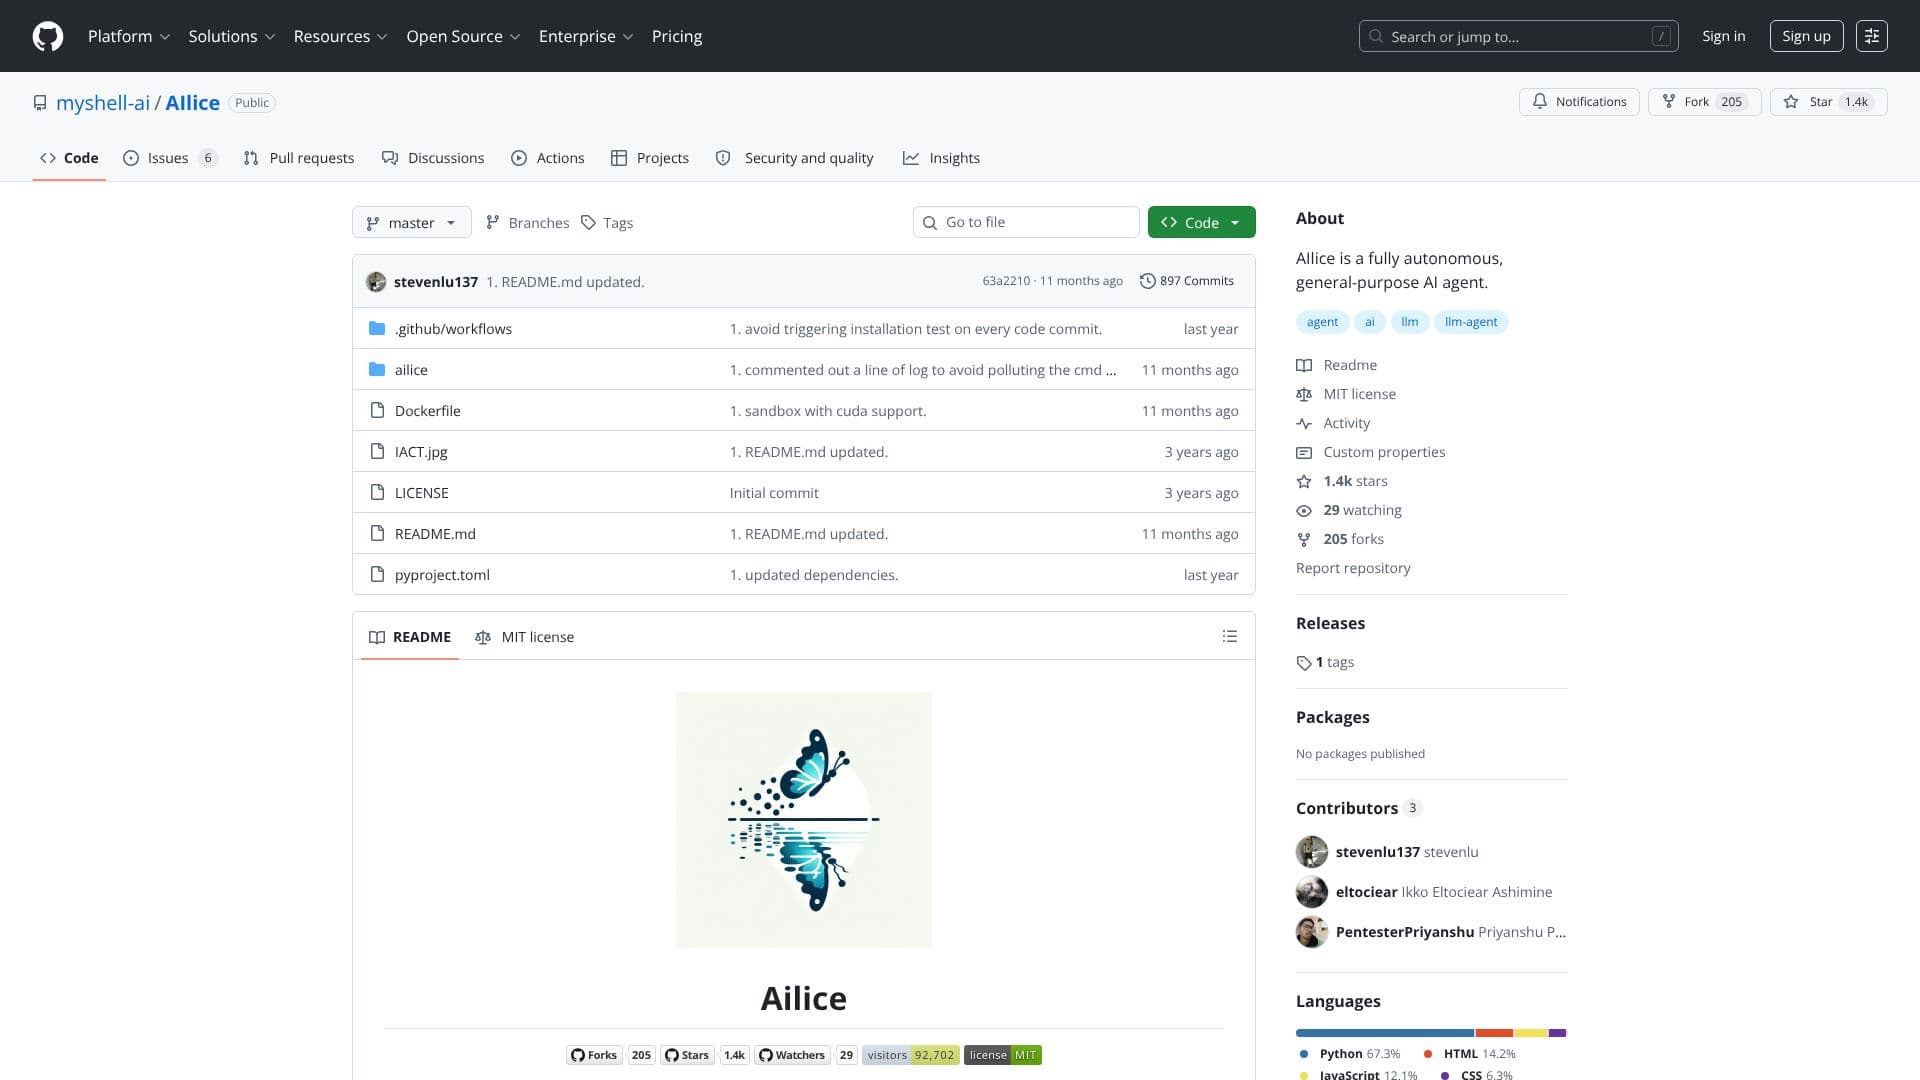
Capture d’écran de Modèles Multilingues BERT

Le projet BERT (Bidirectional Encoder Representations from Transformers) fournit des modèles pré-entraînés pour les tâches de traitement du langage naturel. Parmi ses offres figurent des modèles multilingues conçus pour gérer un large éventail de langues, permettant la compréhension et les applications interlingues. Actuellement, deux modèles multilingues principaux sont disponibles : BERT-Base, Multilingual Cased (Nouveau, recommandé) et BERT-Base, Multilingual Uncased (Orig, non recommandé).

Lire la suite

Le modèle BERT-Base, Multilingual Cased prend en charge 104 langues et présente une architecture à 12 couches avec 768 unités cachées, 12 têtes d'attention et 110 millions de paramètres. Ce modèle est recommandé en raison de sa normalisation améliorée pour de nombreuses langues, en particulier celles avec des alphabets non latins. Lors de l'utilisation de ce modèle, il est crucial de définir `--do_lower_case=false` dans les scripts d'exécution. Le modèle Multilingual Uncased, bien qu'il prenne en charge 102 langues avec la même architecture, n'est pas recommandé pour les nouveaux projets.

Pour les tâches en langue chinoise, un modèle BERT-Base, Chinese dédié est également disponible, prenant en charge le chinois simplifié et traditionnel. Bien que les modèles multilingues incluent le chinois, un modèle uniquement chinois peut donner de meilleurs résultats pour l'affinage spécifique au chinois. Les performances de ces modèles ont été évaluées sur le jeu de données XNLI, une tâche d'inférence en langage naturel interlingue. Les résultats indiquent que si les modèles à langue unique peuvent surpasser les modèles multilingues pour les langues à haute ressource, ces derniers offrent une solution pratique pour une couverture linguistique étendue sans avoir à maintenir de nombreux modèles à langue unique.

L'affinage des modèles BERT multilingues ne nécessite pas de changements d'API significatifs. Cependant, des mises à jour du `BasicTokenizer` peuvent être nécessaires pour la tokenisation des caractères chinois. Les modèles peuvent être intégrés dans des flux de travail à l'aide de scripts fournis comme `run_classifier.py`, qui a été mis à jour pour prendre en charge des jeux de données comme XNLI. La stratégie d'échantillonnage des données pour le pré-entraînement impliquait une pondération lissée exponentiellement des données de Wikipedia pour équilibrer les langues à haute et basse ressource, assurant une meilleure représentation pour tous. La tokenisation utilise un vocabulaire WordPiece partagé, avec une gestion spécifique pour les langues CJK afin de pallier l'absence d'espaces. Le modèle multilingue omet intentionnellement les marqueurs de langue pour faciliter les capacités d'apprentissage zero-shot.

  • CatégorieModèles d'IA et LLM
  • Modèle tarifaireOpen source
  • DéploiementCloud
  • PlateformesWeb

  • Prend en charge 104 langues (Multilingual Cased)

  • Prend en charge 102 langues (Multilingual Uncased)

  • Architecture Transformer à 12 couches

  • 768 unités cachées

  • 12 têtes d'attention

  • 110 millions de paramètres

  • Modèle Multilingual Cased recommandé pour une normalisation améliorée

  • Capacité d'apprentissage zero-shot

  • Support d'affinage pour des tâches spécifiques

  • Pré-entraîné sur des données Wikipedia

  • Vocabulaire WordPiece partagé

  • Gère les langues CJK avec tokenisation par caractère

  • Code TensorFlow open-source disponible

  1. Accéder au modèle : Télécharger les modèles BERT multilingues pré-entraînés.

  2. Configurer l'environnement : Installer TensorFlow et les dépendances nécessaires.

  3. Intégrer via API : Charger les modèles et les tokenizers en utilisant les bibliothèques fournies.

  4. Préparer les données : Formater vos données textuelles multilingues pour l'entraînement ou l'inférence.

  5. Affiner : Adapter le modèle à des tâches spécifiques en aval comme la classification ou la réponse aux questions.

  6. Exécuter l'inférence : Utiliser le modèle affiné pour traiter de nouvelles données textuelles.

  7. Évaluer les performances : Évaluer la précision du modèle sur des benchmarks multilingues pertinents.

  • Classification interlingue
  • Analyse de sentiment multilingue
  • Transfert zero-shot interlingue
  • Évaluation de la traduction automatique
  • Réponse aux questions multilingue
  • Recherche d'informations interlingue
  • Inférence en langage naturel

Chez Google

Avis sur Modèles Multilingues BERT

Chargement...

Outils IA populaires comme Modèles Multilingues BERT

Le modèle de base BERT (non sensible à la casse) est un modèle de transformateur préentraîné conçu pour comprendre la langue anglaise. Il utilise la modélisation de langage masqué…

Outils de traitement du langage naturel
Voir l'outil

Le modèle de base BERT (non sensible à la casse) est un modèle de transformateur préentraîné conçu pour comprendre la langue anglaise. Il utilise la modélisation de langage masqué…

En vedetteOutils de traitement du langage naturel
Voir le Top 5 Modèles IA

SmolLM3 est un modèle de langage de 3 milliards de paramètres conçu pour repousser les limites des petits modèles. Il prend en charge le raisonnement en mode double, six langues…

Modèles d'IA et LLM

N°45 en LLM

Voir l'outil

SmolLM3 est un modèle de langage de 3 milliards de paramètres conçu pour repousser les limites des petits modèles. Il prend en charge le raisonnement en mode double, six langues…

Modèles d'IA et LLM
N°45 en LLM

SpanBERT

Dépôts GitHub d'IA

SpanBERT est un modèle d'IA axé sur l'amélioration du pré-entraînement en représentant et en prédisant des segments de texte. Il propose des modèles de base et larges…

Modèles d'IA et LLM
Voir l'outil

Dépôts GitHub d'IA

Modèle d'IA axé sur l'amélioration du pré-entraînement en représentant et en prédisant des segments de texte. Il propose des modèles de base et larges…SpanBERT est un modèle d'IA axé sur l'amélioration du pré-entraînement en représentant et en prédisant des segments de texte. Il propose des modèles de base et larges…

Modèles d'IA et LLM
Voir le Top 250 Dépôts GitHub d'IA

XLM-RoBERTa Base

Modèles IA

XLM-RoBERTa est un modèle multilingue pré-entraîné sur 2,5 To de données dans 100 langues. Il excelle dans des tâches telles que la classification de séquences et la…

Modèles d'IA et LLM
Voir l'outil

Modèles IA

Modèle multilingue pré-entraîné sur 2,5 To de données dans 100 langues. Il excelle dans des tâches telles que la classification de séquences et la…XLM-RoBERTa est un modèle multilingue pré-entraîné sur 2,5 To de données dans 100 langues. Il excelle dans des tâches telles que la classification de séquences et la…

En vedetteModèles d'IA et LLM
Voir le Top 5 Modèles IA

DeepSeek est une entreprise de recherche en IA dédiée au développement de l'intelligence artificielle générale. Elle propose des LLM de pointe en open source tels que DeepSeek-V4,…

Modèles d'IA et LLM

N°2 en LLM

Voir l'outil

Entreprise de recherche en IA dédiée au développement de l'intelligence artificielle générale. Elle propose des LLM de pointe en open source tels que DeepSeek-V4,…DeepSeek est une entreprise de recherche en IA dédiée au développement de l'intelligence artificielle générale. Elle propose des LLM de pointe en open source tels que DeepSeek-V4,…

En vedetteModèles d'IA et LLM
N°2 en LLM

Qwen1.5-110B est un modèle de langage basé sur un transformateur offrant des améliorations de performance significatives, un support multilingue et une longueur de contexte stable…

Modèles d'IA et LLM
Voir l'outil

Qwen1.5-110B est un modèle de langage basé sur un transformateur offrant des améliorations de performance significatives, un support multilingue et une longueur de contexte stable…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

Le modèle intfloat multilingual-e5-large est un outil d'IA robuste conçu pour les embeddings de texte multilingues. Il prend en charge 100 langues et est optimisé pour des tâches…

Modèles d'IA et LLM
Voir l'outil

Llama-3.1-8B-Instruct est un modèle de langage large multilingue développé par Meta, optimisé pour les tâches basées sur des instructions. Il est conçu pour des applications…

Modèles d'IA et LLM
Voir l'outil

Modèle de langage large multilingue développé par Meta, optimisé pour les tâches basées sur des instructions. Il est conçu pour des applications…Llama-3.1-8B-Instruct est un modèle de langage large multilingue développé par Meta, optimisé pour les tâches basées sur des instructions. Il est conçu pour des applications…

En vedetteModèles d'IA et LLM
Voir le Top 5 Modèles IA
1 sur 8







