Description
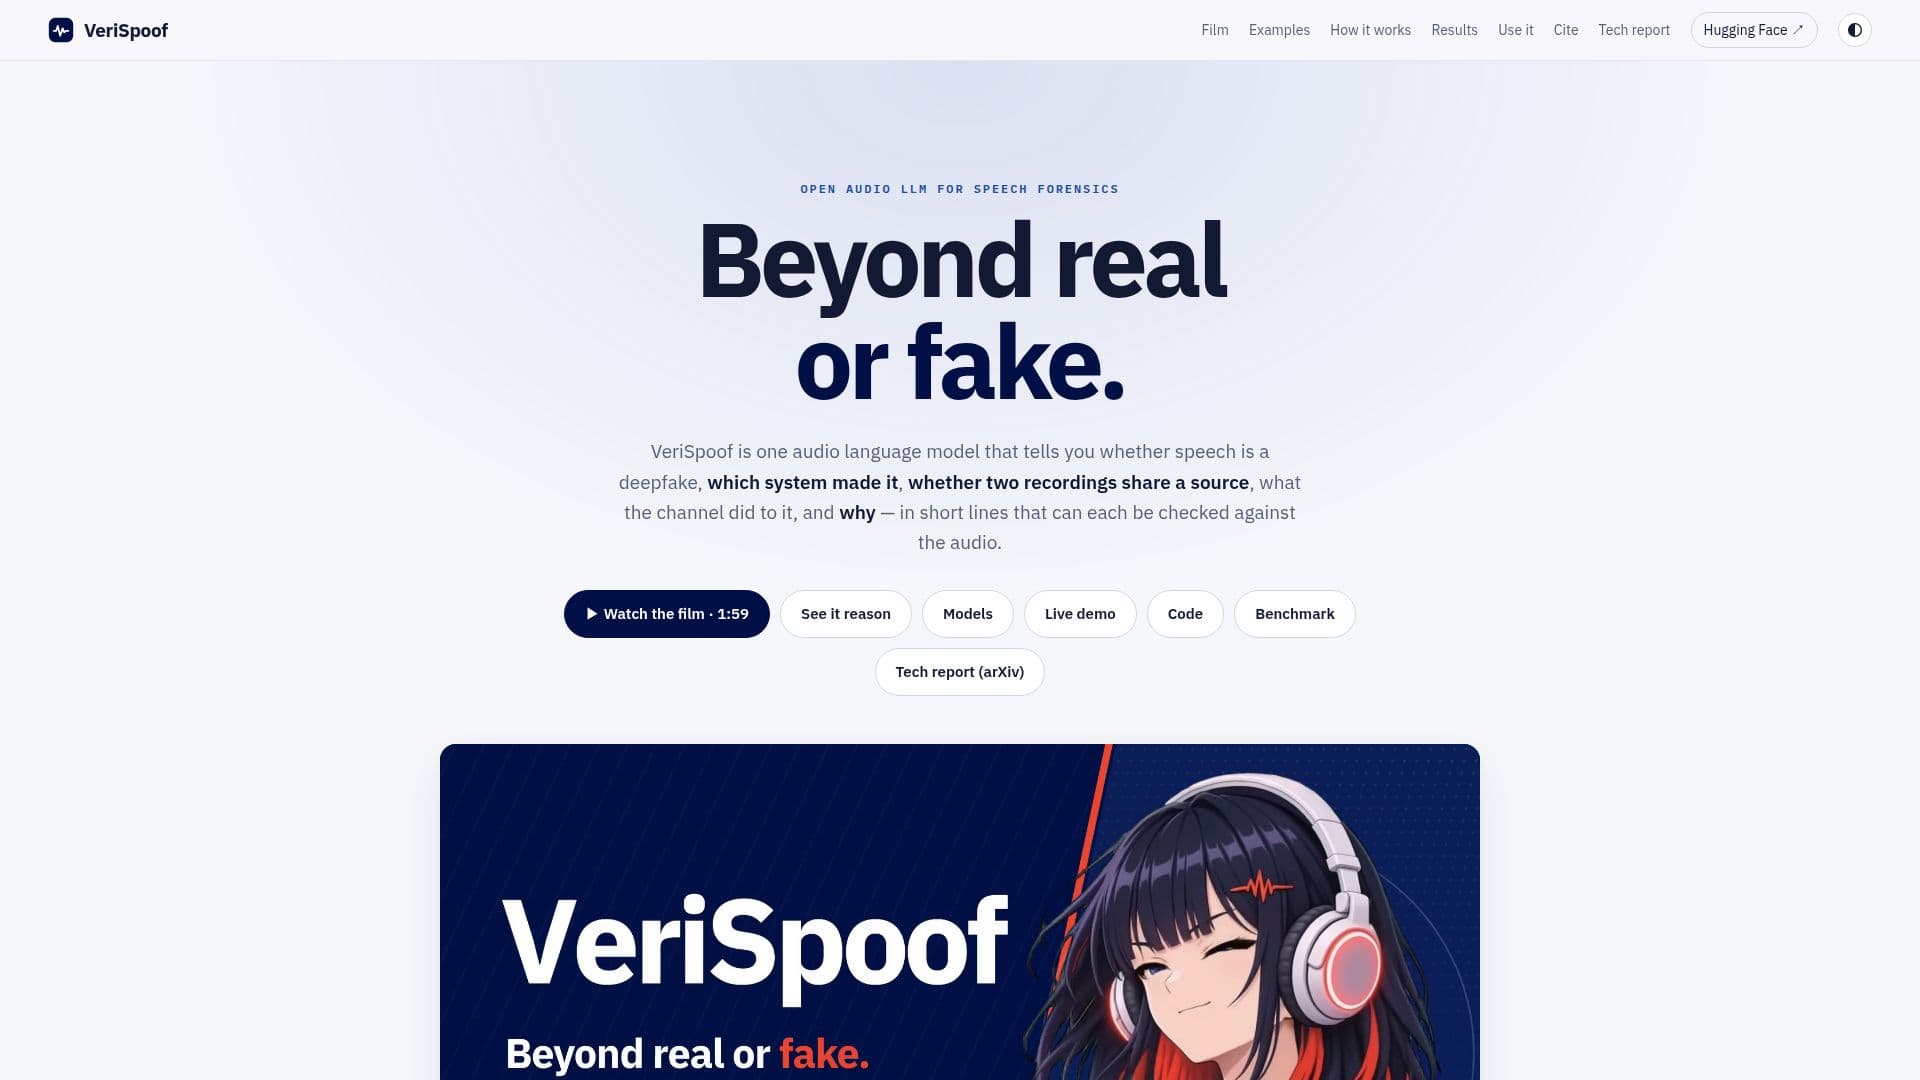
VeriSpoof est un modèle de langage audio pionnier développé pour la criminalistique avancée des deepfakes vocaux. Il fournit une solution complète pour déterminer si un discours est un deepfake, identifier le système qui l'a généré, évaluer si deux enregistrements partagent une source commune, analyser les effets des canaux et expliquer ses conclusions de manière transparente et vérifiable.
Lire la suite
Ce modèle audio LLM (Large Language Model) unifié fonctionne au-delà de simples classifications réelles ou fausses, offrant des informations détaillées sur l'origine et la manipulation de l'audio. Le modèle a démontré des performances exceptionnelles, atteignant un EER global de 2,14 % sur 14 ensembles de Speech-DF-Arena, le positionnant comme le détecteur à poids ouverts le mieux classé. Son architecture repose sur un LLM audio qui traite les enregistrements en tokens d'énonciation et de cadre, qui sont ensuite lus par un modèle MiniCPM5-2B avec LoRA. Contrairement aux systèmes traditionnels, VeriSpoof ne s'appuie pas sur des têtes de tâche séparées ; chaque réponse est une phrase dont la probabilité sert directement de score, permettant un seuil flexible à tout point d'exploitation.
La justification de VeriSpoof est une force fondamentale, chaque ligne de son raisonnement étant vérifiée indépendamment par rapport aux mesures d'onde, aux conditions enregistrées, aux intervalles étiquetés et aux métadonnées du générateur. Cela garantit que les observations, l'état du canal, la localisation des segments synthétisés et les profils de source sont rigoureusement validés. Le système intègre également un entraînement contrefactuel, où les décisions sont entraînées pour suivre les preuves déclarées, même lorsque la localisation est intentionnellement inversée, garantissant un raisonnement robuste et logiquement cohérent.
Destiné principalement à la recherche sur la détection des deepfakes, le traçage des sources et la criminalistique explicable, VeriSpoof fournit un outil puissant pour l'audit des verdicts audio. Il est recommandé de combiner ses scores avec d'autres preuves et un examen humain pour les décisions judiciaires finales. Le projet comprend à la fois un modèle de base et un modèle Plus, avec VeriSpoof-Plus démontrant des performances supérieures sur divers indicateurs d'évaluation et ensembles de données. Les poids et le code de VeriSpoof sont publiés sous une licence CC BY-NC 4.0, tandis que ses modèles de base, MiniCPM5-2B et Qwen3-ASR-1.7B, fonctionnent sous Apache-2.0.
- CatégorieDétecteurs de contenu IA
- Modèle tarifaireFree (Open-Weight)
- DéploiementLocal (Inference Package)
- PlateformesWindows, macOS, Linux
Fonctionnalités principales de VeriSpoof
Détection de Deepfake Vocal : Identifie si un discours est un deepfake.
Vérification de Source : Détermine quel système a généré le deepfake.
Attribution de Source : Établit si deux enregistrements proviennent du même générateur.
Description de Canal : Analyse et décrit les effets des canaux sur l'audio.
Décisions Explicables : Fournit de courtes lignes vérifiables expliquant ses conclusions.
Raisonnement Fondé : Chaque affirmation est vérifiée par rapport aux mesures d'onde et aux étiquettes de jeu de données.
Haute Précision : A atteint 2,14 % d'EER global sur Speech-DF-Arena, se classant #1 parmi les détecteurs à poids ouverts.
LLM Audio Unifié : Un modèle gère toutes les questions judiciaires sans têtes de tâche séparées.
Réponses Basées sur le Score : Les réponses sont des phrases dont la probabilité sert de score.
Tests Contrefactuels : Permet de remplacer la localisation déclarée pour réévaluer les décisions.
Inférence Hors Ligne : Prend en charge l'exécution d'enregistrements de test réels hors ligne.
Modèle à Poids Ouverts : Disponible pour la recherche et le développement.
Sous-titres Multilingues : Les démonstrations de films incluent des sous-titres en chinois et en anglais.
Orienté Recherche : Conçu pour la détection des deepfakes, le traçage des sources et la recherche en criminalistique explicable.
Verdicts Audités : Quatre lignes pour un verdict qui peuvent être auditées.
Comment utiliser VeriSpoof ?
Audio d'Entrée : Fournir un enregistrement audio unique ou une paire d'enregistrements au modèle.
Traitement avec LLM : Les composants audio convertissent l'entrée en tokens d'énonciation et de cadre pour le LLM.
Recevoir une Réponse Instantanée : Obtenir une réponse immédiate concernant le statut de deepfake ou la similarité de source.
Examiner le Raisonnement Fondé : Examiner l'explication détaillée, ligne par ligne, de la décision du modèle.
Vérifier les Affirmations : Vérifier chaque affirmation dans le raisonnement par rapport aux mesures d'onde et aux étiquettes de jeu de données.
Effectuer des Tests Contrefactuels : Optionnellement, modifier des paramètres comme la localisation et relancer le modèle pour observer les changements de décision.
Cas d'utilisation de VeriSpoof
- Recherche sur la Détection de Deepfake
- Traçage de Source Audio
- Criminalistique Explicable
- Analyse de Canal Audio
- Analyse de la Parole Synthétique
- Évaluation des Détecteurs de Deepfake