Description
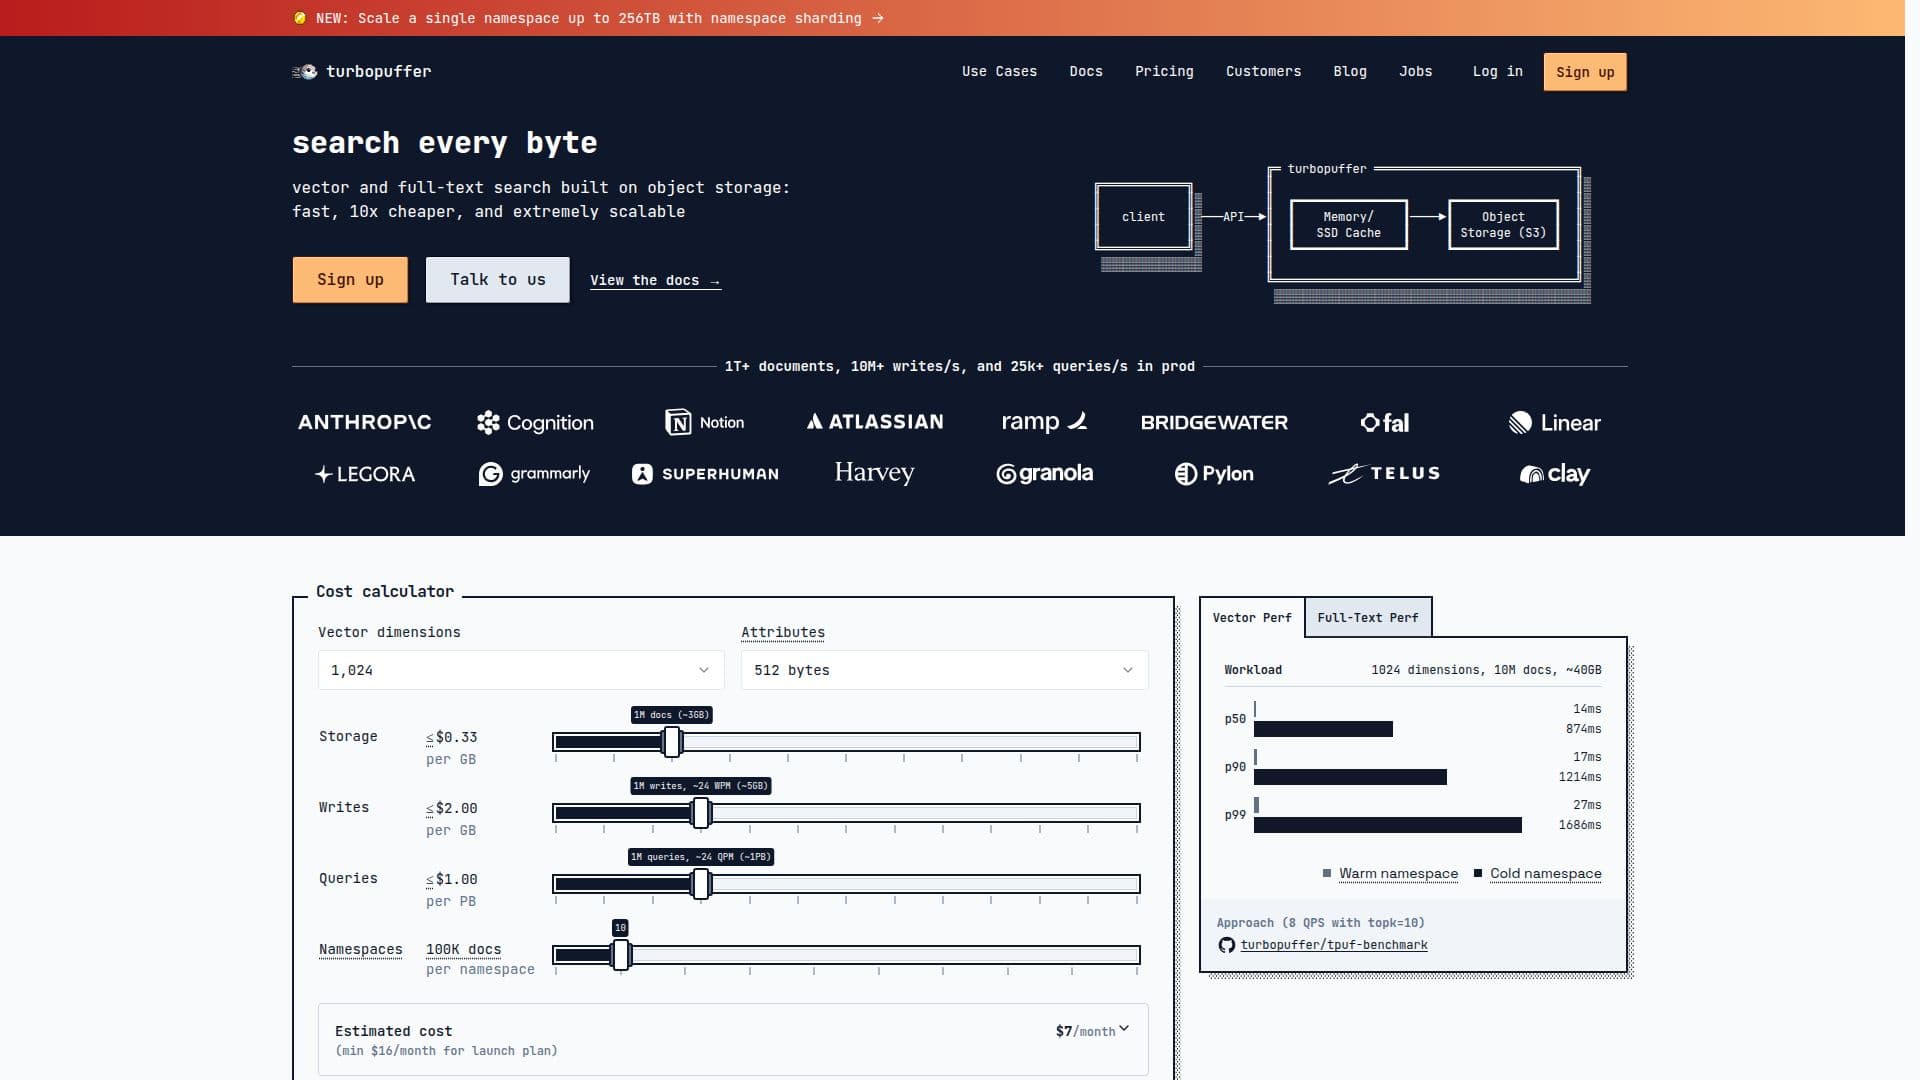
Turbopuffer est conçu pour rendre chaque octet consultable, fournissant un moteur de recherche rapide et évolutif basé sur le stockage d'objets. Il prend en charge la recherche vectorielle et en texte intégral, permettant aux utilisateurs de rechercher efficacement à travers d'énormes volumes de données. Avec la capacité de gérer plus de 1 trillion de documents, 10 millions d'écritures par seconde et 25 000 requêtes par seconde, turbopuffer est conçu pour des performances élevées et une fiabilité optimale.
Lire la suite
L'architecture de turbopuffer tire parti du stockage d'objets comme seule source de vérité, ce qui permet des économies de coûts significatives et une évolutivité. En séparant le calcul et le stockage, turbopuffer minimise la complexité opérationnelle tout en garantissant que les index de recherche peuvent évoluer automatiquement pour répondre à la demande. Cette approche unique permet aux utilisateurs de créer des espaces de noms isolés pour les données, garantissant une stricte isolation et sécurité des données, ce qui est particulièrement bénéfique pour des secteurs comme la santé et la finance.
Turbopuffer est particulièrement adapté aux organisations qui nécessitent des capacités de recherche rapides et fiables à travers de grands ensembles de données. Son design natif au stockage d'objets permet un indexage et une récupération efficaces, en faisant un excellent choix pour les applications qui doivent rechercher plus de 10 millions de documents. La plateforme prend également en charge une API unifiée pour divers types de recherche, y compris la recherche vectorielle dense et sparse, la recherche en texte intégral et la recherche regex, offrant ainsi une flexibilité pour les développeurs.
Avec un accent sur la performance, turbopuffer atteint des vitesses de requête élevées et une faible latence, en faisant un concurrent solide pour les entreprises cherchant à améliorer leurs capacités de récupération de données. Le modèle de tarification est basé sur l'utilisation, le rendant accessible aux organisations de toutes tailles, et il est conçu pour évoluer sans effort à mesure que les besoins en données augmentent. Dans l'ensemble, turbopuffer se distingue comme un outil puissant pour connecter l'IA avec de grandes quantités de données fraîches, permettant des solutions de recherche plus intelligentes et plus efficaces.
- CatégorieBases de données vectorielles et récupération
- Modèle tarifaireBasé sur l'utilisation
- DéploiementCloud
- PlateformesWeb
Fonctionnalités principales de turbopuffer
Recherche vectorielle avec un rappel >90%
Capacités de recherche en texte intégral
Recherche regex avec des index trigrammes rapides
Déploiements multi-locataires ou mono-locataires
Options de cryptage avec des clés contrôlées par le client
Espaces de noms illimités pour l'isolation des données
Débit d'écriture élevé de plus de 10M écritures/s
Gestion rapide des requêtes avec plus de 25k requêtes/s
Comment utiliser turbopuffer ?
Configurer : Configurez votre environnement turbopuffer et connectez-le à votre stockage d'objets.
Indexer : Écrivez vos documents dans turbopuffer pour créer des index consultables.
Interroger : Utilisez l'API unifiée pour effectuer des recherches à travers vos données indexées.
Optimiser : Ajustez les paramètres pour la performance des requêtes et la récupération des données selon vos besoins.
Cas d'utilisation de turbopuffer
- Recherche de documents
- Systèmes de recommandation
- Récupération de données pour l'IA
- Applications multi-locataires
- Recherche sur le web