Description
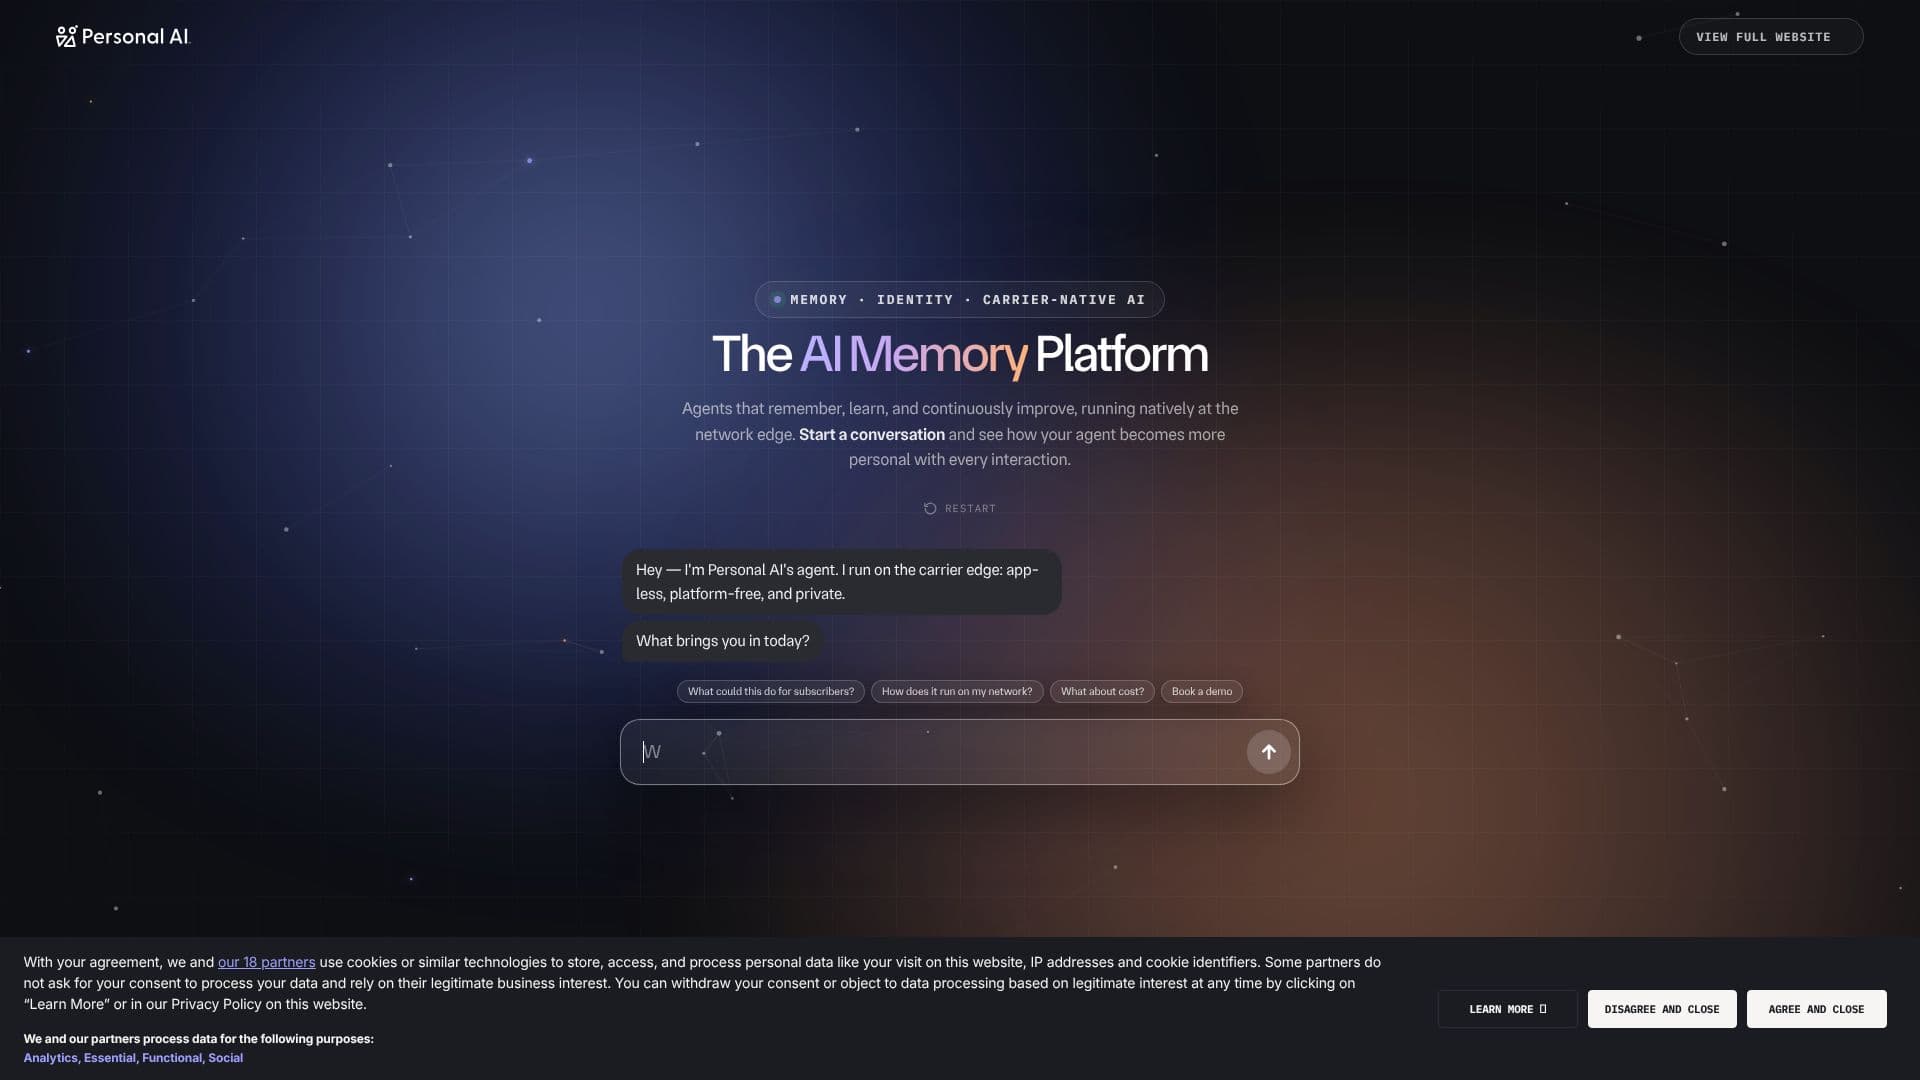
L'IA Personnelle a évolué d'une application de mémoire pour consommateurs vers une infrastructure de mémoire native au transporteur. Elle transforme chaque identité sur un réseau de télécommunications, un téléphone, un robot, une voiture ou un autre appareil connecté, en un agent IA évolutif, et considère ce qu'elle appelle des jetons comme un nouveau primitif aux côtés de la voix, du texte et des données sur le propre réseau du transporteur.
Lire la suite
La plateforme est construite autour d'une distinction entre mémoire, contexte et identité. La mémoire est personnelle : c'est ce qu'une IA a vécu, composée d'expériences et d'interactions avec une structure temporelle et épisodique qui s'accumule au fil du temps. Le contexte est universel : documents, bases de connaissances et téléchargements qui restent statiques. L'identité émerge de la mémoire au fil du temps plutôt que d'être configurée directement. Un Noyau de Mémoire construit sur cinq étapes de traitement, encodage, stabilisation, stockage, récupération et mise à jour, fonctionne à travers différents types de mémoire, y compris la mémoire épisodique, sémantique, de travail, relationnelle, temporelle et procédurale.
En plus de cette architecture, l'IA Personnelle offre une identité IA persistante qui devient plus personnelle avec l'utilisation ; une accélération de rappel qui s'ajoute aux pipelines de récupération existants d'une entreprise afin que le contexte soit récupéré uniquement lorsque nécessaire ; un encodage dynamique qui automatise le cycle de vie de la mémoire ; une gouvernance centralisée pour définir les permissions, l'accès et la politique de conservation ; et la portabilité, afin que la mémoire puisse se déplacer entre différents systèmes, agents et assistants au lieu de recommencer à zéro à chaque fois.
L'IA Personnelle rapporte des références de réseau de transporteur mesurées par rapport au trafic sur le réseau de Comcast : un temps de 15 millisecondes pour le premier jeton contre environ 1 000 millisecondes pour les références de LLM dans le cloud, 0,02 $ par million de jetons contre 0,80 $ pour Gemma-27B, et moins de 500 millisecondes de latence vocale de bout en bout contre environ 1 500 millisecondes pour le pipeline en temps réel d'OpenAI, couvrant la capture complète, la reconnaissance vocale, le modèle linguistique et le pipeline de synthèse vocale. Le produit est vendu aux opérateurs de télécommunications plutôt qu'aux utilisateurs individuels, ne nécessite aucune installation d'application sur l'appareil final, et les acheteurs s'engagent par le biais d'un briefing ou d'une conversation de vente avec le transporteur plutôt que par une inscription publique.
- CatégorieAssistants personnels IA
- Modèle tarifaireContacter les ventes
- DéploiementCloud
- PlateformesWeb
Fonctionnalités principales de IA Personnelle
Infrastructure de mémoire réseau de transporteur déployée par identité : téléphones, robots, voitures, appareils connectés
Identité IA persistante et évolutive construite à partir de la mémoire accumulée
Noyau de Mémoire avec une architecture en cinq étapes : encodage, stabilisation, stockage, récupération, mise à jour
Accélération de rappel superposée aux pipelines de récupération existants
Encodage dynamique qui automatise le cycle de vie de la mémoire
Gouvernance centralisée pour les permissions de mémoire, l'accès et la politique de conservation
Portabilité de la mémoire entre systèmes, agents et assistants
Inférence sur réseau à faible latence rapportée dans les références des transporteurs
Comment utiliser IA Personnelle ?
Réserver un briefing : Contacter l'IA Personnelle pour discuter d'un déploiement chez un transporteur.
Définir les identités : Décider quelles identités réseau, téléphones, robots, voitures ou autres appareils, obtiennent un Noyau de Mémoire.
Intégrer la mémoire : Connecter l'architecture de mémoire de l'IA Personnelle aux pipelines de récupération et d'agents existants en utilisant sa documentation pour développeurs.
Définir les règles de gouvernance : Configurer les permissions, l'accès et la politique de conservation pour la mémoire stockée.
Déployer et mesurer : Déployer l'inférence sur réseau et suivre la latence et le coût par rapport à une référence.
Cas d'utilisation de IA Personnelle
- Agents IA de transporteur
- Assistants vocaux en véhicule
- Robots et appareils connectés
- Portabilité de la mémoire entre agents