Description
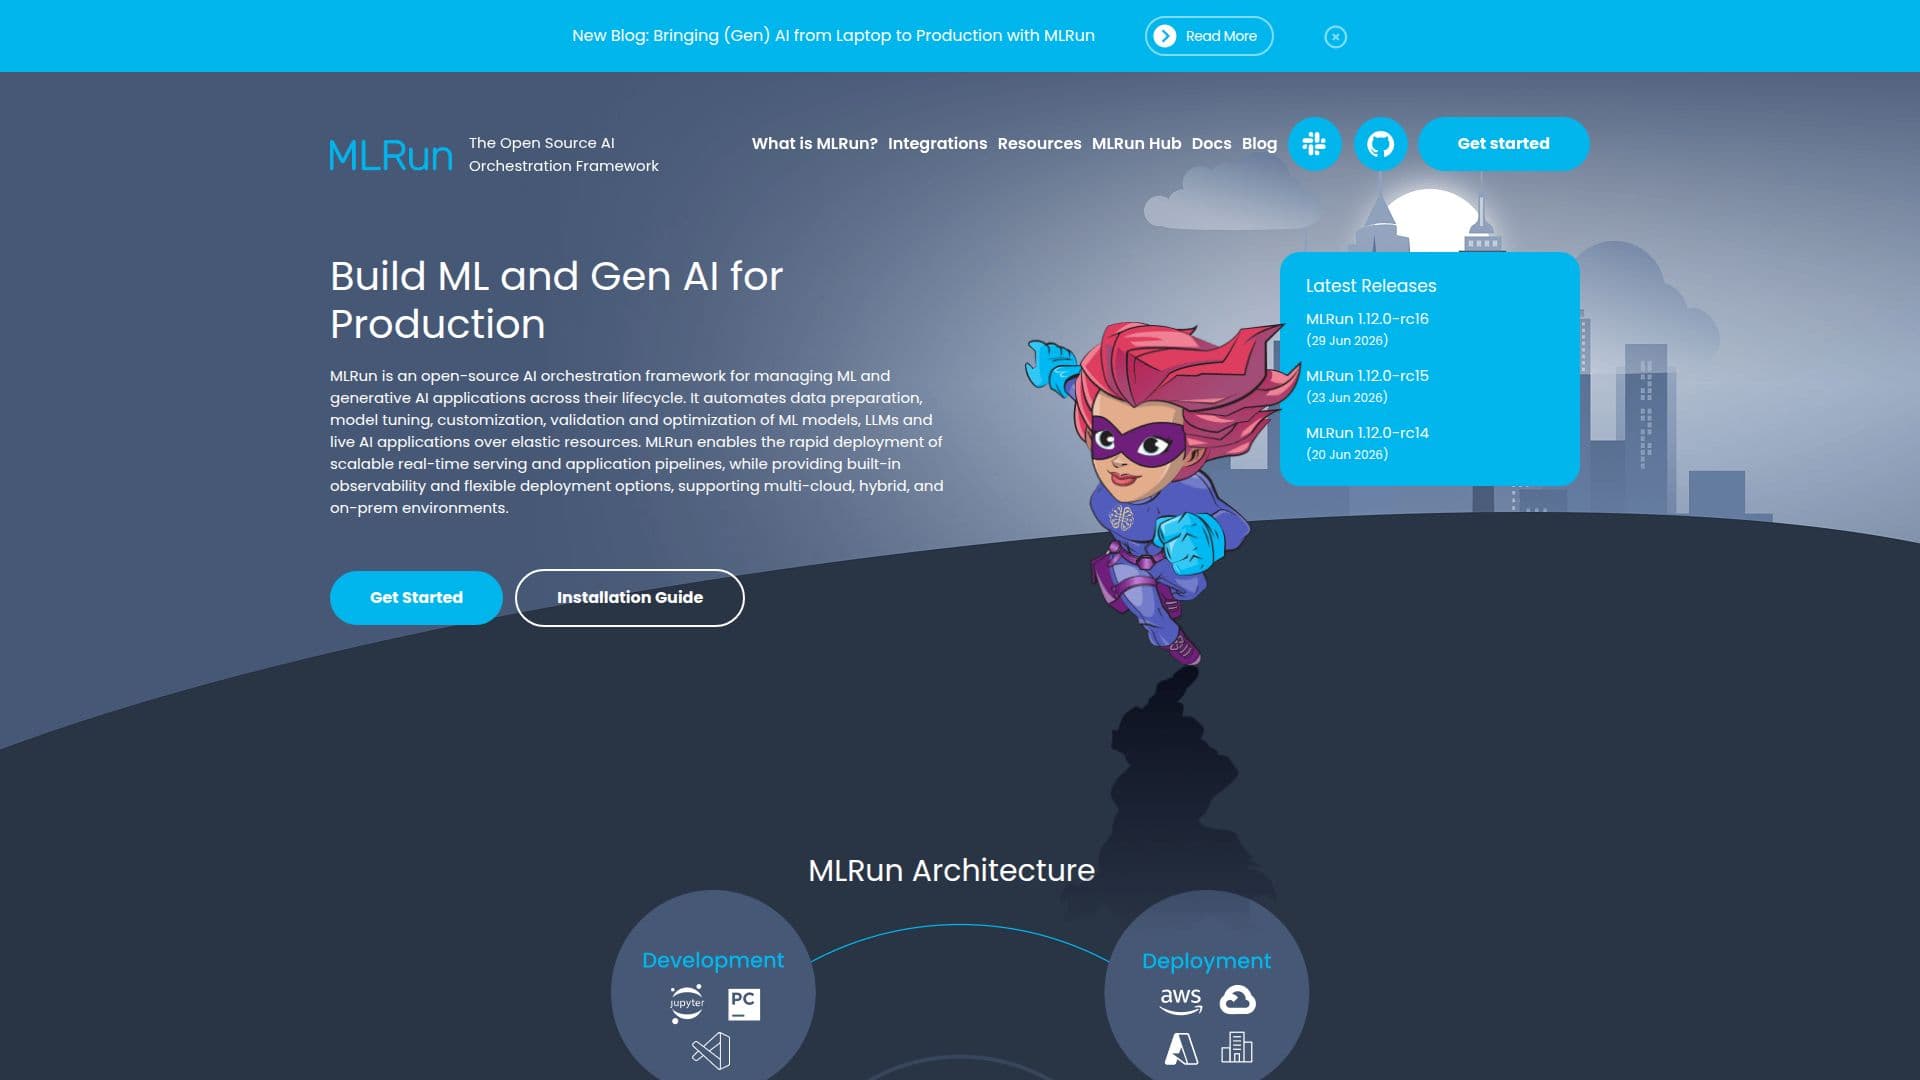
MLRun est un cadre d'orchestration AI open-source conçu pour gérer les applications d'apprentissage automatique (ML) et d'AI générative tout au long de leur cycle de vie. Il fournit une approche intégrative pour rationaliser les pipelines ML, des premières étapes de développement à la gestion en production. MLRun automatise divers processus, y compris la préparation des données, le réglage des modèles, la personnalisation, la validation et l'optimisation des modèles ML et des applications AI en direct sur des ressources élastiques.
La plateforme permet un déploiement rapide de services en temps réel évolutifs et de pipelines d'application, offrant une observabilité intégrée et des options de déploiement flexibles. Elle prend en charge les environnements multi-cloud, hybrides et sur site, permettant aux utilisateurs de déployer des charges de travail partout. L'architecture de MLRun est ouverte, prenant en charge tous les cadres principaux, les services ML gérés et les LLM, et s'intègre à tout service tiers.
MLRun réduit les efforts d'ingénierie en automatisant les pipelines AI de bout en bout, de l'entraînement et des tests au déploiement et à la gestion en production. Il permet le déploiement rapide de services en temps réel et de pipelines d'application, automatisant les pipelines d'entraînement et de test des modèles avec CI/CD. La plateforme génère également automatiquement des pipelines de données par lots et en temps réel, réduisant les coûts de calcul grâce à une utilisation optimisée des ressources et à une mise à l'échelle transparente des charges de travail.
La collaboration est une caractéristique clé de MLRun, car elle fournit une pile technologique unifiée pour les ingénieurs de données, les scientifiques des données et les ingénieurs en apprentissage automatique. Cela aide à briser les silos, à favoriser la réutilisation et le partage entre les rôles, et à réduire les temps de maintenance. MLRun met également l'accent sur une AI responsable avec un minimum d'ingénierie en suivant automatiquement les données, la lignée, les expériences et les modèles, et en surveillant les modèles, les ressources et les données en temps réel.
La plateforme offre une observabilité de bout en bout, permettant une gouvernance et une reproductibilité de haute qualité. Elle dispose d'un environnement d'exécution d'application sans serveur pour déployer des LLM avec une mentalité orientée production et inclut une passerelle LLM intégrée pour opérationnaliser et surveiller les LLM, permettant l'optimisation des coûts, la gestion des versions et l'observabilité au niveau des cas d'utilisation.
Fonctionnalités principales de MLRun
Cadre d'orchestration AI open-source
Automatise la préparation des données et le réglage des modèles
Prend en charge les environnements multi-cloud, hybrides et sur site
Déploiement rapide de services en temps réel évolutifs
Observabilité intégrée et options de déploiement flexibles
Automatisation des pipelines AI de bout en bout
Optimise l'utilisation des ressources pour réduire les coûts de calcul
Pile technologique unifiée pour la collaboration
Comment utiliser MLRun ?
Configurer : Configurez votre environnement client
Utiliser : Développez et déployez des applications AI
Optimiser : Surveillez et ajustez l'utilisation des ressources
Déployer : Utilisez des fonctions sans serveur pour le service en temps réel
Cas d'utilisation de MLRun
- Service en temps réel
- Réglage des modèles
- Préparation des données
- Collaboration
- Optimisation des coûts