Description
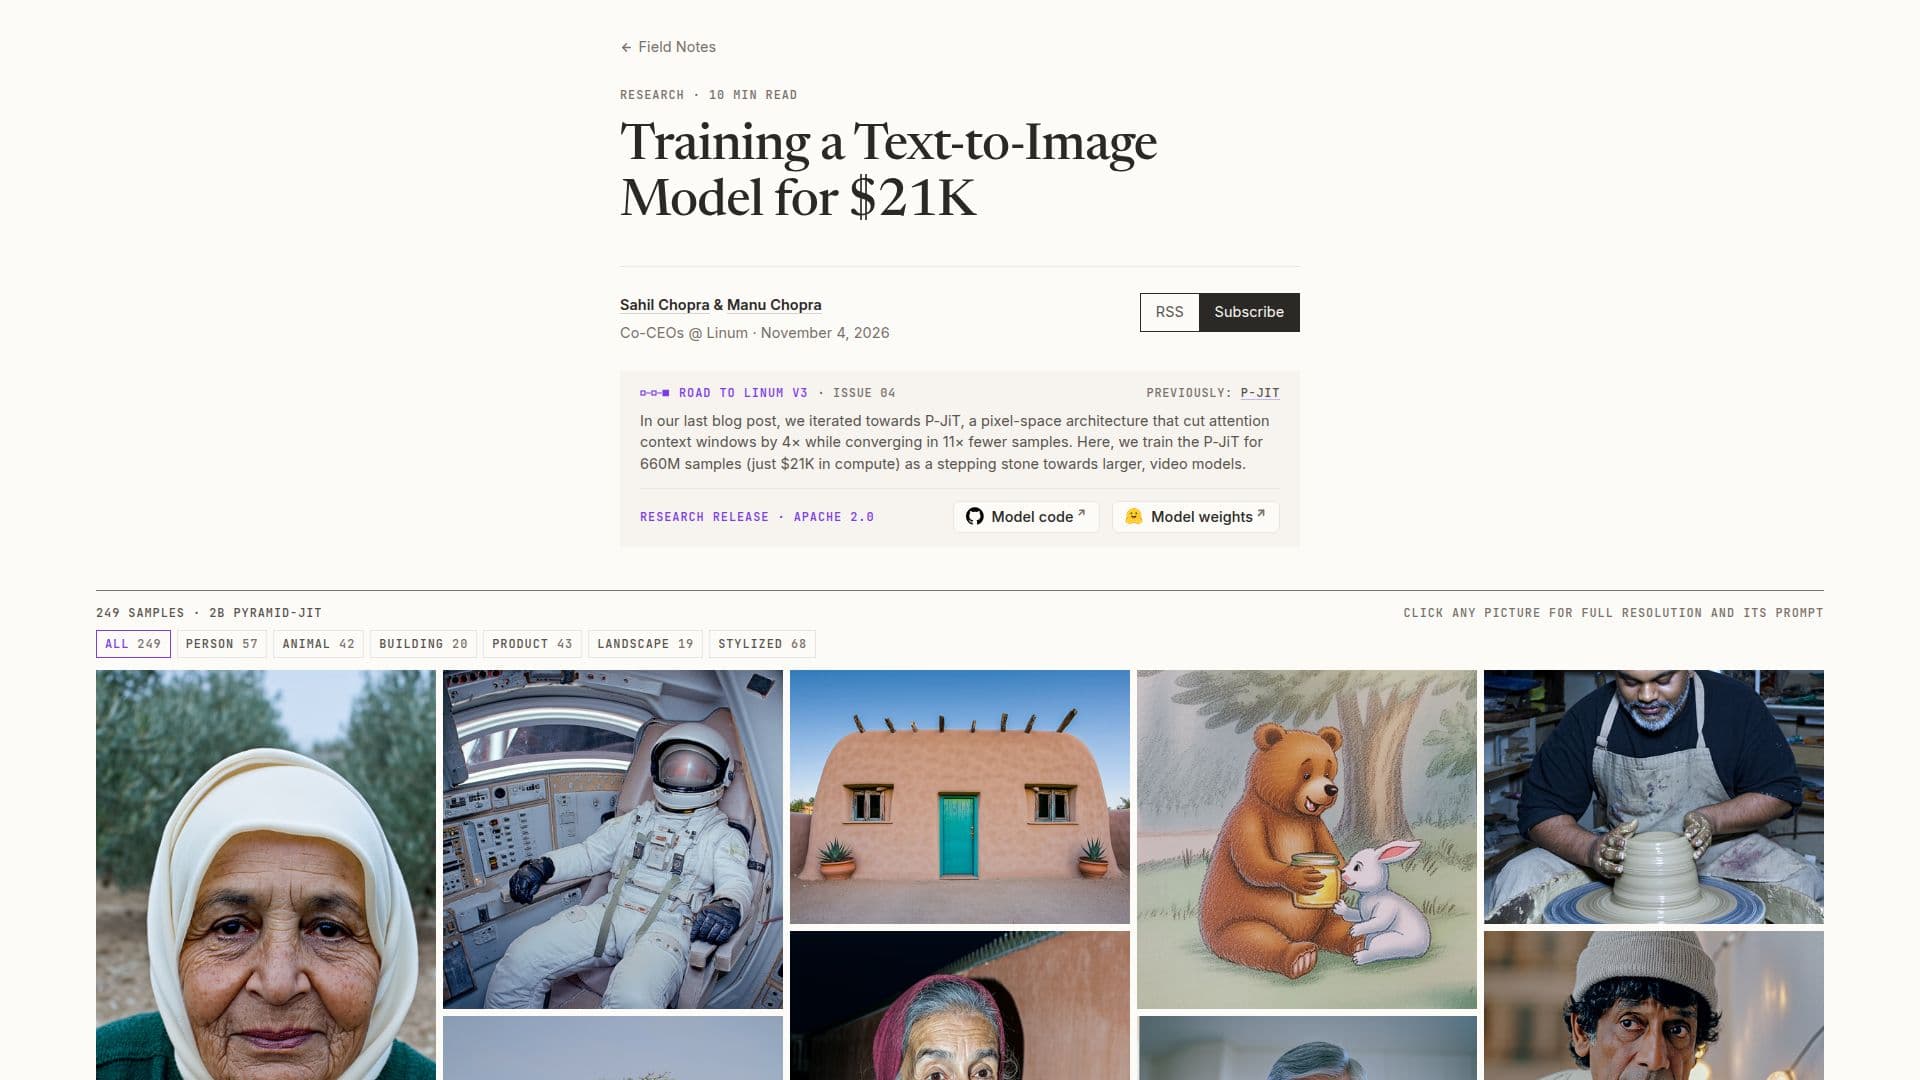
Linum P-JiT est un modèle expérimental de génération d'images à partir de texte développé par Linum, un laboratoire de recherche de deux personnes dédié à la formation de modèles vidéo génératifs à partir de zéro. Ce modèle particulier, un Pyramid-JiT (P-JiT) de 2 milliards de paramètres, sert de preuve de concept pour leurs recherches en cours visant à démocratiser l'accès à l'animation grâce à des outils génératifs rentables et contrôlables. Le coût d'entraînement de ce modèle était d'environ 21 038 $, démontrant le potentiel de résultats de haute qualité à un coût computationnel relativement bas.
Lire la suite
L'innovation centrale derrière P-JiT est sa capacité à réaliser une compression plus agressive et un apprentissage plus rapide en éliminant l'Autoencodeur Variationnel (VAE) traditionnel de l'architecture du modèle de diffusion. Au lieu de cela, le modèle de diffusion apprend un espace latent spécialement conçu pour son cas d'utilisation, permettant une plus grande compression et une génération améliorée. Ce modèle dans l'espace pixel converge avec 11 fois moins d'échantillons que Linum v2 et offre une réduction de tokens quatre fois plus agressive, représentant une image de 512x512 avec le même nombre de tokens précédemment utilisés pour une image de 256x256. Cela se traduit par une réduction quadruple de la fenêtre de contexte d'attention, réduisant considérablement les coûts d'entraînement et d'inférence.
L'architecture P-JiT intègre un pipeline de traitement de texte et d'image, où chaque modalité passe par des blocs DiT « raffineurs » à modalité unique avant de fusionner en un flux de 22 blocs DiT identiques. La représentation textuelle est dérivée d'un modèle Qwen3.5-4B gelé, tandis que les images sont divisées en patchs de 32x32 et compressées dans un espace de 1024 dimensions. Le modèle dispose également de lectures PixelREPA alignées sur DINOv3-L et de têtes de lecture linéaires supplémentaires le long du tronc pour accélérer la convergence en prédisant des versions basse résolution de l'image finale.
L'entraînement a été réalisé en plusieurs étapes, commençant par une résolution de 512x512 pour 610 millions d'échantillons, puis passant à une résolution de 1024x1024 pour 50 millions d'échantillons. Un curriculum sur le programme de bruit a été employé, se concentrant initialement sur un bruit élevé pour apprendre la structure de base, puis élargissant la distribution pour des détails fins. Après l'entraînement, une variante de l'Optimisation par Différences Finies (FDFO) avec JEV-Image et des juges humains a été utilisée. Bien que le modèle montre des résultats prometteurs, il présente des limitations, notamment en matière de génération de corps entier, d'entités multiples, d'interactions entre plusieurs personnes et de connaissances générales, qui sont courantes pour des modèles de sa taille. Il n'a pas été entraîné avec des images de texte rendu, ne pouvant donc pas générer de texte ou d'affiches.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud
- PlateformesWeb
Fonctionnalités principales de Linum P-JiT
Architecture Pyramid-JiT (P-JiT) : Modèle pixel-space novateur pour une génération efficace
DiT à 2 milliards de paramètres : Taille du modèle de transformateur de diffusion central
Encodeur de texte à 4 milliards : Utilise un modèle Qwen3.5-4B gelé pour la représentation textuelle
Conception sans VAE : Élimine le VAE pour une compression plus agressive et un apprentissage plus rapide
Réduction de tokens 4x : Représente des images de 512x512 avec 4x moins de tokens que Linum v2
Convergence 11x plus rapide : Obtient des résultats avec significativement moins d'échantillons d'entraînement
Entraînement en plusieurs étapes : Progresse de la résolution 512x512 à 1024x1024
Programme de bruit de curriculum : Adapte la distribution du bruit pour l'apprentissage de la structure et des détails
Lectures PixelREPA : Aligne l'espace latent sur DINOv3-L pour un apprentissage des détails amélioré
Têtes de lecture linéaires : Prédit des images nettes à un quart et à une demi-résolution pour une convergence accélérée
Optimisation par Différences Finies (FDFO) : Utilisée pour le raffinement post-entraînement
Licence Apache 2.0 : Les poids sont publiés sous une licence open-source
Entraînement rentable : A obtenu des résultats de haute qualité pour environ 21 000 $
Focus sur la recherche vidéo générative : Une étape vers les futurs modèles vidéo
Comment utiliser Linum P-JiT ?
Comprendre l'architecture : Examinez les détails de l'architecture P-JiT, y compris les flux de traitement de texte et d'image.
Examiner le régime d'entraînement : Apprenez-en davantage sur le processus d'entraînement en plusieurs étapes, les programmes de bruit et les transitions de résolution.
Explorer les limitations du modèle : Comprenez les limitations actuelles concernant la génération de corps entier, les entités multiples et la génération de texte.
Accéder aux paramètres d'entraînement : Consultez l'Annexe A pour les paramètres et configurations d'entraînement détaillés.
Revoir la répartition des coûts : Consultez la répartition des coûts de calcul avant et après l'entraînement.
Analyser les échecs d'exemple : Étudiez les exemples fournis d'échecs du modèle pour saisir les capacités actuelles et les domaines à améliorer.
Cas d'utilisation de Linum P-JiT
- Recherche sur la génération d'images à partir de texte
- Entraînement de modèles rentable
- Développement de modèles vidéo génératifs
- Test d'innovation architecturale
- Expérimentation en IA open-source