Description
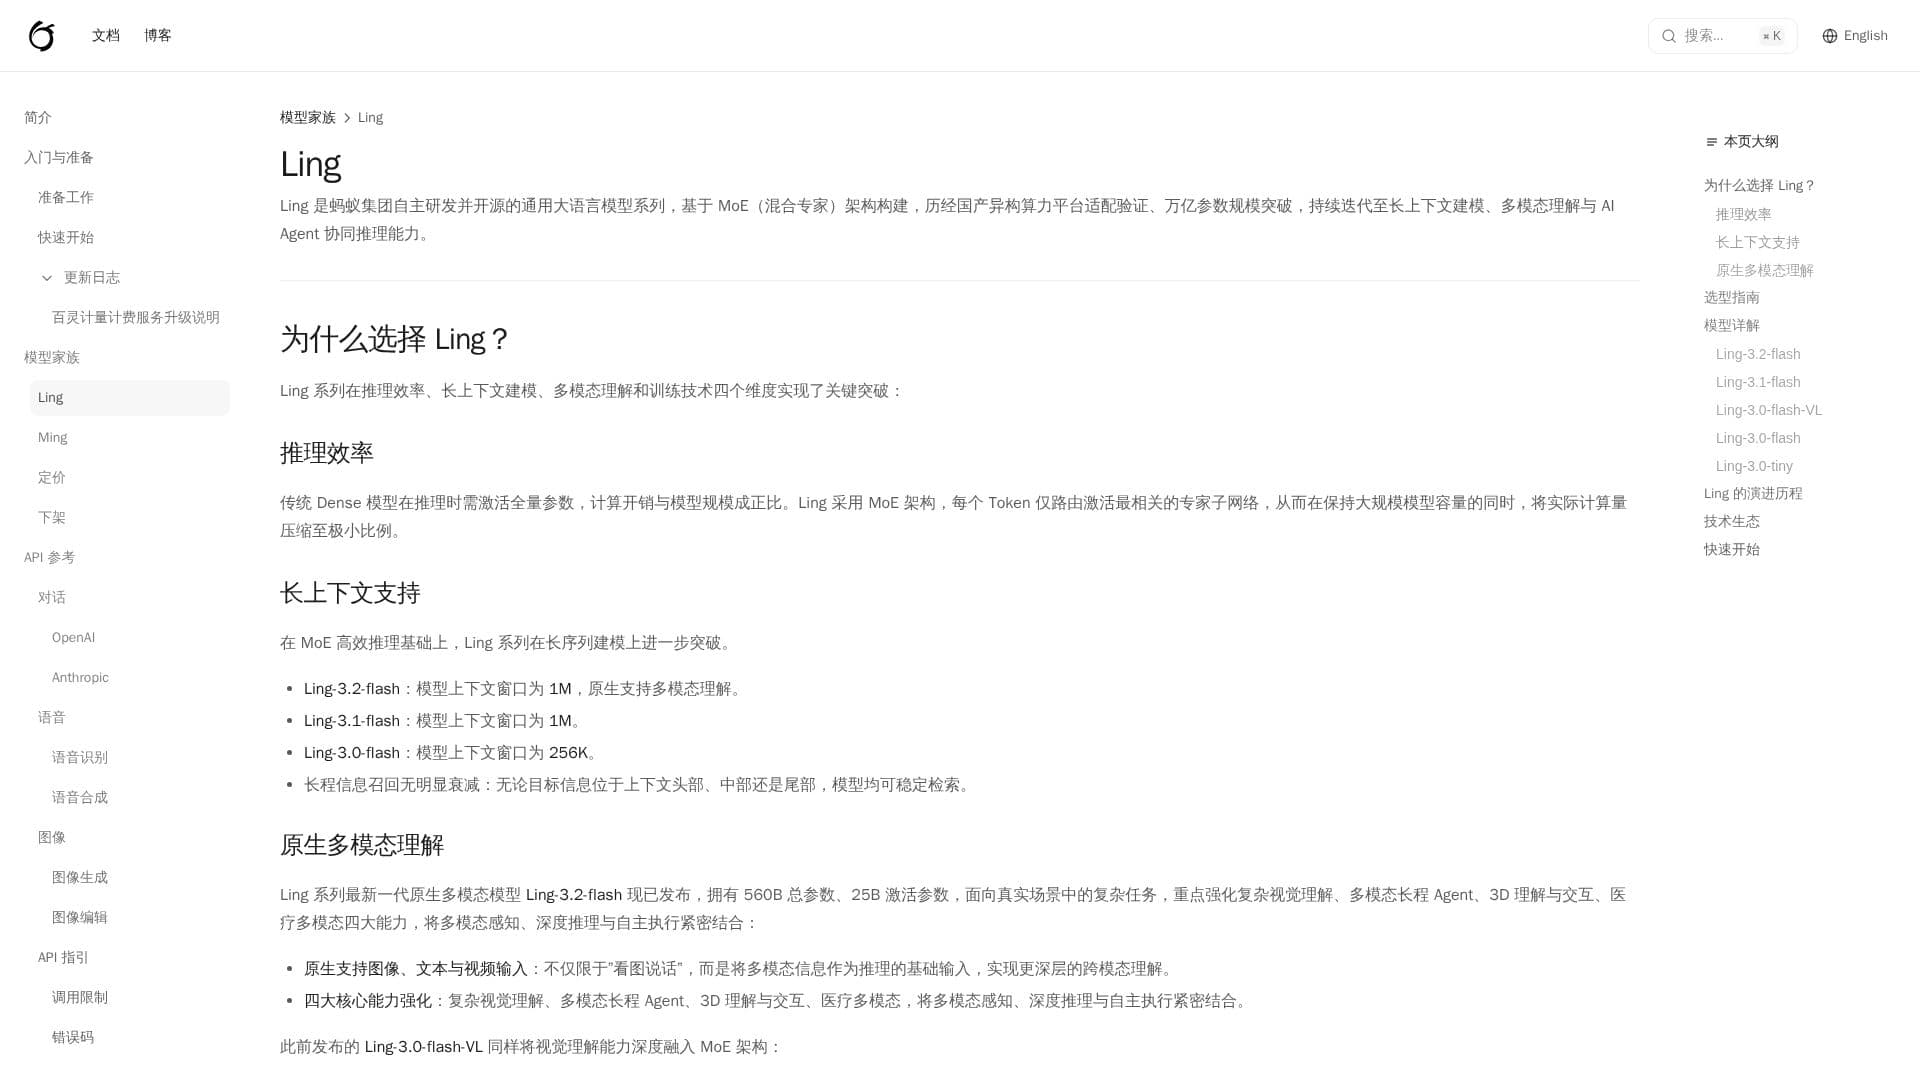
Ling est une série de modèles de langage de grande taille à usage général développée et open-sourcée par Ant Group. Ces modèles reposent sur une architecture de Mixture-of-Experts (MoE), ce qui leur permet d'atteindre une grande capacité tout en maintenant des coûts computationnels faibles lors de l'inférence. Ce design garantit que seuls les sous-réseaux d'experts les plus pertinents sont activés pour chaque jeton, réduisant ainsi considérablement le calcul réel requis par rapport aux modèles denses traditionnels.
Lire la suite
La série Ling a subi un développement approfondi, y compris l'adaptation et la vérification sur des plateformes de calcul hétérogènes domestiques et des percées à l'échelle des trillions de paramètres. Les modèles itèrent continuellement pour améliorer des capacités telles que la modélisation de long contexte, la compréhension multimodale et le raisonnement collaboratif d'agent IA. Les avancées clés incluent le support pour des fenêtres de contexte allant jusqu'à 1M de jetons, garantissant une récupération d'informations stable à travers de longues séquences sans dégradation significative.
Ling offre une compréhension multimodale native, avec sa dernière génération, Ling-3.2-flash, prenant en charge les entrées d'image, de texte et de vidéo. Ce modèle, avec 560 milliards de paramètres au total et 25 milliards de paramètres activés, est conçu pour des tâches complexes du monde réel, renforçant les capacités en compréhension visuelle complexe, agents multimodaux à longue portée, compréhension et interaction 3D, et applications multimodales médicales. Il intègre la perception multimodale, le raisonnement profond et l'exécution autonome.
La famille de modèles comprend plusieurs versions adaptées à différents besoins. Ling-3.2-flash est le dernier modèle multimodal natif, idéal pour des tâches visuelles et d'agent complexes. Ling-3.1-flash est optimisé pour des tâches de long processus et des scénarios d'agent, adapté au travail de bureau quotidien, au développement logiciel à long terme et aux tâches complexes d'agent. Ling-3.0-flash-VL est un modèle multimodal natif avec un mécanisme de boucle de rétroaction visuelle, améliorant la fiabilité dans des tâches telles que l'interprétation de rapports médicaux et l'automatisation d'interface utilisateur. Ling-3.0-flash est un modèle économique et rapide pour des tâches à haute fréquence, offrant des temps de réponse rapides et un appel d'outils stable. Ling-3.0-tiny est un modèle léger conçu pour le déploiement en périphérie et le fonctionnement hors ligne, adapté à l'interaction en temps réel et aux environnements à ressources limitées.
Les modèles Ling sont disponibles via API, prenant en charge à la fois les protocoles OpenAI et Anthropic, facilitant l'intégration dans divers outils de programmation IA et cadres d'agents. La tarification est basée sur la consommation, calculée par jeton, avec des remises promotionnelles et un niveau gratuit quotidien de 500 000 jetons (ou un coupon de déduction de 10 RMB par mois après une mise à niveau du système de facturation). Les utilisateurs d'entreprise peuvent contacter le service client pour des limites QPS plus élevées et des ressources dédiées. Le projet favorise également une communauté open-source, partageant les résultats de recherche via Inclusion AI.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireÀ l'usage
- DéploiementCloud, Edge, Local Offline
- PlateformesWeb
Fonctionnalités principales de Ling
Architecture MoE (Mixture-of-Experts) pour une inférence efficace
Modélisation de long contexte avec support de fenêtre jusqu'à 1M de jetons
Compréhension multimodale native pour les entrées d'image, de texte et de vidéo
Capacités de compréhension visuelle complexe
Capacités d'agent multimodal à longue portée
Compréhension et interaction 3D
Analyse multimodale médicale et interprétation de rapports
Mécanisme de boucle de rétroaction visuelle pour auto-correction
Inférence à haut débit et faible latence (jusqu'à 1000 jetons/s)
Support pour le déploiement en périphérie et le fonctionnement local hors ligne
Capacités d'automatisation d'utilisation d'outils et d'interface utilisateur
Résultats de recherche open-source via la communauté Inclusion AI
Accès API compatible avec les protocoles OpenAI et Anthropic
Tarification basée sur la consommation avec allocations de jetons gratuites quotidiennes/mensuelles
Optimisé pour diverses tâches, y compris l'automatisation de bureau, le développement logiciel et le conseil professionnel
Comment utiliser Ling ?
Obtenir une clé API : Obtenez des identifiants d'accès depuis la console API après avoir lié un compte Alipay.
Faire le premier appel : Complétez votre première demande API en utilisant un SDK compatible OpenAI ou des requêtes HTTP.
Sélectionner un modèle : Choisissez parmi Ling-3.2-flash, Ling-3.1-flash, Ling-3.0-flash-VL, Ling-3.0-flash ou Ling-3.0-tiny en fonction des exigences de la tâche.
Intégrer : Connectez les modèles Ling à des outils de programmation IA comme Claude Code, OpenClaw, Kilo Code ou Hermes Agent.
Développer des applications : Utilisez les capacités de Ling pour des tâches telles que la compréhension visuelle complexe, l'exécution d'agents à longue portée ou l'automatisation de bureau.
Surveiller l'utilisation : Suivez la consommation de jetons et gérez la facturation via le panneau de contrôle Ling.
Cas d'utilisation de Ling
- Compréhension Visuelle Complexe
- Agents Multimodaux à Longue Portée
- Compréhension et Interaction 3D
- Analyse Multimodale Médicale
- Automatisation de Bureau Quotidienne
- Tâches de Développement Logiciel
- Consultation et Analyse Professionnelle
- Programmation avec Rétroaction Visuelle
- Automatisation d'Interface Utilisateur
- Apprentissage Vidéo en Temps Réel
- Traitement de Données à Haute Concurrence
- Déploiement sur Dispositifs Périphériques