Description
Forms That Read Themselves introduit une évaluation complète de douze lecteurs différents pour les formulaires scannés, allant des API de vision à la pointe de la technologie à un modèle personnalisé de 2B paramètres affiné spécifiquement à cet effet. L'offre principale est un petit modèle de vision que les utilisateurs peuvent posséder et exploiter, fournissant une alternative économique aux solutions commerciales telles qu'Azure Document Intelligence.
Lire la suite
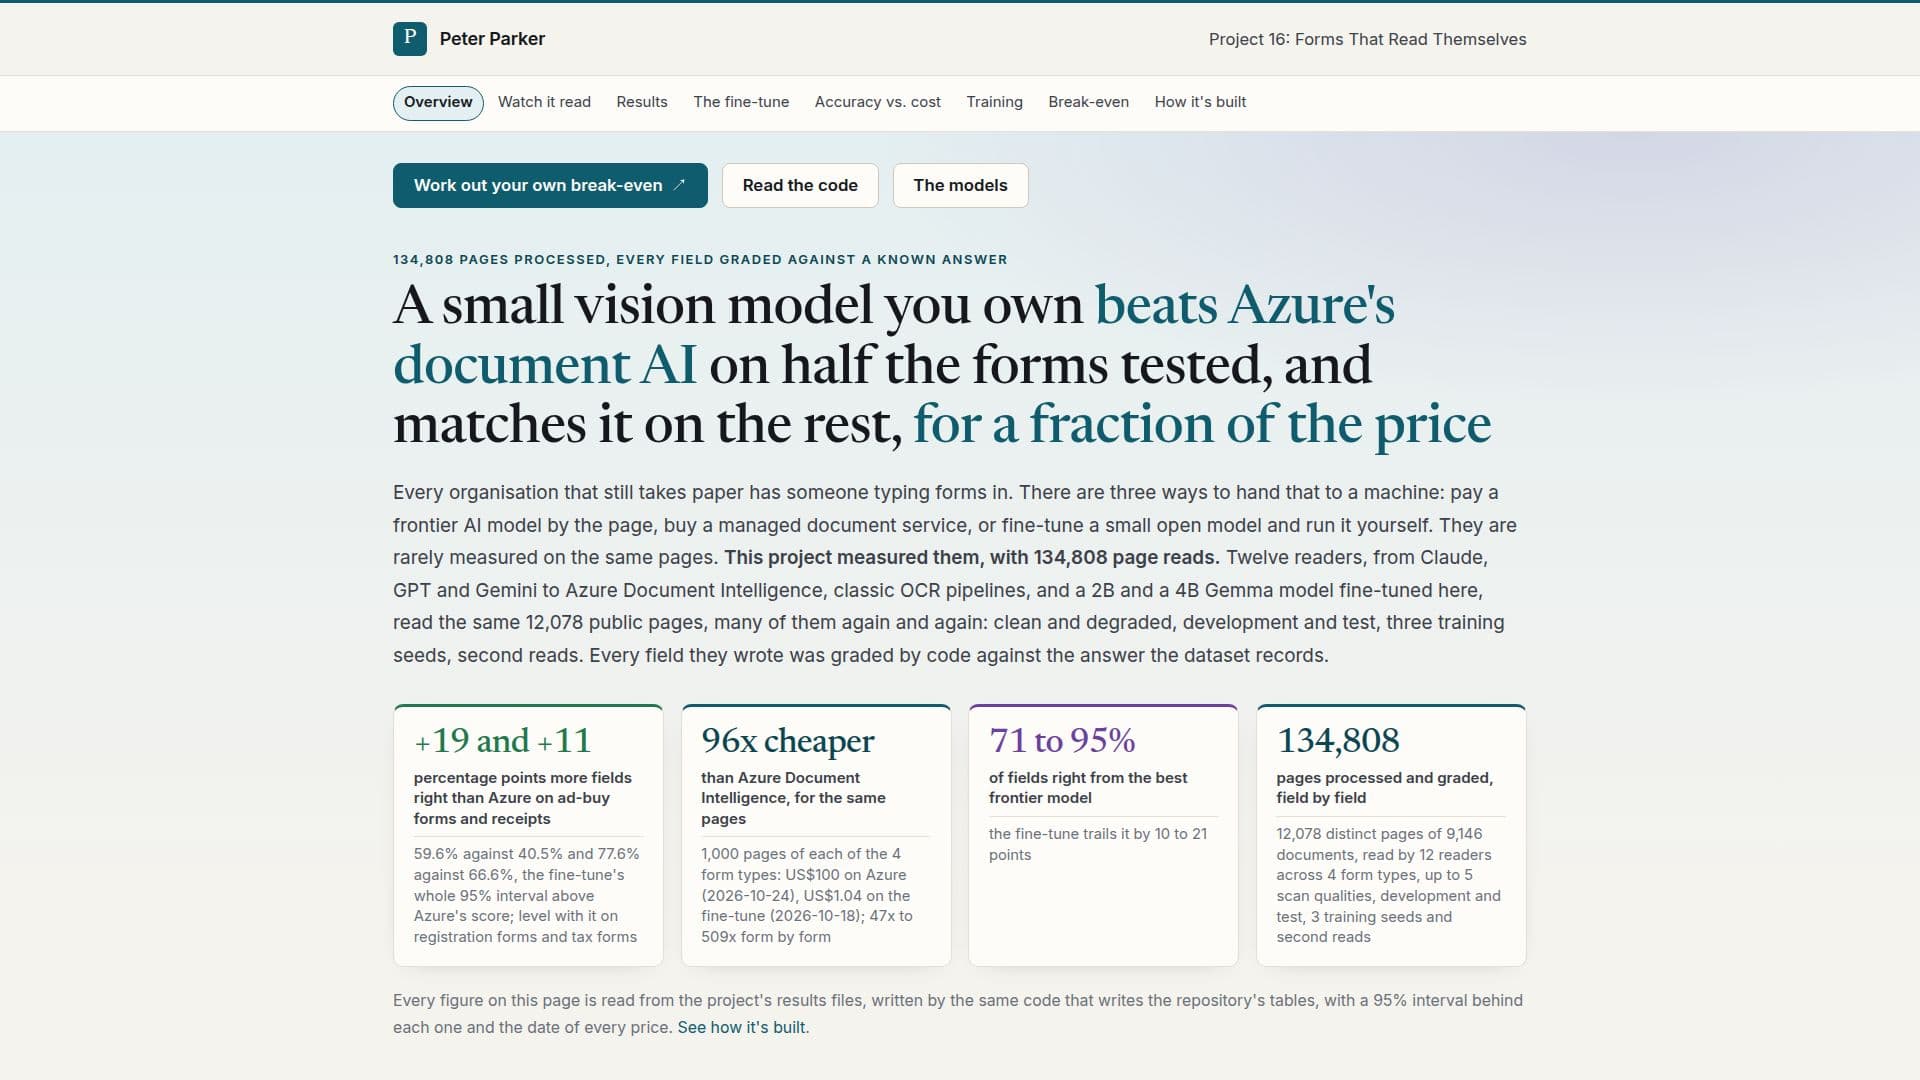
La plateforme évalue méticuleusement chaque lecteur champ par champ sur des ensembles de données publics avec des réponses connues, y compris la NIST Special Database 2 pour les formulaires fiscaux américains de 1988, les dépôts de la Foreign Agents Registration Act, les commandes de publicité politique de la FCC et les reçus CORD v2. Ce benchmarking rigoureux révèle que le modèle affiné surpasse Azure Document Intelligence sur la moitié des types de formulaires testés et égalise ses performances sur le reste, tout en fonctionnant à une fraction du prix. Par exemple, sur les formulaires d'achat publicitaire, le modèle affiné atteint 59,6 % de précision contre 40,5 % pour Azure, et sur les reçus, 77,6 % contre 66,6 %.
Une découverte clé est l'impact transformateur de l'affinage sur les modèles plus petits. Les modèles non affinés comme Gemma 4 E2B montrent une précision significativement inférieure (par exemple, 15,0 % sur les formulaires fiscaux), qui s'améliore de manière spectaculaire à 73,6 % après affinage. Ce processus, qui peut prendre aussi peu que 8 minutes à 4,9 heures sur un GPU loué, rend ces modèles plus petits très compétitifs. Le modèle affiné démontre également un taux d'invention de valeurs inférieur par rapport aux modèles de pointe sur certains types de formulaires, tels que les formulaires d'inscription et les reçus, ce qui est crucial pour les applications où un champ vide est préférable à une entrée confiante mais incorrecte.
Bien que les modèles de vision de pointe comme GPT-6.1 Sol et Gemini 3.8 Flash atteignent généralement une précision plus élevée, le modèle affiné offre un équilibre convaincant entre performance et coût. Par exemple, sur les reçus, il atteint 77,6 % de précision pour 0,16 $ par mille pages, contre 76,7 % pour Claude Haiku 5.5 pour 0,38 $. Un avantage significatif de posséder et d'exécuter le modèle sur un GPU grand public est l'amélioration de la confidentialité des données, car aucune page n'a besoin de quitter le réseau de l'utilisateur.
Le projet met également en évidence la robustesse des modèles de vision contre la dégradation des scans. Contrairement aux pipelines basés sur l'OCR, qui souffrent de chutes drastiques de précision avec une mauvaise qualité de scan, les modèles de vision lisant directement les pixels maintiennent une haute performance. Cependant, il est important de noter qu'aucun lecteur n'a atteint 99 % de précision sur tous les champs, ce qui signifie que la vérification humaine reste nécessaire pour les applications critiques. Les modèles automatisent principalement le processus de saisie, pas la vérification finale.
L'architecture implique l'entraînement des modèles Gemma 4 E2B et E4B à poids ouverts en utilisant QLoRA, en gelant les poids du modèle de base en 4 bits tout en entraînant de petites matrices d'adaptateurs. Ces adaptateurs sont servis avec vLLM sur un GPU RTX 3090, permettant un déploiement efficace sur site. Le site fournit un calculateur pour déterminer le point d'équilibre entre les coûts d'API et la location de GPU, soulignant que le coût réel d'un modèle détenu dépend de son utilisation.
- CatégorieOutils de vision par ordinateur
- Modèle tarifaireGPU Rental Cost
- DéploiementSur site
- PlateformesWeb
Fonctionnalités principales de Forms That Read Themselves
Modèles de vision affinés pour l'extraction de formulaires scannés
Évaluation par rapport aux API de vision de pointe (GPT-6.1 Sol, Claude Sonnet, Gemini Flash)
Comparaison avec Azure Document Intelligence
Support pour divers types de formulaires : inscription, achat publicitaire, reçus, formulaires fiscaux
Évaluation de la précision champ par champ sur des ensembles de données publics
Alternative économique aux API commerciales
Capacité de déploiement sur site sur des GPU grand public (par exemple, RTX 3090)
Réduction de l'invention de valeurs sur certains types de formulaires
Robustesse contre la dégradation des scans (bruit, flou, inclinaison, contraste perdu)
Métriques de performance détaillées incluant les champs corrects et le coût par mille pages
Modèles de base à poids ouverts (Gemma 4 E2B, E4B) utilisés pour l'affinage
Recette d'affinage QLoRA pour un entraînement efficace sur des GPU uniques
vLLM pour servir les modèles affinés
Calculateur pour l'analyse du point d'équilibre entre les coûts d'API et de GPU détenu
Confidentialité des données en gardant les pages dans votre réseau
Comment utiliser Forms That Read Themselves ?
Sélectionner un lecteur : Choisissez parmi divers modèles de vision ou pipelines OCR pour comparer leurs performances.
Ajuster la qualité du scan : Simulez différents niveaux de dégradation (bruit, flou, inclinaison, contraste perdu) pour observer l'impact sur la précision.
Examiner les résultats champ par champ : Voir quels champs chaque lecteur extrait correctement, marqués en vert, et lesquels sont incorrects, marqués en rouge et en pointillés.
Analyser la précision et le coût : Comparez la part de champs corrects et le coût par mille pages pour différents lecteurs et types de formulaires.
Comprendre l'impact de l'affinage : Observez comment l'affinage améliore significativement la précision des modèles plus petits sur des types de formulaires spécifiques.
Évaluer les coûts de déploiement : Utilisez le calculateur fourni pour déterminer la viabilité économique de la location d'un GPU par rapport à l'utilisation d'API commerciales en fonction de votre volume.
Accéder aux adaptateurs : Téléchargez les adaptateurs affinés disponibles pour les reçus, les formulaires d'achat publicitaire et les formulaires fiscaux depuis Hugging Face.
Cas d'utilisation de Forms That Read Themselves
- Extraction automatisée de données de formulaires
- Traitement de documents économique
- Traitement de données sur site
- Évaluation des modèles de vision AI
- Amélioration de la précision de l'OCR
- Développement de modèles personnalisés