Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

evalship

evalship fournit un contrôle de qualité pour les évaluations de LLM, identifiant les défauts et optimisant les invites et les modèles. Il s'intègre aux frameworks d'évaluation existants, commente les demandes de tirage avec des analyses détaillées de ce qui a échoué et pourquoi, et aide à garantir que les appels d'IA sont soigneusement testés. La plateforme vise à automatiser vos évaluations de LLM, améliorant la fiabilité et la performance.

Visiter l'URL
Partager
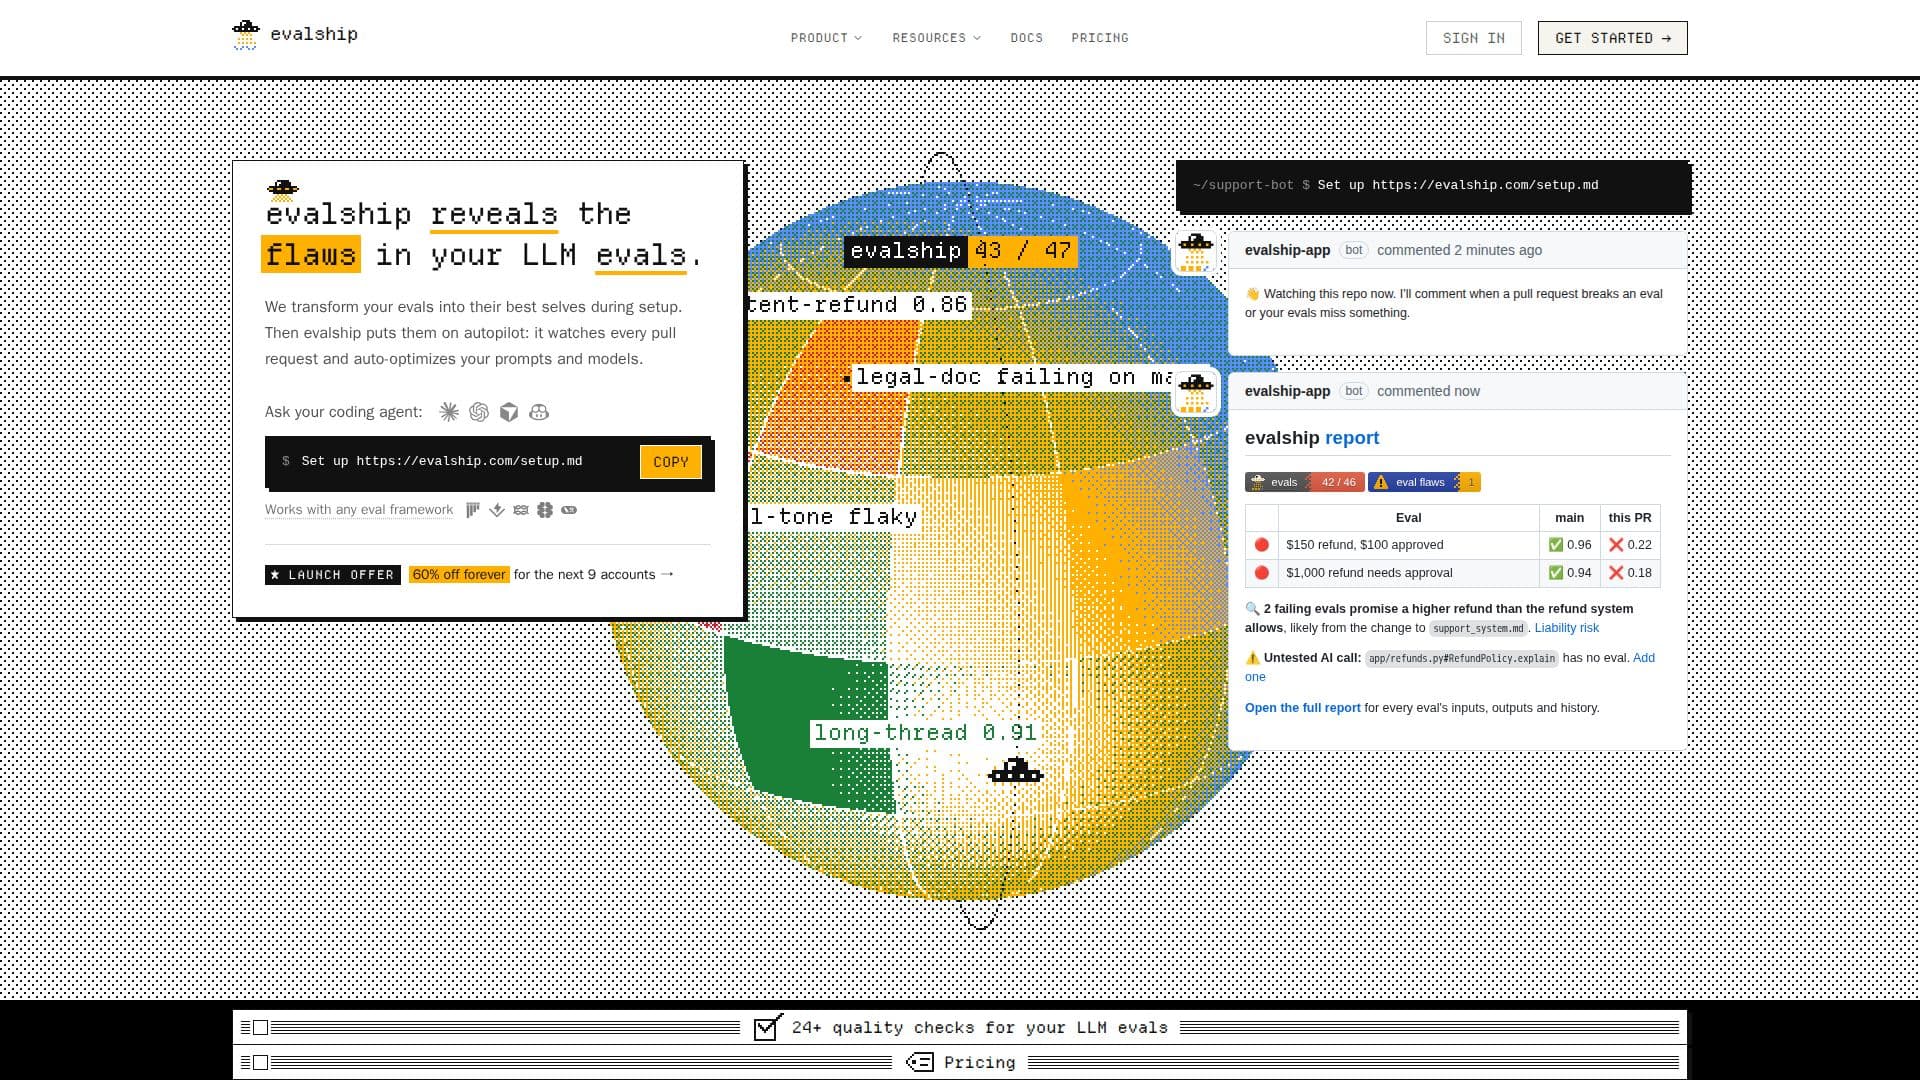
Capture d’écran de evalship

evalship offre une solution complète de contrôle de qualité spécifiquement conçue pour les évaluations de modèles de langage de grande taille (LLM). Il s'intègre directement dans votre flux de travail GitHub, agissant comme un gardien vigilant de votre processus de développement LLM. L'objectif principal d'evalship est d'identifier et de résoudre les défauts dans vos configurations d'évaluation, garantissant que vos LLM fonctionnent comme prévu et n'introduisent pas de régressions.

Lire la suite

Lors de la configuration, evalship examine minutieusement vos évaluateurs, juges et invites existants pour repérer les faiblesses telles que des évaluations qui passent incorrectement ou des règles qui manquent de couverture de test appropriée. Il surveille ensuite chaque demande de tirage, fournissant un retour immédiat sur ce qui a échoué, pourquoi cela a échoué et la cause probable. Cela inclut le signalement des appels d'IA non testés et la séparation des régressions réelles des résultats d'évaluation instables en analysant les performances historiques sur votre branche par défaut.

La plateforme fonctionne sans problème avec divers frameworks d'évaluation, y compris ceux qui produisent JUnit XML, promptfoo JSON ou evalship JSON, tels que pytest, Vitest, Jest, RSpec, Go, Java, PHPUnit, Rust, Langfuse, Braintrust et LangSmith. Il ne lance pas directement vos évaluations ; au lieu de cela, votre flux de travail GitHub Actions ou votre agent de codage les exécute en utilisant vos clés API, et evalship traite les résultats.

Au-delà de l'identification des problèmes, evalship aide à optimiser vos invites et modèles. Grâce à votre agent de codage, il teste différents changements sur votre machine, tels que des modèles moins coûteux ou des règles plus claires, et rapporte quels changements entraînent des améliorations statistiquement significatives. Cela permet aux équipes de prendre des décisions basées sur les données pour améliorer la performance des modèles et l'efficacité des coûts. evalship fournit également des rapports hebdomadaires résumant la performance des évaluations et mettant en évidence les problèmes critiques détectés avant qu'ils n'atteignent la production.

Les tarifs incluent un niveau gratuit pour les dépôts publics et un dépôt privé avec un utilisateur, offrant 100 analyses de PR et 30 jours d'historique d'évaluation. Les plans payants (Équipe, Pro, Entreprise) offrent un nombre accru d'utilisateurs, de dépôts privés, d'analyses de PR et un historique d'évaluation plus long, avec des options de facturation mensuelle ou annuelle. Une offre de lancement propose des réductions significatives pour les premiers utilisateurs. evalship garantit la sécurité en ne stockant pas votre code source ou vos clés API, ne traitant que les différences et les résultats d'évaluation.

  • CatégorieRevue de code et tests IA
  • Modèle tarifaireFreemium
  • DéploiementCloud
  • PlateformesWeb

  • Identifie les défauts dans les évaluations de LLM lors de la configuration

  • Commente chaque demande de tirage avec une analyse détaillée des échecs d'évaluation

  • Optimise automatiquement les invites et les modèles en fonction des données de performance

  • Fonctionne avec tout framework d'évaluation existant (JUnit XML, promptfoo, evalship JSON)

  • Fournit plus de 24 contrôles de qualité pour les évaluations de LLM

  • Sépare les régressions des évaluations instables en utilisant des données historiques

  • Détecte les appels d'IA non testés dans les demandes de tirage

  • Bloque les fusions qui enfreignent les règles d'évaluation (configurable)

  • Débloque les demandes de tirage une fois les problèmes résolus

  • Envoie des rapports hebdomadaires d'évaluation résumant la performance et les problèmes

  • Prend en charge les monorepos et plusieurs flux de travail d'évaluation

  • S'intègre à Langfuse, Braintrust et LangSmith sans nécessiter de changement

  • Propose une révision gratuite des évaluations lors de la configuration

  • Permet aux agents de codage de vérifier les changements avant d'ouvrir des demandes de tirage

  • Assure la sécurité en ne stockant pas le code source ou les clés API

  1. Configuration : Connectez votre dépôt GitHub et demandez à votre agent de codage de configurer evalship, qui examine vos évaluations et crée une demande de tirage de configuration.

  2. Surveillez les demandes de tirage : evalship surveille automatiquement chaque demande de tirage, commentant les changements qui enfreignent les évaluations ou introduisent des appels d'IA non testés.

  3. Examinez les rapports : Accédez à des rapports détaillés pour chaque évaluation, y compris les entrées, les sorties et l'historique pour comprendre ce qui a échoué et pourquoi.

  4. Optimisez : Utilisez la fonction d'optimisation d'evalship pour tester les changements d'invite et de modèle avec votre agent de codage, identifiant les améliorations au-delà du hasard.

  5. Recevez des rapports : Recevez des rapports hebdomadaires par e-mail résumant la performance des évaluations et mettant en évidence les problèmes critiques détectés avant la fusion.

  • Contrôle de qualité des évaluations de LLM
  • Révision automatique des demandes de tirage
  • Optimisation des invites et des modèles
  • Prévention des régressions
  • Détection des appels d'IA non testés
  • Gestion des évaluations instables
  • Conformité et atténuation des risques de responsabilité
  • Amélioration du flux de travail des développeurs
Avis sur evalship

Chargement...

Outils IA populaires comme evalship

LangWatch

Applications IA

LangWatch est une plateforme de test d'agents IA, d'évaluation de LLM et d'observabilité. Elle permet aux développeurs de simuler des scénarios réels, de prévenir les régressions…

MLOps et déploiement de modèles

N°14 en Outils d'ingénierie de prompts

Voir l'outil

Applications IA

Plateforme de test d'agents IA, d'évaluation de LLM et d'observabilité. Elle permet aux développeurs de simuler des scénarios réels, de prévenir les régressions…LangWatch est une plateforme de test d'agents IA, d'évaluation de LLM et d'observabilité. Elle permet aux développeurs de simuler des scénarios réels, de prévenir les régressions…

En vedetteMLOps et déploiement de modèles
N°14 en Outils d'ingénierie de prompts

EvalCore

Applications IA

EvalCore fournit des tests instantanés pour le comportement de l'IA, vous permettant d'enregistrer le comportement de votre application LLM et de le rejouer dans CI à chaque…

Revue de code et tests IA
Voir l'outil

Applications IA

Fournit des tests instantanés pour le comportement de l'IA, vous permettant d'enregistrer le comportement de votre application LLM et de le rejouer dans CI à chaque…EvalCore fournit des tests instantanés pour le comportement de l'IA, vous permettant d'enregistrer le comportement de votre application LLM et de le rejouer dans CI à chaque…

Revue de code et tests IA
Voir le Top 250 Applications IA

Confident AI

Applications IA

Confident AI fournit une plateforme complète d'évaluation des LLM qui évalue les systèmes d'IA, compare les invites et les modèles, et identifie les régressions à l'aide de…

Plateformes de machine learning

N°47 pour Surveillance des modèles AI

Voir l'outil

Applications IA

Fournit une plateforme complète d'évaluation des LLM qui évalue les systèmes d'IA, compare les invites et les modèles, et identifie les régressions à l'aide de…Confident AI fournit une plateforme complète d'évaluation des LLM qui évalue les systèmes d'IA, compare les invites et les modèles, et identifie les régressions à l'aide de…

Plateformes de machine learning
N°47 pour Surveillance des modèles AI

Evidently AI fournit des outils open-source pour évaluer et surveiller les applications d'IA. Il aide à garantir que les systèmes d'IA sont prêts pour la production en testant les…

MLOps et déploiement de modèles

N°20 en MLOps et déploiement de modèles

Voir l'outil

Fournit des outils open-source pour évaluer et surveiller les applications d'IA. Il aide à garantir que les systèmes d'IA sont prêts pour la production en testant les…Evidently AI fournit des outils open-source pour évaluer et surveiller les applications d'IA. Il aide à garantir que les systèmes d'IA sont prêts pour la production en testant les…

MLOps et déploiement de modèles
N°20 en MLOps et déploiement de modèles

mabl

Applications IA

mabl est une plateforme de test logiciel automatisé qui permet aux équipes d'accélérer les mises en production et d'assurer la qualité des logiciels. Elle utilise l'apprentissage…

Revue de code et tests IA

N°32 en Revue de code et tests IA

Voir l'outil

Applications IA

Plateforme de test logiciel automatisé qui permet aux équipes d'accélérer les mises en production et d'assurer la qualité des logiciels. Elle utilise l'apprentissage…mabl est une plateforme de test logiciel automatisé qui permet aux équipes d'accélérer les mises en production et d'assurer la qualité des logiciels. Elle utilise l'apprentissage…

Revue de code et tests IA
N°32 en Revue de code et tests IA

Giskard OSS

Dépôts GitHub d'IA

Giskard OSS est une bibliothèque d'évaluation et de test open-source conçue pour les agents LLM. Elle fournit des outils pour évaluer et améliorer les performances des modèles de…

Revue de code et tests IA

N°111 en Dépôts GitHub d'IA

Voir l'outil

Dépôts GitHub d'IA

Bibliothèque d'évaluation et de test open-source conçue pour les agents LLM. Elle fournit des outils pour évaluer et améliorer les performances des modèles de…Giskard OSS est une bibliothèque d'évaluation et de test open-source conçue pour les agents LLM. Elle fournit des outils pour évaluer et améliorer les performances des modèles de…

Revue de code et tests IA
N°111 en Dépôts GitHub d'IA

Future AGI

Applications IA

Future AGI est une plateforme open-source pour la construction, le test et la surveillance d'agents IA. Elle aide à détecter et corriger les hallucinations de l'IA en temps réel…

MLOps et déploiement de modèles

N°38 en MLOps et déploiement de modèles

Voir l'outil

Applications IA

Plateforme open-source pour la construction, le test et la surveillance d'agents IA. Elle aide à détecter et corriger les hallucinations de l'IA en temps réel…Future AGI est une plateforme open-source pour la construction, le test et la surveillance d'agents IA. Elle aide à détecter et corriger les hallucinations de l'IA en temps réel…

En vedetteMLOps et déploiement de modèles
N°38 en MLOps et déploiement de modèles

DeepEval

Dépôts GitHub d'IA

DeepEval est un cadre open-source conçu pour évaluer les grands modèles de langage (LLM). Il permet aux développeurs de contribuer et d'améliorer le processus d'évaluation,…

MLOps et déploiement de modèles

N°91 en Dépôts GitHub d'IA

Voir l'outil

Dépôts GitHub d'IA

Cadre open-source conçu pour évaluer les grands modèles de langage (LLM). Il permet aux développeurs de contribuer et d'améliorer le processus d'évaluation,…DeepEval est un cadre open-source conçu pour évaluer les grands modèles de langage (LLM). Il permet aux développeurs de contribuer et d'améliorer le processus d'évaluation,…

MLOps et déploiement de modèles
N°91 en Dépôts GitHub d'IA
1 sur 8