Description
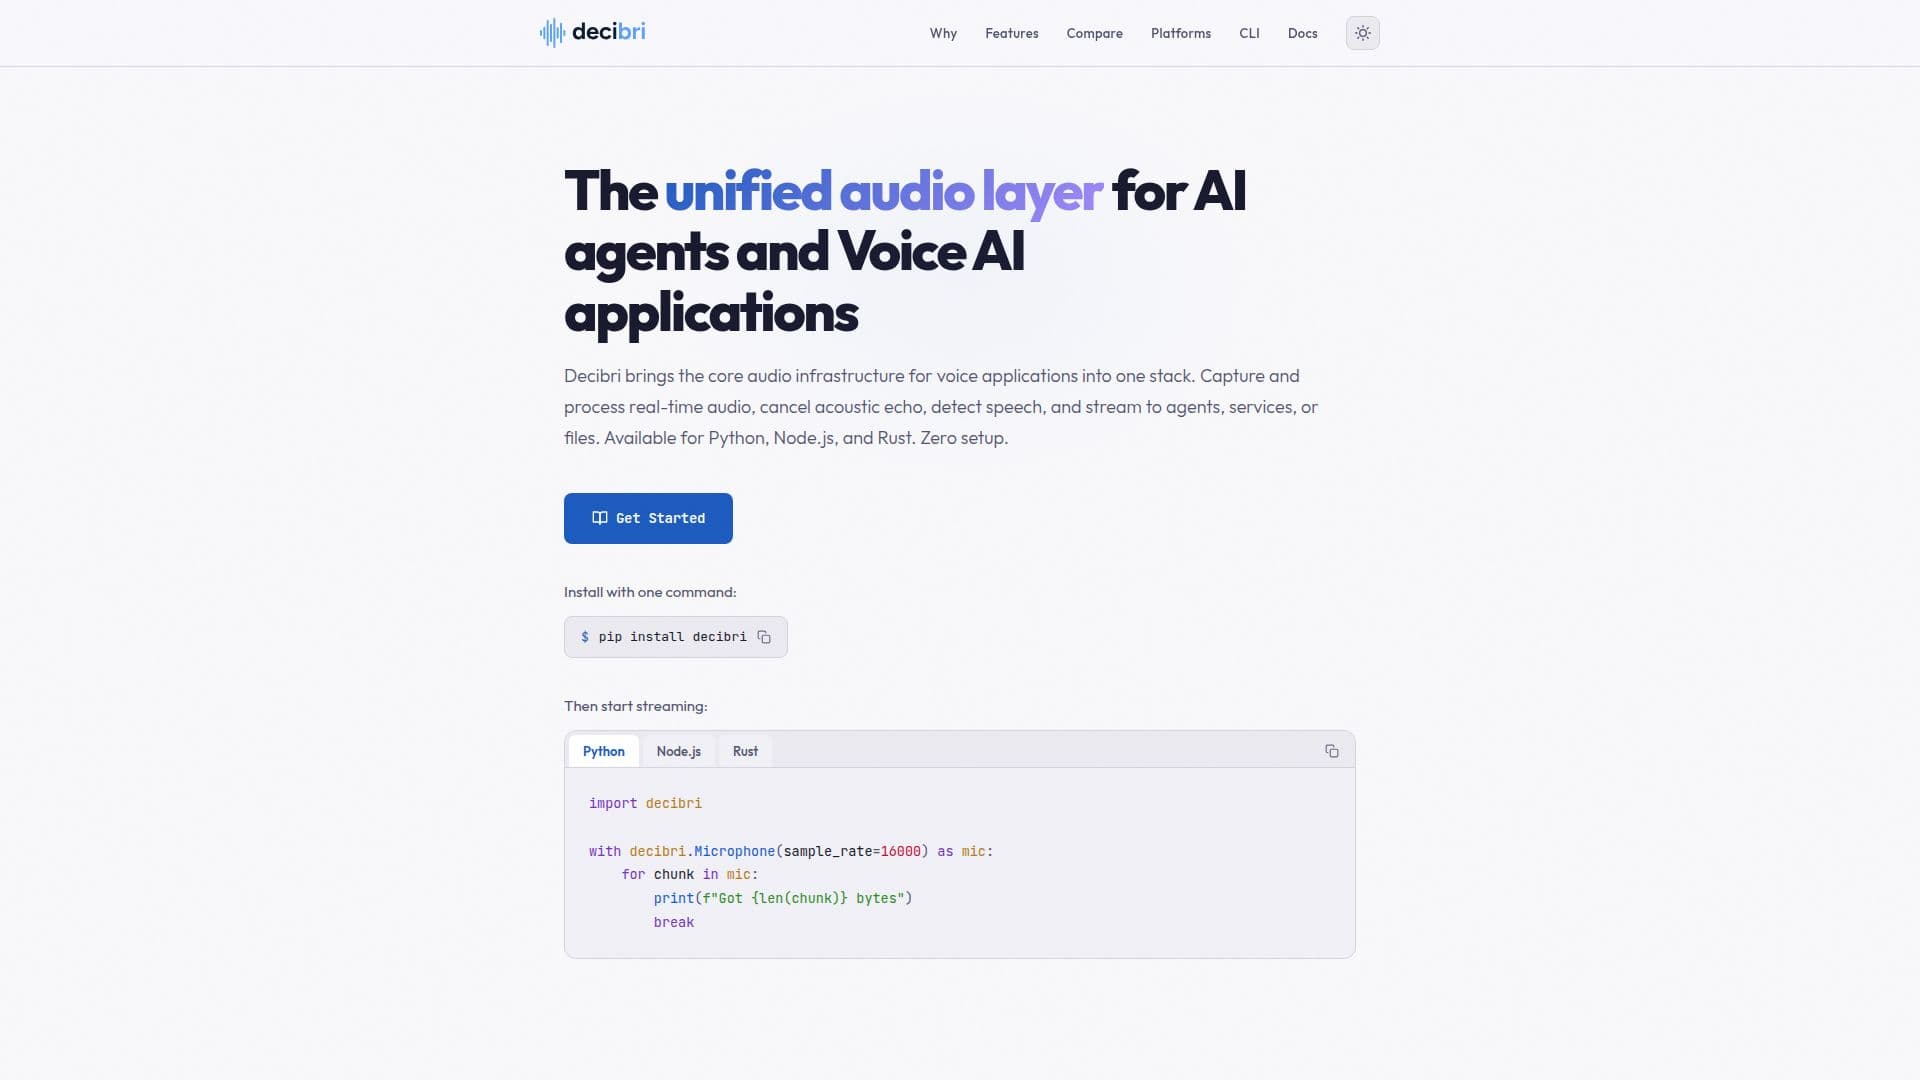
Decibri sert de couche audio unifiée spécifiquement conçue pour les agents IA et les applications Voice AI. Il fournit des capacités audio essentielles en temps réel, y compris la capture de microphone, la sortie de haut-parleur et la détection d'activité vocale (VAD). La plateforme prend en charge plusieurs langages de programmation, à savoir Python, Node.js et Rust, ce qui la rend polyvalente pour divers environnements de développement.
Lire la suite
Un des principaux avantages de Decibri est sa facilité d'installation et sa compatibilité multiplateforme. Il propose des binaires précompilés pour Python et Node.js sur toutes les plateformes prises en charge (Windows, macOS, Linux), éliminant ainsi le besoin de compilation ou d'outils de construction complexes. Cette approche « zéro configuration » garantit que les développeurs peuvent rapidement intégrer des fonctionnalités audio en temps réel dans leurs projets. Le cœur en Rust, qui alimente les paquets Python, Node.js et Rust, se compile en code natif, assurant un audio à faible latence prévisible directement à partir de la couche audio du système d'exploitation.
Decibri capture l'audio directement à partir de la couche audio du système d'exploitation, fournissant par défaut des morceaux audio de 100 ms au format PCM entier signé 16 bits, qui est le format standard attendu par la plupart des moteurs de reconnaissance vocale et de mots de réveil comme Vosk, sherpa-onnx et whisper.cpp. Un format flottant 32 bits est également disponible. Il prend en charge des idiomes natifs de flux pour chaque langage, permettant aux développeurs de diriger l'audio vers des fichiers, des WebSockets ou des agents vocaux de manière efficace. La plateforme inclut également un modèle Silero VAD v6.2 intégré pour une détection vocale précise dans des environnements bruyants, fonctionnant localement via ONNX Runtime sans nécessiter d'API cloud.
Au-delà de la capture et de la lecture de base, Decibri offre des fonctionnalités avancées de traitement audio via son Audio Capture Engine (ACE), y compris la suppression de DC, la réduction de bruit, le filtrage passe-haut, le contrôle automatique du gain et la limitation. Il fournit également une annulation d'écho acoustique (AEC) pour éliminer le son du haut-parleur de la capture du microphone. Pour le traitement hors ligne, le Audio File Processor (AFP) permet de conditionner des échantillons enregistrés ou en mémoire. Decibri s'intègre à de nombreux fournisseurs de reconnaissance vocale (STT), tant basés sur le cloud (AssemblyAI, AWS Transcribe, Azure AI Speech, Deepgram, Google Cloud Speech-to-Text, Mistral Voxtral, OpenAI Realtime API) qu'en local (Sherpa-ONNX, Whisper.cpp), ainsi qu'à des modèles de synthèse vocale (TTS) locaux avec le modèle Kokoro et la détection de mots-clés (KWS) avec Sherpa-ONNX.
Decibri est conçu pour les systèmes en temps réel, garantissant un I/O audio à faible latence sans outils audio externes ou gestion spécifique à la plateforme. Il prend en charge les opérations asynchrones en Python avec `asyncio` et fonctionne à la fois dans des environnements Node.js et de navigateur à partir d'un seul paquet. L'outil `decibri-cli` fournit des capacités en ligne de commande pour la capture audio, la lecture et l'énumération des dispositifs, étendant encore son utilité pour les scripts et les pipelines CI/CD.
- CatégorieCréateurs d'agents IA
- Modèle tarifaireGratuit
- DéploiementLocal
- PlateformesWindows, macOS, Linux, Browser
Fonctionnalités principales de Decibri
Capture de microphone en temps réel
Sortie et lecture de haut-parleur
Détection d'activité vocale (VAD)
Support multiplateforme (Python, Node.js, Rust)
Binaires précompilés pour zéro configuration
Accès direct à la couche audio du système d'exploitation
Sortie audio PCM 16 bits et flottant 32 bits
Support API asynchrone (asyncio pour Python)
Compatibilité navigateur (paquet Node.js)
Moteur de capture audio (suppression de DC, réduction de bruit, AGC)
Annulation d'écho acoustique (AEC)
Détection vocale ML locale (Silero VAD)
Intégration avec des services STT cloud
Intégration avec des modèles STT/TTS/KWS locaux
Interface en ligne de commande (decibri-cli)
Comment utiliser Decibri ?
Installer Decibri : Utilisez `pip install decibri` pour Python ou `npm install decibri` pour Node.js afin d'obtenir les binaires précompilés.
Ouvrir le microphone : Utilisez `decibri.Microphone.open()` en Python ou `new Microphone()` en Node.js pour commencer à capturer l'audio.
Diffuser de l'audio : Lisez des morceaux audio en utilisant des itérateurs Python, des flux lisibles Node.js ou des canaux Rust.
Traiter l'audio : Appliquez des conditionnements intégrés comme la suppression de DC, la réduction de bruit ou l'annulation d'écho acoustique.
Détecter la parole : Activez le modèle Silero VAD intégré pour la détection d'activité vocale locale.
Intégrer avec des services IA : Dirigez l'audio PCM brut vers des services de reconnaissance vocale, des agents vocaux ou d'autres modèles IA.
Jouer de l'audio : Utilisez l'API Speaker de Decibri pour jouer de l'audio via le haut-parleur du système.
Enregistrer dans un fichier : Utilisez `record_to_file()` pour un enregistrement audio simple ou un contrôle complet du streaming pour des cas d'utilisation avancés.
Cas d'utilisation de Decibri
- Agents Voice AI en temps réel
- Intégration Speech-to-Text
- Détection d'activité vocale
- Enregistrement audio pour ASR
- Applications audio multiplateformes
- Backends vocaux côté serveur
- Détection de mots-clés
- Communication audio duplex intégral