Description
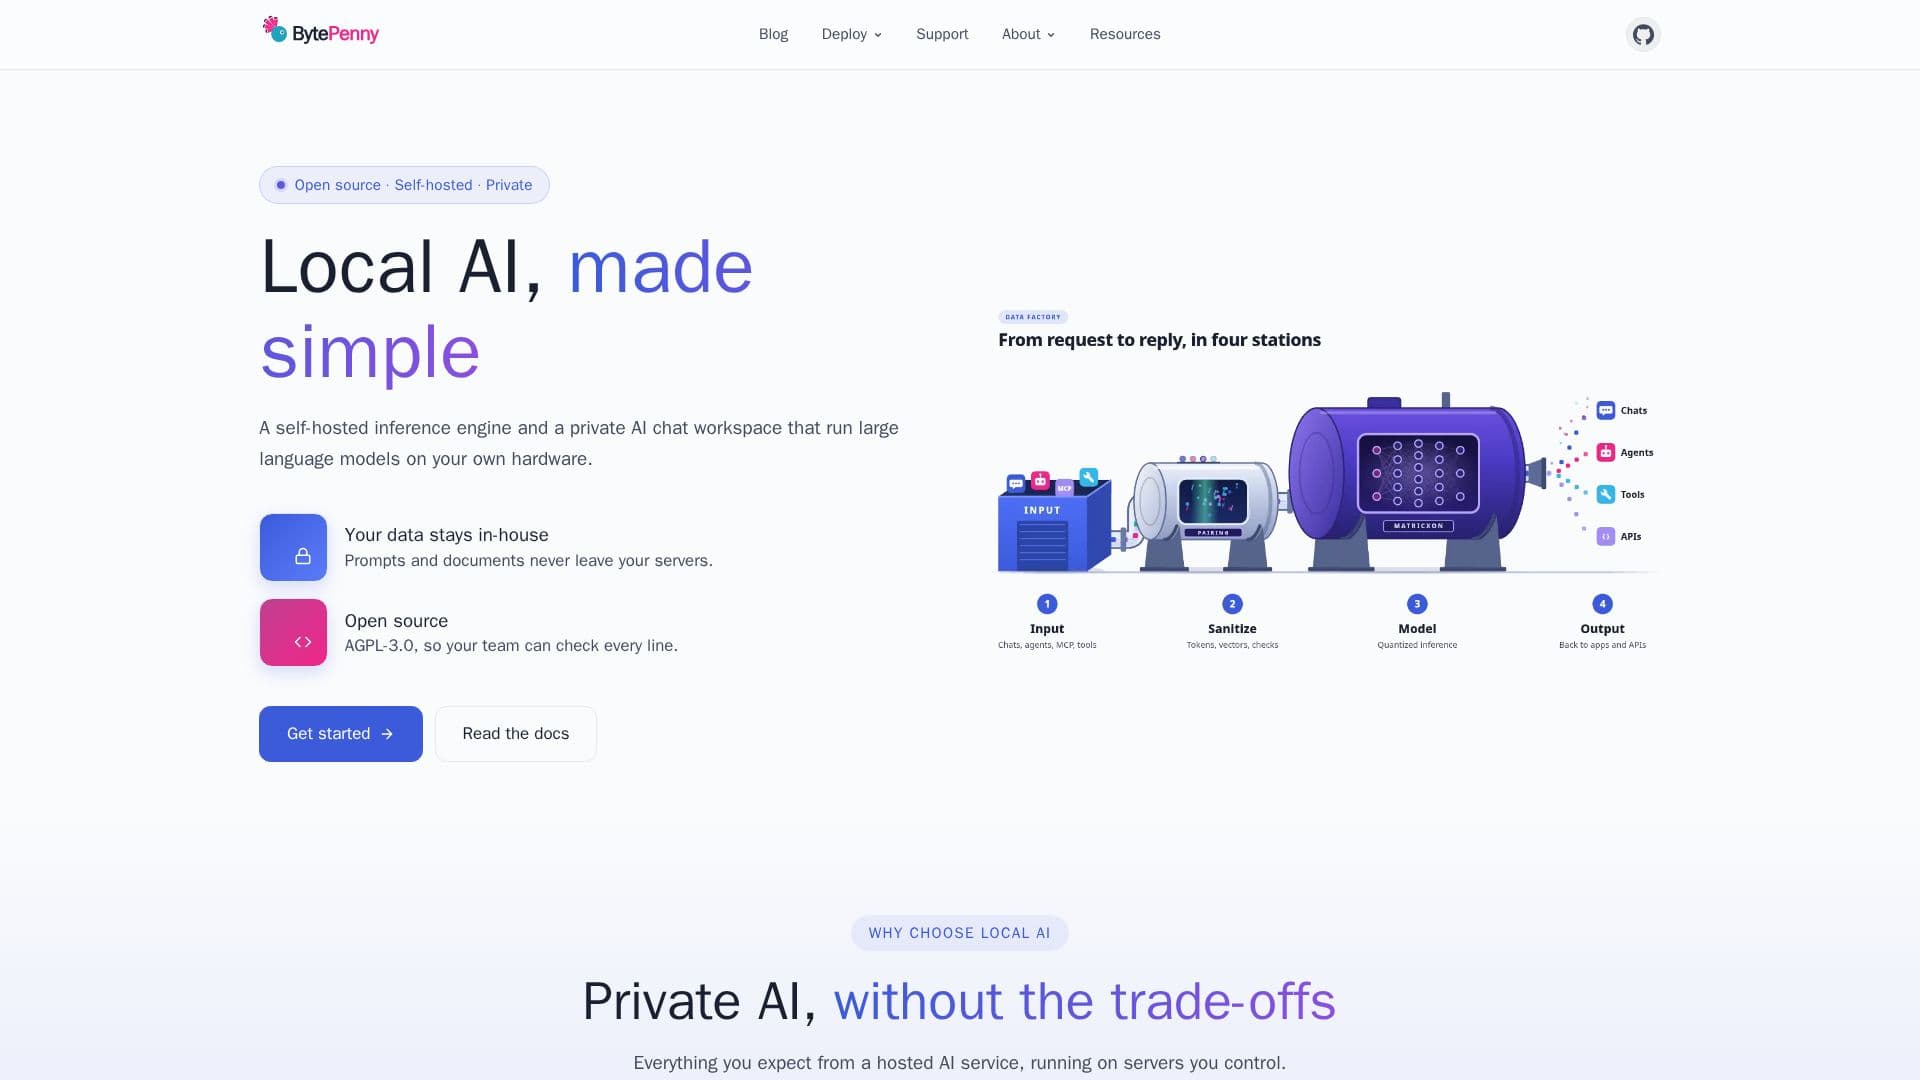
BytePenny fournit une suite complète d'outils d'IA open-source et auto-hébergés conçus pour la confidentialité et le contrôle. L'offre principale comprend Matricxon, un moteur d'inférence GGUF open-source, et pAIring, un espace de travail de chat IA privé adapté aux équipes. Ces produits permettent aux organisations d'exécuter de grands modèles de langage directement sur leur propre matériel, garantissant que les invites, documents et données de chat ne quittent jamais leurs serveurs.
Lire la suite
La plateforme met l'accent sur la confidentialité des données, fonctionnant entièrement hors ligne pour garder toutes les informations sensibles en interne. Elle prend en charge divers modèles GGUF provenant de sources telles que Hugging Face, llama.cpp ou les moteurs Matricxon, et peut s'intégrer avec des serveurs d'outils MCP. BytePenny est construit avec une philosophie open-source, utilisant une licence AGPL-3.0, ce qui permet aux équipes d'inspecter et de modifier chaque ligne de code, favorisant la transparence et la confiance.
Matricxon, l'engin d'inférence, est un runtime LLM léger et lisible écrit en Python et PyTorch, avec des noyaux C natifs pour des performances accrues. Il prend en charge les modèles GGUF pour des tâches telles que le chat, la génération de texte, les embeddings, le reranking, les modèles vision-langage et la prévision de séries temporelles, les servant via une API HTTP. Il fonctionne efficacement sur des CPU et offre un support BETA pour les GPU NVIDIA, avec des plans pour s'étendre aux GPU AMD et Apple Silicon. Matricxon prend également en charge un mode cluster pour des modèles partagés et des caches de chat sur plusieurs nœuds, gérés depuis l'interface utilisateur de pAIring.
pAIring, l'espace de travail de chat IA privé, est conçu pour la collaboration en équipe, offrant des fonctionnalités telles que l'accès basé sur les rôles, des canaux partagés et une base de connaissances intégrée. Il fournit des caches de chat chiffrés et garantit que les invites ne sont jamais utilisées pour l'entraînement des modèles. Le système est évolutif, permettant aux utilisateurs de commencer avec un seul serveur et d'étendre en ajoutant des nœuds avec des capacités d'équilibrage de charge et de basculement. Pour les scénarios nécessitant plus de puissance, pAIring peut se connecter à divers fournisseurs de cloud tels que Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq, et plus encore, offrant la flexibilité de mélanger des moteurs locaux et cloud.
BytePenny élimine la facturation par jeton, permettant aux organisations de tirer parti du matériel existant et de maintenir des coûts fixes à mesure que l'utilisation augmente. L'ensemble de la pile est conçu pour être ouvert, du code AGPL-3.0 aux modèles open-weight, ce qui le rend idéal pour les réseaux privés et fermés. La sécurité est une préoccupation primordiale, avec des fonctionnalités telles que des mots de passe hachés bcrypt, des secrets stockés chiffrés, des caches de chat chiffrés AES-256-GCM, et des vérifications de rôle côté serveur pour les actions administratives. Tant Matricxon que pAIring ont obtenu le badge 'passing' des Meilleures Pratiques OpenSSF, démontrant un engagement envers des pratiques de développement sécurisées.
- CatégorieMLOps et déploiement de modèles
- Modèle tarifaireOpen Source (AGPL-3.0), No Per-Token Bills
- DéploiementSelf-Hosted, On-Premise, Cloud (Hybrid)
- PlateformesWindows, Linux
Fonctionnalités principales de BytePenny
Moteur d'inférence IA auto-hébergé (Matricxon)
Espace de travail de chat IA privé pour les équipes (pAIring)
Exécutez de grands modèles de langage sur votre propre matériel
Les données restent en interne ; les invites et documents ne quittent jamais les serveurs
Open-source avec licence AGPL-3.0
Fonctionne entièrement hors ligne
Caches de chat chiffrés avec AES-256-GCM
Accès basé sur les rôles pour les équipes
Les invites ne sont jamais utilisées pour l'entraînement des modèles
Prend en charge les modèles GGUF de Hugging Face, llama.cpp, Matricxon
Noyaux quantifiés pour le support CPU et GPU NVIDIA
Pas de facturation par jeton ; coûts fixes avec la croissance de l'utilisation
Déploiement évolutif : nœud unique, cluster partagé ou serveurs séparés
Se connecte à plus de 12 fournisseurs de cloud (Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq, etc.)
Écrit de zéro en Python pour la lisibilité et la personnalisation
Comment utiliser BytePenny ?
Déployer BytePenny : Installez Matricxon et pAIring sur vos propres serveurs ou infrastructure cloud.
Configurer le moteur d'inférence : Configurez Matricxon comme moteur d'inférence local ou connectez pAIring à un fournisseur de cloud préféré.
Ajouter des modèles : Intégrez des modèles GGUF de Hugging Face ou d'autres sources, ou utilisez des modèles hébergés dans le cloud via des connecteurs.
Gérer les utilisateurs et les équipes : Configurez l'accès basé sur les rôles, créez des canaux partagés et établissez une base de connaissances au sein de pAIring.
Commencer à discuter : Lancez des conversations IA privées et tirez parti de la base de connaissances pour la collaboration en équipe.
Surveiller et évoluer : Observez l'état du système, gérez les nœuds du cluster et étendez le matériel à mesure que l'utilisation augmente sans encourir de coûts par jeton.
Cas d'utilisation de BytePenny
- Chat d'équipe privé
- Inférence LLM locale
- Analyse de documents sécurisée
- Opérations IA à coût contrôlé
- Flux de travail IA hors ligne
- Déploiement de modèles personnalisés
- Infrastructure IA évolutive
- Développement IA open-source