Description
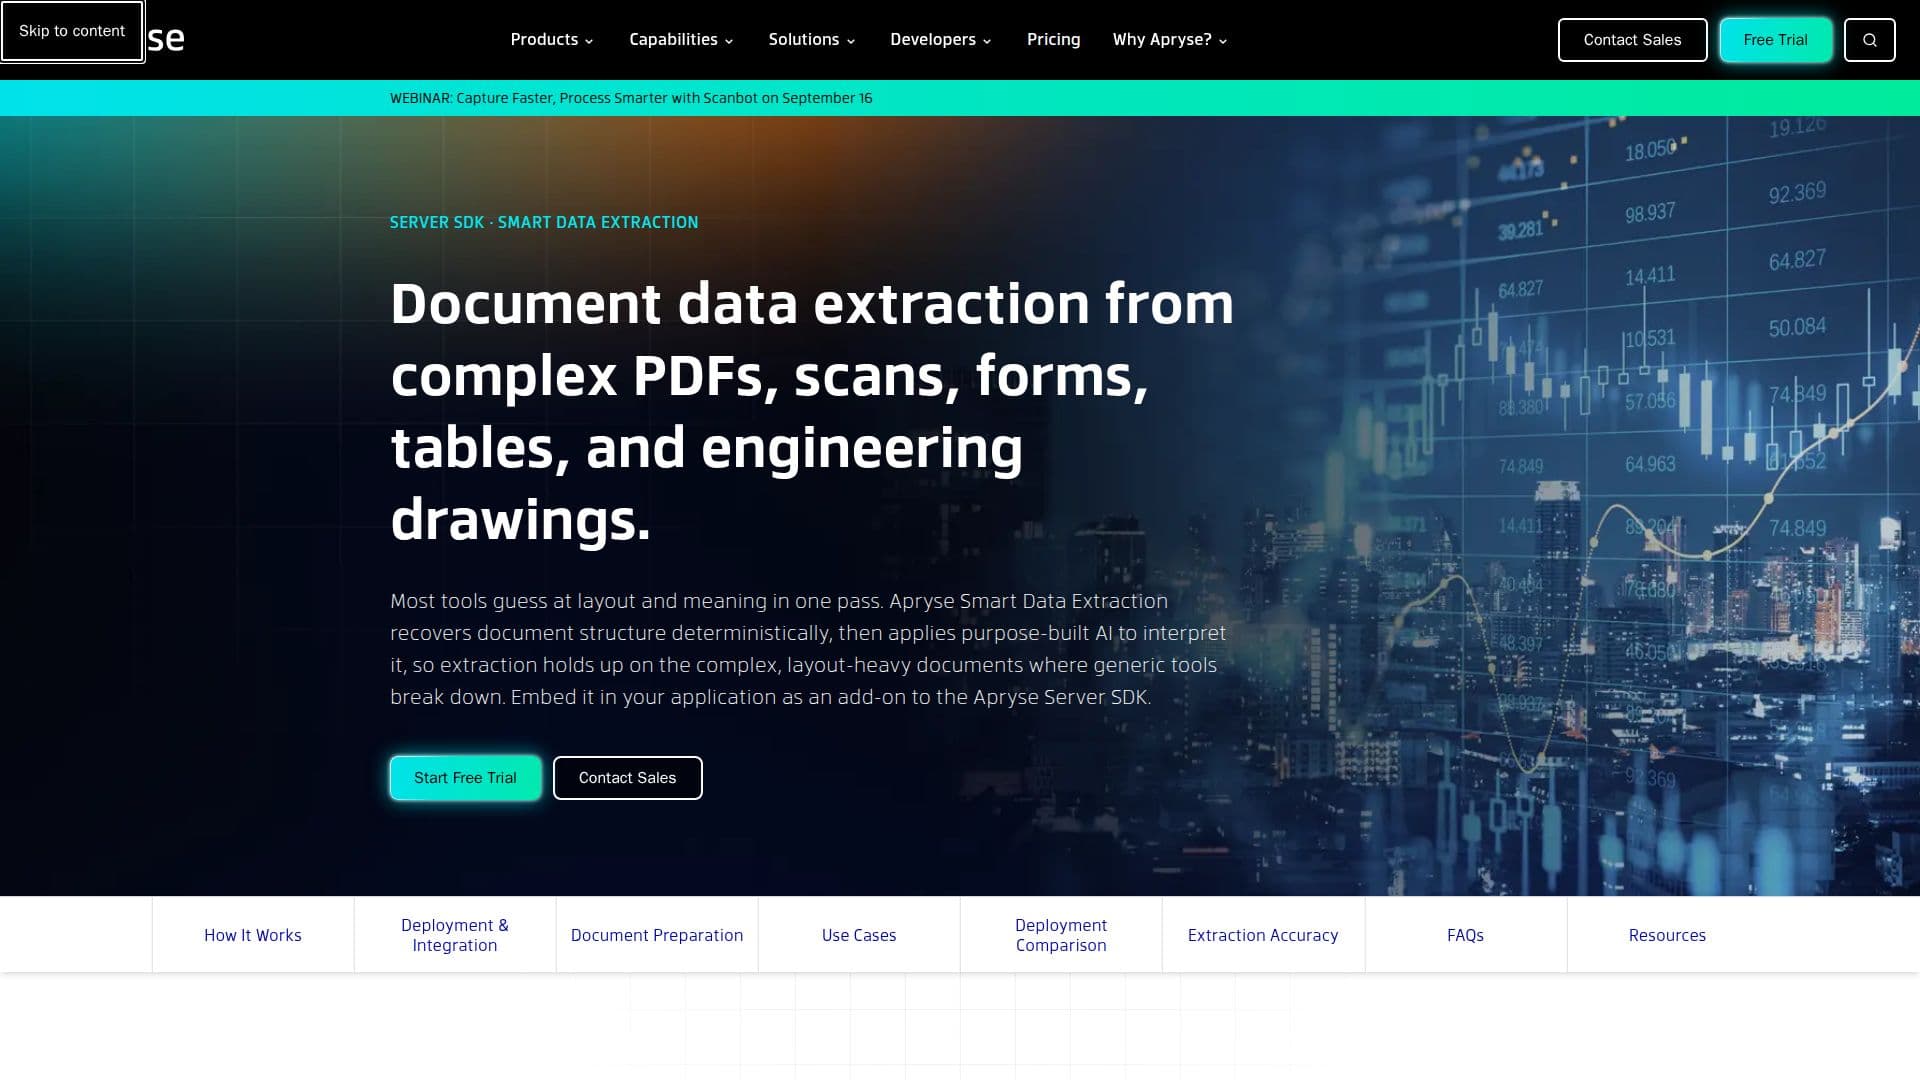
L'extraction de données PDF Apryse est une solution robuste pour transformer des PDF non structurés en données structurées, adaptée à l'analyse, à l'automatisation et à l'entraînement de modèles. Ce SDK auto-hébergé est conçu pour extraire des tableaux, des formulaires et des codes-barres avec précision et rapidité, garantissant une souveraineté totale des données. Contrairement aux API basées sur le cloud, il élimine les risques de résidence des données et évite les coûts 'par page'. L'extraction intelligente de données d'Apryse peut classifier automatiquement les documents, attribuant des catégories et des scores de confiance au niveau de la page. Il identifie les paires clé-valeur sans nécessiter de coordonnées fixes, ce qui le rend polyvalent pour divers formats de documents.
Le SDK peut extraire des tableaux à partir de PDF complexes, récupérant des lignes, des colonnes et des structures à partir de tableaux imbriqués et de pages à colonnes multiples. La détection des champs de formulaire identifie et étiquette des champs tels que les zones de texte et les champs de signature, tandis que l'OCR et l'ICR convertissent les documents scannés et manuscrits en texte lisible par machine. Cette capacité est cruciale pour les documents ayant une qualité d'image et une complexité de mise en page variables.
La solution d'Apryse fonctionne hors ligne et sur site, prenant en charge Windows et Linux sur x64, avec des liaisons pour plusieurs langages de programmation, y compris .NET, Java, Python, et plus encore. Elle offre une sortie JSON structurée avec des scores de confiance, la rendant compatible avec les pipelines LLM pour un traitement de données ultérieur. Le SDK est une alternative à l'IA documentaire dans le cloud, offrant un contrôle sur le déploiement et l'intégration au sein d'une infrastructure contrôlée par le client.
La tarification de l'extraction intelligente de données est basée sur une licence de package plutôt que sur un comptage par page, offrant un modèle commercial prévisible. Cela la rend adaptée au traitement à volume élevé dans des secteurs tels que les services financiers, l'assurance, le juridique, la santé et le gouvernement. La solution d'Apryse est idéale pour les équipes ayant besoin d'une extraction de documents fiable intégrée dans leurs applications, en particulier lorsqu'il s'agit d'informations sensibles ou de formats de documents complexes.
Fonctionnalités principales de Extraction de données PDF Apryse
Classification des documents avec scoring de confiance
Extraction de paires clé-valeur sans coordonnées fixes
Extraction de tableaux à partir de mises en page complexes
Détection des champs de formulaire pour les champs de texte et de signature
OCR et ICR pour les documents scannés et manuscrits
Déploiement hors ligne et sur site
Sortie JSON structurée avec scores de confiance
Intégration avec des pipelines LLM
Comment utiliser Extraction de données PDF Apryse ?
Configurer : Installez le SDK dans votre application
Utiliser : Extrayez des données des PDF en utilisant le SDK
Optimiser : Ajustez les paramètres pour des types de documents spécifiques
Cas d'utilisation de Extraction de données PDF Apryse
- Services financiers
- Assurance
- Juridique
- Santé
- Gouvernement