Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

WeMM-Video-35B-A3B

LLM#38Modelos de IA y LLMCódigo abierto · Web

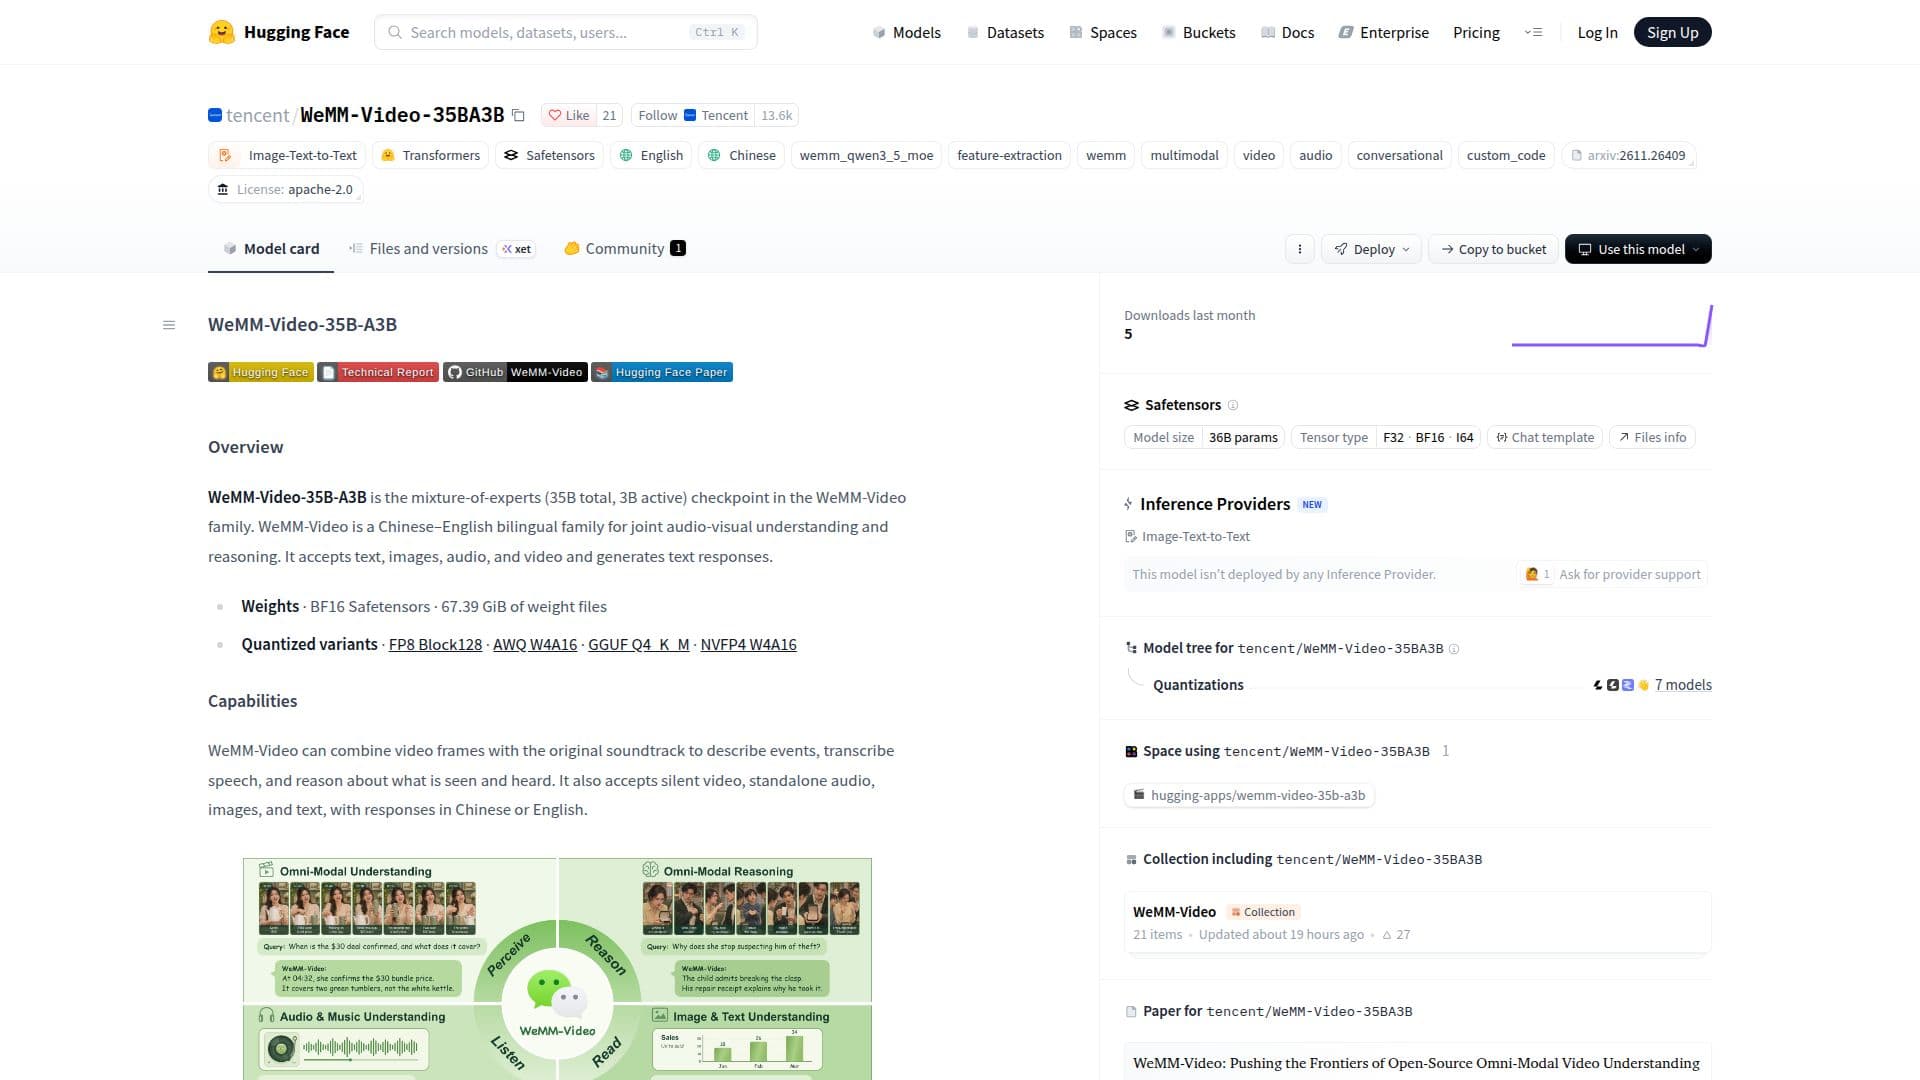
WeMM-Video-35B-A3B es un modelo de mezcla de expertos de la familia WeMM-Video, diseñado para la comprensión y razonamiento audio-visual conjunta. Este modelo bilingüe chino-inglés acepta entradas de texto, imágenes, audio y video para generar respuestas en texto. Puede describir eventos, transcribir discursos y razonar sobre lo que se ve y se escucha, ofreciendo modos de respuesta tanto directos como de razonamiento.

Visitar URL
Compartir
Captura de pantalla de WeMM-Video-35B-A3B

WeMM-Video-35B-A3B es un sofisticado modelo de mezcla de expertos, parte de la familia más amplia WeMM-Video, desarrollado para una comprensión y razonamiento audio-visual integral. Con 35 mil millones de parámetros en total y 3 mil millones de parámetros activos, este modelo está específicamente diseñado para procesar e interpretar entradas multimodales, incluyendo texto, imágenes, audio y video, generando respuestas textuales coherentes en chino o inglés.

Leer más

Las capacidades centrales del modelo incluyen la habilidad de combinar fotogramas de video con sus bandas sonoras originales para describir eventos, transcribir discursos con precisión y realizar tareas de razonamiento basadas en información visual y auditiva. También es lo suficientemente versátil como para manejar video silencioso, audio independiente, imágenes y entradas de texto de manera independiente. Esto lo hace adecuado para una amplia gama de aplicaciones que requieren una comprensión contextual profunda a través de diferentes tipos de medios.

Arquitectónicamente, WeMM-Video-35B-A3B emplea codificadores de visión y audio para convertir las entradas de medios en tokens, que luego son procesados por un modelo de lenguaje junto con texto. Los fotogramas de video se enriquecen con marcas de tiempo para mantener el contexto temporal. La familia del modelo pasó por un extenso preentrenamiento en aproximadamente 1.2 billones de tokens multimodales, seguido de técnicas avanzadas de post-entrenamiento como OPD de múltiples maestros, MrDPO anti-repetición y aprendizaje por refuerzo especializado para mejorar su rendimiento y robustez.

El despliegue y la integración se facilitan a través de varias opciones de servicio. Los usuarios pueden configurar el entorno de Transformers y ejecutar ejemplos directamente desde el repositorio de WeMM-Video. El modelo admite variantes cuantizadas como FP8 Block128, AWQ W4A16, GGUF Q4_K_M y NVFP4 W4A16. Para el servicio, es compatible con versiones parcheadas de vLLM (0.18.0 y 0.31.0) y SGLang (0.5.16 o 0.5.19), permitiendo una inferencia eficiente, incluyendo paralelismo de tensores a través de múltiples GPUs. El modelo también ofrece diferentes modos de chat, incluyendo un modo de instrucción por defecto y un 'modo de pensamiento' para respuestas de razonamiento.

WeMM-Video-35B-A3B ha demostrado un rendimiento sólido, estableciendo un nuevo estado del arte de código abierto. Se ha demostrado que supera a modelos propietarios como Qwen3.5-Omni-Flash y Seed2.0-Mini-0428, reduciendo significativamente la brecha de rendimiento con modelos avanzados como Gemini-3.0-Flash. El modelo se publica bajo la Licencia Apache 2.0, promoviendo el acceso abierto y la colaboración dentro de la comunidad de IA.

  • CategoríaModelos de IA y LLM
  • Modelo de preciosCódigo abierto
  • ImplementaciónNube
  • PlataformasWeb

  • Procesamiento bilingüe chino-inglés

  • Comprensión y razonamiento audio-visual conjunta

  • Acepta entradas de texto, imágenes, audio y video

  • Genera respuestas en texto

  • Describe eventos a partir de fotogramas de video y bandas sonoras

  • Transcribe discursos a partir de audio

  • Razonamiento sobre información visual y auditiva

  • Soporta video silencioso y procesamiento de audio independiente

  • Arquitectura de mezcla de expertos (35B en total, 3B parámetros activos)

  • Preentrenado en 1.2 billones de tokens multimodales

  • Post-entrenado con OPD de múltiples maestros y MrDPO

  • Aprendizaje por refuerzo especializado para un rendimiento mejorado

  • Soporta varias variantes cuantizadas (FP8, AWQ, GGUF, NVFP4)

  • Compatible con versiones parcheadas de vLLM y SGLang para servicio

  • Ofrece modos de chat Instruct y Thinking

  1. Configurar el Entorno: Instalar el entorno de Transformers y las dependencias necesarias.

  2. Cargar el Modelo: Cargar el modelo WeMM-Video-35B-A3B y el procesador desde Hugging Face Hub.

  3. Preparar Entradas: Proporcionar entradas de medios como archivos de video MP4, audio independiente, imágenes o texto.

  4. Procesar Medios: Usar el script para procesar fotogramas de video solos o con la pista de audio original.

  5. Generar Respuestas: Enviar solicitudes al modelo, especificando el modo de chat (Instruct o Thinking) para la generación de texto.

  6. Servir el Modelo (Opcional): Instalar el parche de tiempo de ejecución WeMM y usar vLLM o SGLang parcheados para el servicio de API.

  7. Enviar Solicitudes de API: Usar el cliente de solicitud empaquetado para enviar medios en línea al punto final de chat compatible con OpenAI.

  • Análisis de Contenido de Video
  • Transcripción de Discurso
  • Razonamiento Multimodal
  • Procesamiento de Contenido Bilingüe
  • Descripción de Eventos Audio-Visuales
  • Desarrollo de Modelos de IA
  • Investigación y Experimentación

Herramientas de IA populares como WeMM-Video-35B-A3B

Llama-3.2-11B-Vision-Instruct es un modelo de IA multimodal diseñado para el reconocimiento visual, el razonamiento de imágenes y la generación de descripciones. Desarrollado por…

Modelos de IA y LLM
Ver herramienta

Modelo de IA multimodal diseñado para el reconocimiento visual, el razonamiento de imágenes y la generación de descripciones. Desarrollado por…Llama-3.2-11B-Vision-Instruct es un modelo de IA multimodal diseñado para el reconocimiento visual, el razonamiento de imágenes y la generación de descripciones. Desarrollado por…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Paso 3.7 Flash es un modelo de lenguaje-visión Mixture-of-Experts escaso diseñado para cargas de trabajo de producción de alta frecuencia. Combina una columna vertebral de…

Modelos de IA y LLM

N.º 81 en LLM

Ver herramienta

Modelo de lenguaje-visión Mixture-of-Experts escaso diseñado para cargas de trabajo de producción de alta frecuencia. Combina una columna vertebral de…Paso 3.7 Flash es un modelo de lenguaje-visión Mixture-of-Experts escaso diseñado para cargas de trabajo de producción de alta frecuencia. Combina una columna vertebral de…

Modelos de IA y LLM
N.º 81 en LLM

Apertus 1.5 es una familia de modelos de lenguaje multilingües y multimodales diseñados para soportar una amplia gama de idiomas y contextos. Ofrece acceso de código abierto y…

Modelos de IA y LLM

N.º 72 en LLM

Ver herramienta

Familia de modelos de lenguaje multilingües y multimodales diseñados para soportar una amplia gama de idiomas y contextos. Ofrece acceso de código abierto y…Apertus 1.5 es una familia de modelos de lenguaje multilingües y multimodales diseñados para soportar una amplia gama de idiomas y contextos. Ofrece acceso de código abierto y…

Modelos de IA y LLM
N.º 72 en LLM

Llama-4 Maverick 17B-128E Instruct es un modelo de IA multimodal desarrollado por Meta, diseñado para una comprensión avanzada de texto e imagen. Aprovecha una arquitectura de…

Modelos de IA y LLM
Ver herramienta

Modelo de IA multimodal desarrollado por Meta, diseñado para una comprensión avanzada de texto e imagen. Aprovecha una arquitectura de…Llama-4 Maverick 17B-128E Instruct es un modelo de IA multimodal desarrollado por Meta, diseñado para una comprensión avanzada de texto e imagen. Aprovecha una arquitectura de…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Nemotron-Labs-Audex-2B es un modelo de lenguaje grande unificado de audio y texto diseñado para tareas de audio como comprensión, reconocimiento y traducción. Soporta modos de…

Modelos de IA y LLM

N.º 33 en LLM

Ver herramienta

Modelo de lenguaje grande unificado de audio y texto diseñado para tareas de audio como comprensión, reconocimiento y traducción. Soporta modos de…Nemotron-Labs-Audex-2B es un modelo de lenguaje grande unificado de audio y texto diseñado para tareas de audio como comprensión, reconocimiento y traducción. Soporta modos de…

Modelos de IA y LLM
N.º 33 en LLM

Gemini 3.1 Pro es un modelo de IA avanzado diseñado para tareas complejas y razonamiento profundo. Destaca en la comprensión multimodal, proporcionando respuestas inteligentes y…

Modelos de IA y LLM
Ver herramienta

Modelo de IA avanzado diseñado para tareas complejas y razonamiento profundo. Destaca en la comprensión multimodal, proporcionando respuestas inteligentes y…Gemini 3.1 Pro es un modelo de IA avanzado diseñado para tareas complejas y razonamiento profundo. Destaca en la comprensión multimodal, proporcionando respuestas inteligentes y…

DestacadaModelos de IA y LLM
Ver el Top 5 de Modelos de IA

Llama-4-Scout-17B-16E-Instruct es un modelo de IA multimodal diseñado por Meta. Aprovecha una arquitectura de mezcla de expertos para proporcionar capacidades avanzadas de…

Modelos de IA y LLM
Ver herramienta

Modelo de IA multimodal diseñado por Meta. Aprovecha una arquitectura de mezcla de expertos para proporcionar capacidades avanzadas de…Llama-4-Scout-17B-16E-Instruct es un modelo de IA multimodal diseñado por Meta. Aprovecha una arquitectura de mezcla de expertos para proporcionar capacidades avanzadas de…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Qwen3-VL

Repositorios de IA en GitHub

Qwen3-VL es una serie de modelos de visión-lenguaje del equipo Qwen de Alibaba Cloud, lanzada en tamaños Denso y Mezcla de Expertos con ediciones de instrucción y razonamiento…

Modelos de IA y LLM
Ver herramienta

Repositorios de IA en GitHub

Serie de modelos de visión-lenguaje del equipo Qwen de Alibaba Cloud, lanzada en tamaños Denso y Mezcla de Expertos con ediciones de instrucción y razonamiento…Qwen3-VL es una serie de modelos de visión-lenguaje del equipo Qwen de Alibaba Cloud, lanzada en tamaños Denso y Mezcla de Expertos con ediciones de instrucción y razonamiento…

Modelos de IA y LLM
Ver el Top 250 de Repositorios de IA en GitHub
1 de 8