Descripción
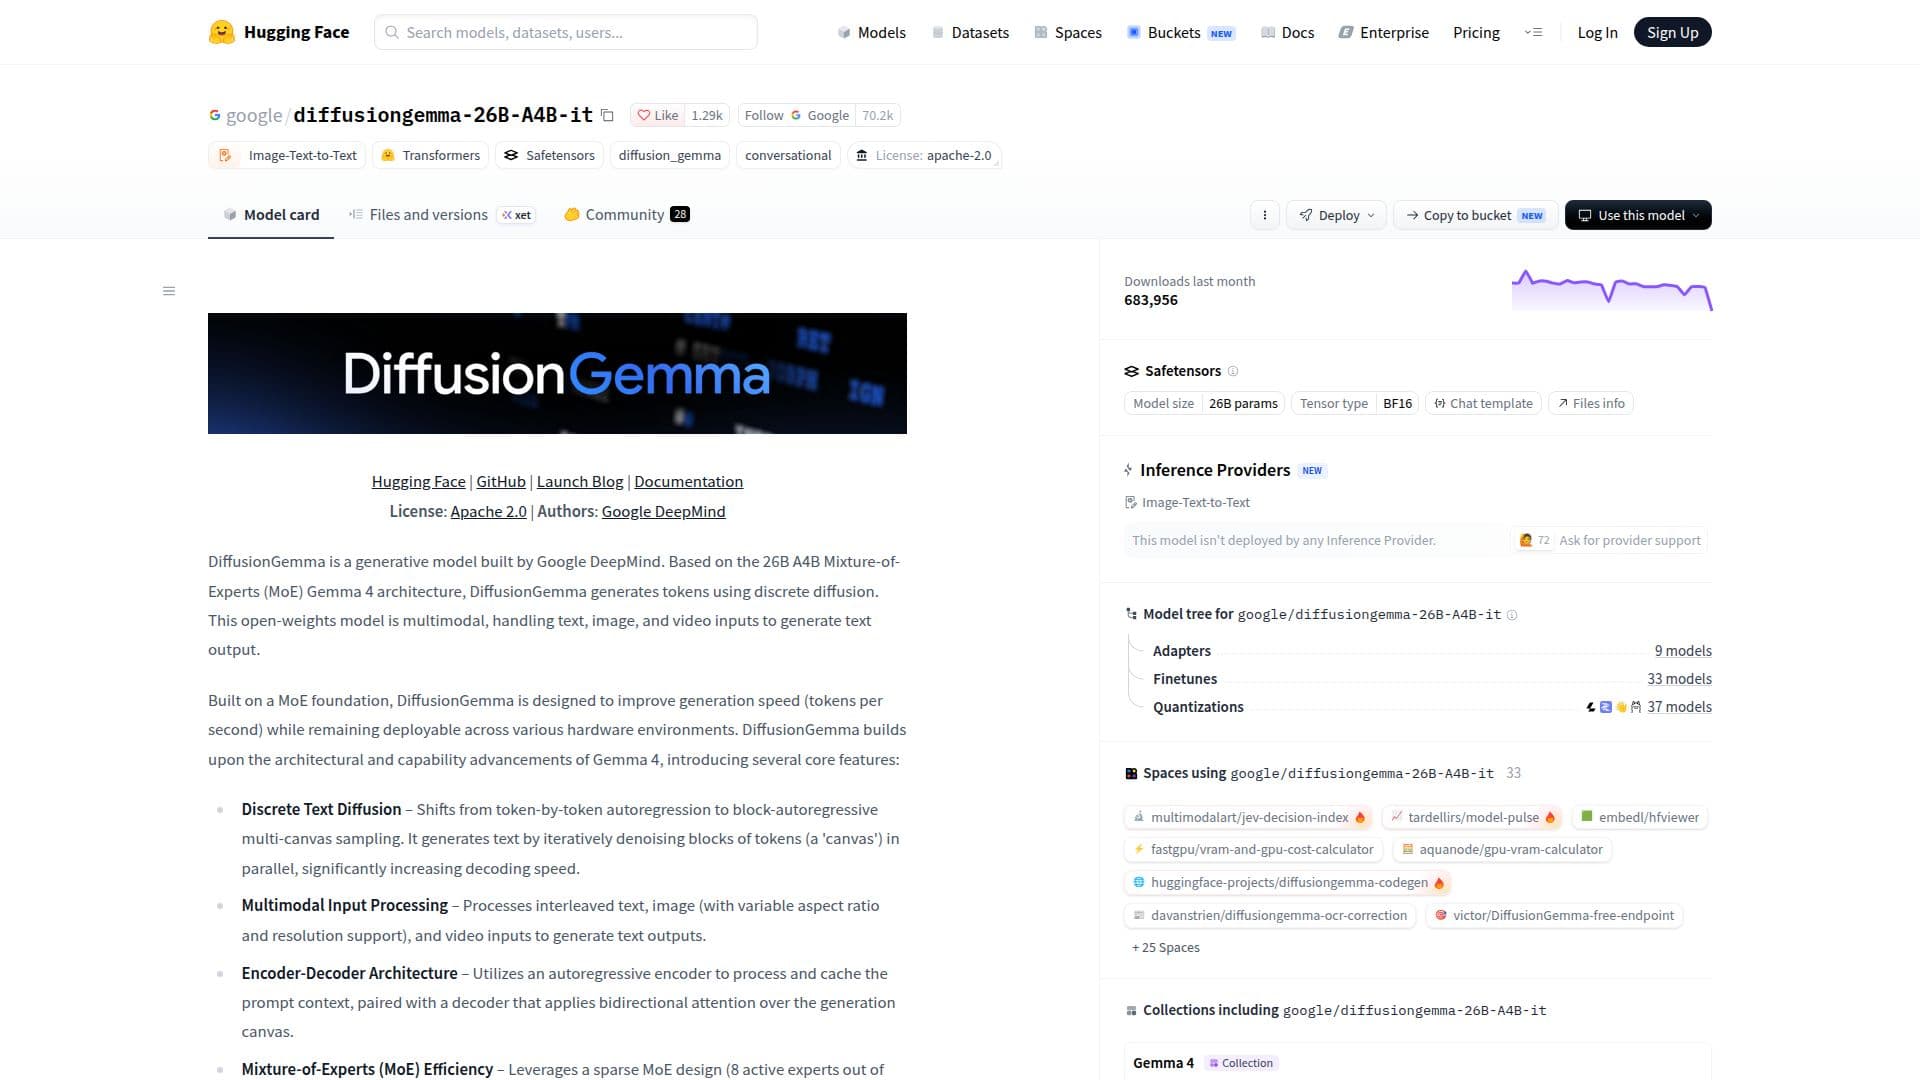
DiffusionGemma, desarrollado por Google DeepMind, es un modelo generativo que aprovecha la arquitectura Mixture-of-Experts (MoE) Gemma 4 de 26B A4B. Está diseñado para generar salidas de texto a partir de entradas multimodales, incluyendo texto, imágenes y videos. El modelo emplea difusión discreta para mejorar la velocidad de generación de tokens, lo que lo hace adecuado para su implementación en diversos entornos de hardware.
Leer más
La arquitectura del modelo presenta un método de muestreo multi-canvas autoregresivo por bloques, que aumenta significativamente la velocidad de decodificación al eliminar el ruido de bloques de tokens en paralelo. Este enfoque permite que DiffusionGemma genere texto a una velocidad superior en comparación con los modelos autoregresivos tradicionales. La arquitectura de codificador-decodificador utiliza un codificador autoregresivo para procesar y almacenar en caché el contexto del aviso, mientras que el decodificador aplica atención bidireccional sobre el lienzo de generación.
El diseño MoE disperso de DiffusionGemma, con 8 expertos activos de 128, proporciona fuertes capacidades de razonamiento mientras mantiene una baja huella de memoria. Esta eficiencia lo hace adecuado para la ejecución local y optimizado para la inferencia de tamaño de lote pequeño, logrando una generación de alta velocidad en un único acelerador capaz.
El modelo admite actualizaciones nativas del aviso del sistema, lo que permite conversaciones estructuradas y controlables. También incluye un modo de pensamiento configurable para mejorar las capacidades de razonamiento. Con una ventana de contexto de hasta 256K tokens, DiffusionGemma puede manejar tareas de contexto largo de manera efectiva.
DiffusionGemma ha sido evaluado contra varios puntos de referencia, mostrando un rendimiento competitivo en tareas de generación de texto y razonamiento. Soporta capacidades multilingües, preentrenado en más de 140 idiomas, y ofrece robustas características de comprensión de imágenes y videos, incluyendo detección de objetos, análisis de documentos y análisis de contenido de video.
En general, DiffusionGemma es un modelo versátil diseñado para la generación de texto multimodal de alta velocidad, adecuado para una amplia gama de aplicaciones en creación de contenido, investigación y educación.
- CategoríaModelos de IA y LLM
- Modelo de preciosOpen Weights
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de DiffusionGemma
Difusión de Texto Discreta
Procesamiento de Entradas Multimodales
Arquitectura de Codificador-Decodificador
Eficiencia de Mixture-of-Experts
Modo de Pensamiento
Optimizado para Inferencia de Tamaño de Lote Pequeño
Soporte Nativo para Avisos del Sistema
Manejo de Contexto Largo
Primeros pasos con DiffusionGemma
Acceder a la página del modelo: Visita la página del modelo en Hugging Face
Autenticarse: Inicia sesión o crea una cuenta
Configurar: Establece los parámetros del modelo
Enviar avisos: Introduce avisos de texto, imagen o video
Ajustar: Modifica configuraciones para tareas específicas
Casos de uso de DiffusionGemma
- Generación de Texto
- Extracción de Datos de Imágenes
- Comprensión de Video
- Soporte Multilingüe
- Investigación y Educación