Descripción
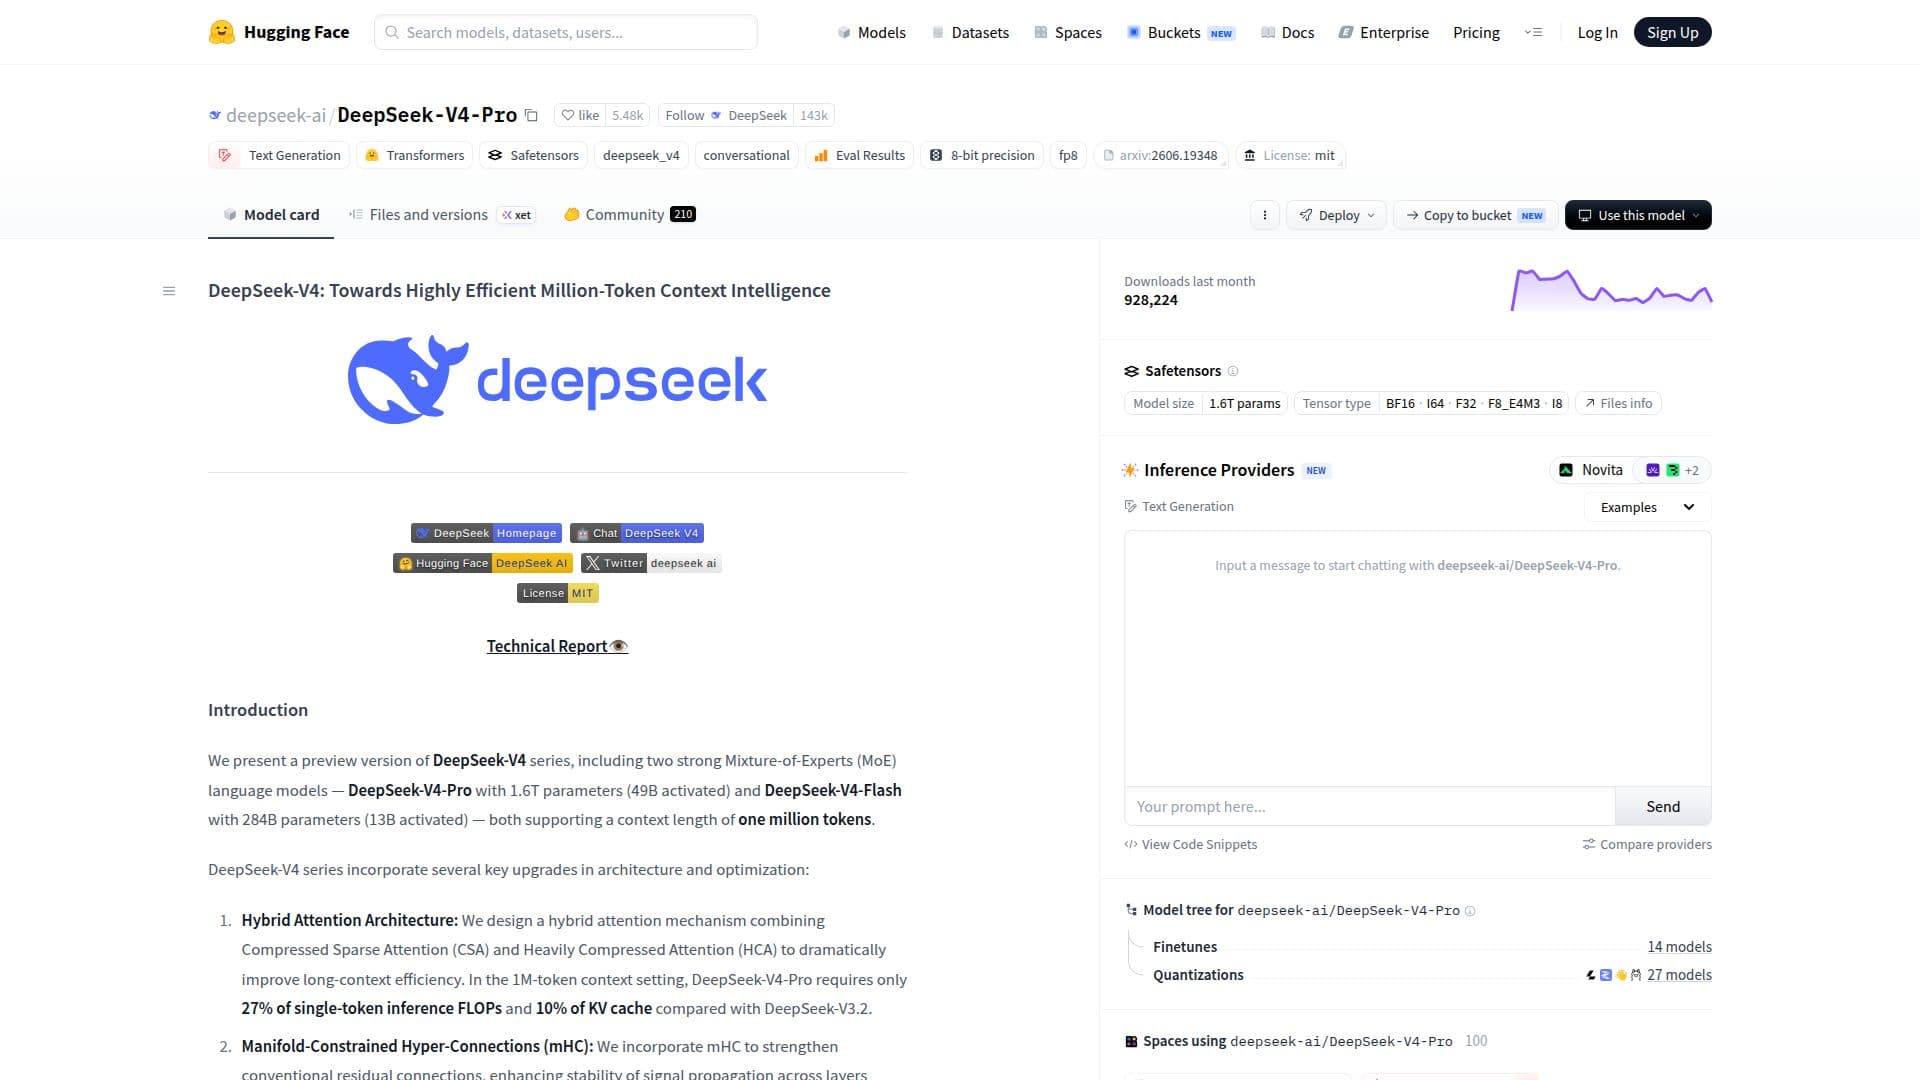
DeepSeek-V4-Pro es parte de la serie DeepSeek-V4, que tiene como objetivo avanzar y democratizar la inteligencia artificial a través de código abierto y ciencia abierta. Este modelo incorpora dos potentes modelos de lenguaje Mixture-of-Experts (MoE), con DeepSeek-V4-Pro que cuenta con 1.6 billones de parámetros y admite una longitud de contexto de un millón de tokens.
La arquitectura de DeepSeek-V4-Pro incluye varias mejoras clave, como un mecanismo de atención híbrido que combina Compressed Sparse Attention (CSA) y Heavily Compressed Attention (HCA). Este diseño mejora drásticamente la eficiencia en contextos largos, requiriendo solo el 27% de los FLOPs de inferencia de un solo token y el 10% de la caché KV en comparación con su predecesor, DeepSeek-V3.2. Además, el modelo emplea Manifold-Constrained Hyper-Connections (mHC) para mejorar la estabilidad en la propagación de señales a través de las capas mientras mantiene la expresividad del modelo.
Para asegurar una convergencia más rápida y una mayor estabilidad en el entrenamiento, se utiliza el optimizador Muon. El modelo está preentrenado en un conjunto de datos diverso de más de 32 billones de tokens, seguido de un pipeline de post-entrenamiento integral que incluye el cultivo independiente de expertos específicos de dominio y la consolidación unificada del modelo a través de la destilación en política.
DeepSeek-V4-Pro-Max, el modo de esfuerzo máximo de razonamiento de DeepSeek-V4-Pro, mejora significativamente las capacidades de conocimiento de los modelos de código abierto. Logra un rendimiento de primer nivel en benchmarks de codificación y cierra efectivamente la brecha con los modelos de código cerrado líderes en tareas de razonamiento y agentes. Las capacidades del modelo lo hacen adecuado para una amplia gama de aplicaciones, incluyendo la resolución de problemas complejos y tareas de planificación, convirtiéndolo en una herramienta valiosa para desarrolladores e investigadores en el campo de la IA.
Aspectos destacados de DeepSeek-V4-Pro
Tipo de Modelo: Mixture-of-Experts
Total de Parámetros: 1.6T
Parámetros Activados: 49B
Longitud de Contexto: 1M tokens
Arquitectura de Atención Híbrida: Sí
Optimizador Muon: Sí
Preentrenado en: 32T tokens
Licencia: MIT
Primeros pasos con DeepSeek-V4-Pro
Acceder al modelo: Visita la página de Hugging Face para DeepSeek-V4-Pro.
Autenticarse: Crea una cuenta si es necesario.
Configurar el entorno: Asegúrate de tener las bibliotecas y dependencias requeridas.
Integrar a través de API: Utiliza la documentación de API proporcionada para conectarte al modelo.
Optimizar: Ajusta los parámetros de muestreo para obtener el mejor rendimiento.
Casos de uso de DeepSeek-V4-Pro
- Resolución de Problemas Complejos
- Benchmarks de Codificación
- Aplicaciones de Investigación
- Procesamiento de Lenguaje Natural
- Tareas Agentes