Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

Cactus Runtime

LLM#82MLOps y despliegue de modelosCódigo abierto · macOS, Linux, Windows

Cactus Runtime proporciona binarios preconstruidos para los modelos Needle 3, Whistle y Mirage, permitiendo la ejecución local de tareas de texto, voz y visión. Soporta una amplia gama de plataformas, incluyendo macOS, Linux, Windows, Android, iOS, tvOS, watchOS y entornos web. Los desarrolladores pueden integrarlo a través de la API de Python o ejecutores nativos, con los pesos del modelo gestionados por separado.

Visitar URL
Compartir
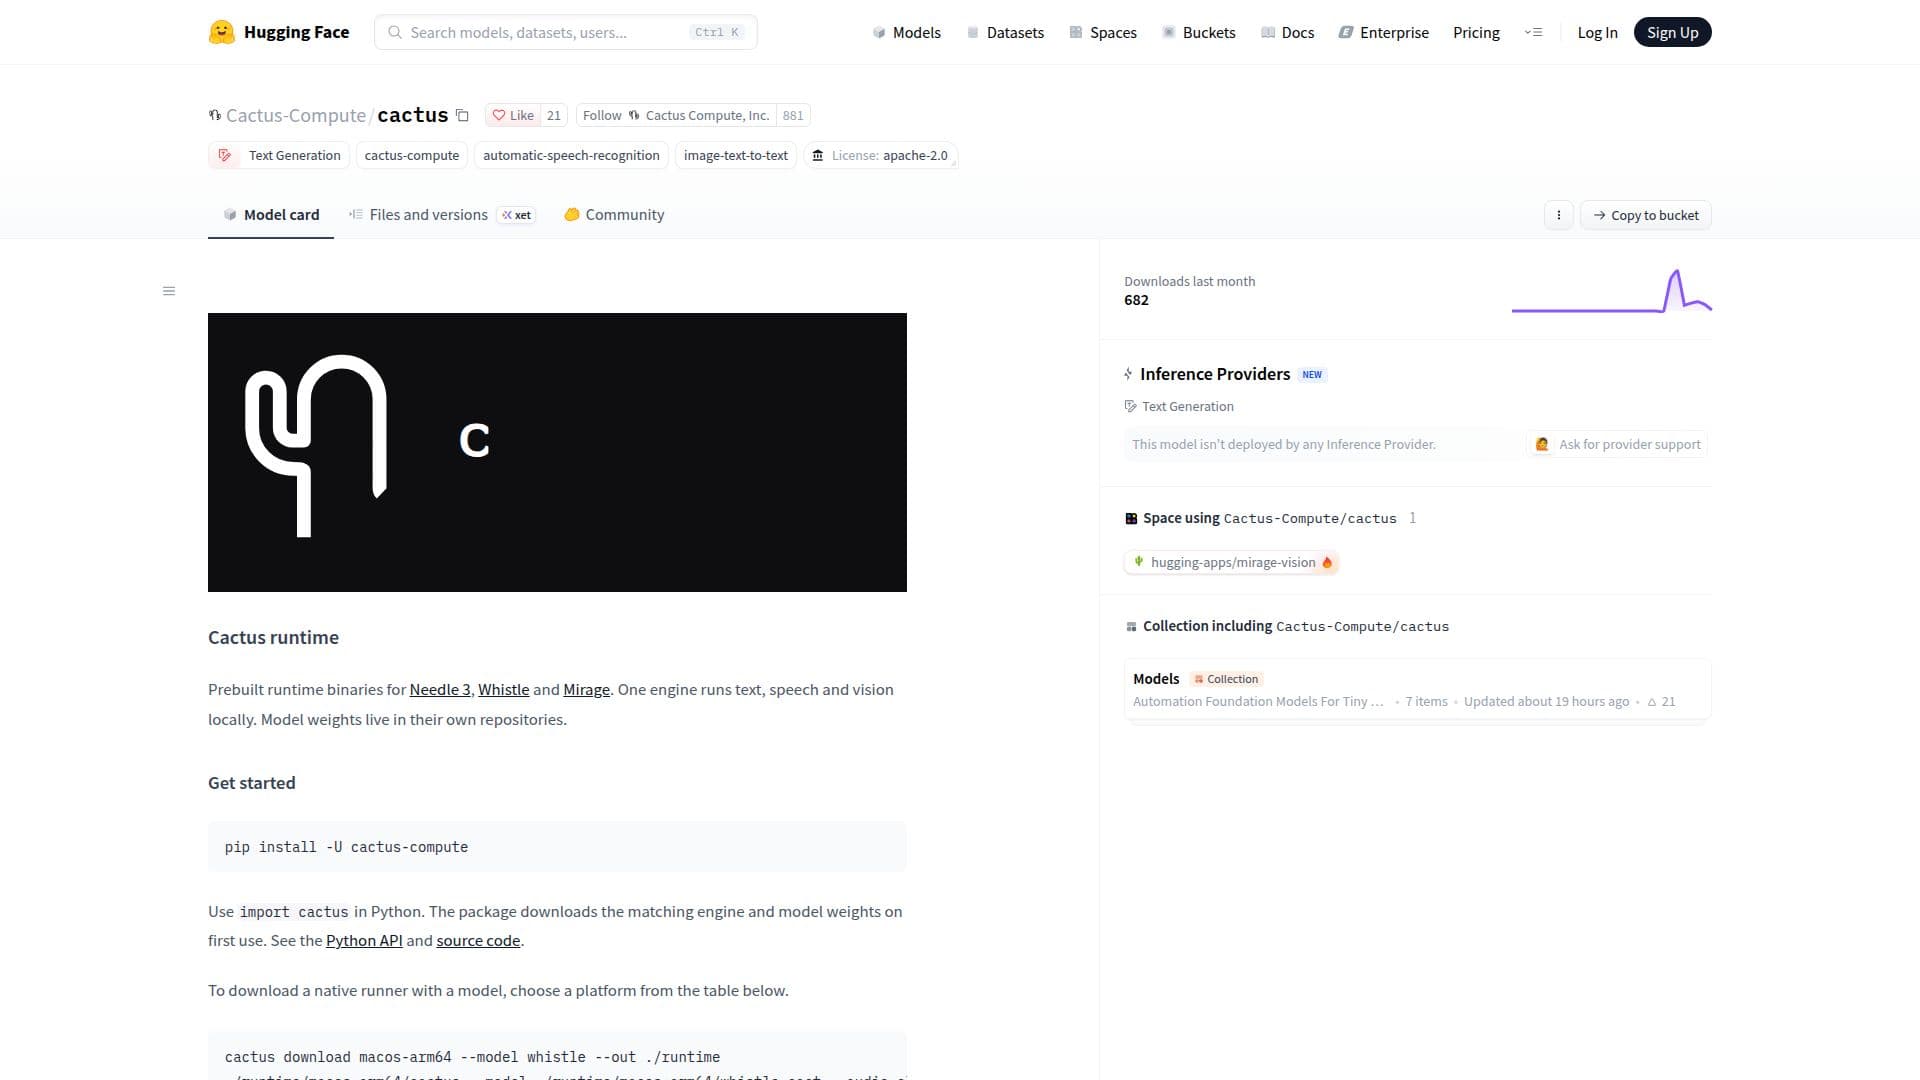
Captura de pantalla de Cactus Runtime

Cactus Runtime es un motor versátil diseñado para ejecutar modelos de texto, voz y visión localmente en varios sistemas operativos y entornos. Ofrece binarios de tiempo de ejecución preconstruidos para modelos específicos como Needle 3, Whistle y Mirage, permitiendo a los desarrolladores integrar potentes capacidades de IA directamente en sus aplicaciones.

Leer más

La funcionalidad principal de Cactus implica proporcionar un motor unificado que puede manejar diversas tareas de IA. Los pesos del modelo se almacenan en sus propios repositorios, asegurando flexibilidad y modularidad. Para los desarrolladores de Python, la integración es sencilla: simplemente importa `cactus`, y el paquete descarga automáticamente el motor y los pesos del modelo correspondientes en su primer uso. Una API de Python completa y el código fuente están disponibles para una implementación detallada.

Cactus soporta una extensa lista de plataformas, lo que lo hace altamente adaptable para diferentes escenarios de implementación. Estas incluyen macOS Apple Silicon, varias distribuciones de Linux (x86-64, ARM64, ARMv7, RISC-V, MIPS32el), Windows (x64, ARM64), Android (ARM64, ARMv7, RISC-V), iOS (ARM64, Simulator ARM64), tvOS ARM64, watchOS ARM64, e incluso entornos de navegador y Node.js a través de WebAssembly (WASM). Esta amplia compatibilidad asegura que los desarrolladores puedan desplegar sus modelos de IA en casi cualquier dispositivo o sistema objetivo.

Para la integración nativa, los desarrolladores pueden descargar ejecutores específicos para su plataforma elegida. Estos ejecutores están diseñados para cargar pesos `.cact` en tiempo de ejecución. Se proporcionan bibliotecas estáticas, incluyendo `cactus.h`, para aplicaciones en C y C++, facilitando la integración profunda en bases de código nativas existentes. Las ruedas de tiempo de ejecución de Python amplían aún más este soporte, cubriendo arquitecturas comunes de escritorio y servidor.

Cactus también ofrece un componente WASI, exportando `cactus:runtime/[email protected]`, y está disponible como un artefacto OCI firmado. Esto permite el despliegue en entornos de Interfaz de Sistema WebAssembly, ampliando su alcance a funciones sin servidor y otras aplicaciones modernas nativas de la nube. El proyecto enfatiza descargas reproducibles, proporcionando sumas de verificación SHA-256 y etiquetas de revisión específicas para los artefactos de lanzamiento. Una guía de implementación detallada está disponible para ayudar con la integración nativa, el uso en navegadores y la configuración fuera de línea.

  • CategoríaMLOps y despliegue de modelos
  • Modelo de preciosCódigo abierto
  • ImplementaciónSe ejecuta en local, Nube
  • PlataformasmacOS, Linux, Windows

  • Ejecución local de modelos de texto, voz y visión

  • Binarios de tiempo de ejecución preconstruidos para Needle 3, Whistle y Mirage

  • API de Python para una fácil integración

  • Descargas automáticas del motor y pesos del modelo en el primer uso (Python)

  • Soporte para macOS Apple Silicon

  • Soporte para Linux x86-64, ARM64, ARMv7, RISC-V, MIPS32el

  • Soporte para Windows x64 y ARM64

  • Soporte para Android ARM64, ARMv7, RISC-V

  • Soporte para iOS ARM64, iOS Simulator ARM64

  • Soporte para tvOS ARM64 y watchOS ARM64

  • Soporte para WebAssembly (WASM) para navegador y Node.js

  • Componente WASI para entornos de Interfaz de Sistema WebAssembly

  • Bibliotecas estáticas (libcactus.a, cactus.h) para aplicaciones en C/C++

  • Pesos del modelo gestionados en repositorios separados

  • Sumas de verificación SHA-256 para descargas reproducibles

  1. Instalar el paquete de Python: Usa `import cactus` en Python para descargar automáticamente el motor y los pesos del modelo.

  2. Descargar el ejecutor nativo: Elige una plataforma de la lista de soportadas y descarga los binarios correspondientes.

  3. Especificar el modelo: Usa `--model needle3` o `--model mirage` al ejecutar los ejecutores nativos para seleccionar un modelo específico.

  4. Integrar con C/C++: Incluye `cactus.h` y vincula `libcactus.a` en tus aplicaciones en C/C++.

  5. Desplegar con WASI: Utiliza el componente WASI `cactus:runtime/[email protected]` o el artefacto OCI para entornos WASI.

  6. Acceder a la API de Python: Consulta la documentación de la API de Python para un uso detallado y ejemplos de código fuente.

  • Ejecución Local de Modelos de IA
  • Desarrollo de IA Multiplataforma
  • Sistemas de IA Integrados
  • Aplicaciones de IA Basadas en la Web
  • Integración de Aplicaciones Nativas
  • Desarrollo de IA en Python
  • Procesamiento de IA Fuera de Línea
De Cactus Compute

Una función de Cactus Compute.

Reseñas de Cactus Runtime

Cargando...

Herramientas de IA populares como Cactus Runtime

Cactus Compute

Repositorios de IA en GitHub

Cactus Compute es un proyecto de código abierto centrado en la cuantización, núcleos, tiempo de ejecución y motores de inferencia para dispositivos móviles, dispositivos…

Plataformas de aprendizaje automático

N.º 182 en Repositorios de IA en GitHub

Ver herramienta

Repositorios de IA en GitHub

Proyecto de código abierto centrado en la cuantización, núcleos, tiempo de ejecución y motores de inferencia para dispositivos móviles, dispositivos…Cactus Compute es un proyecto de código abierto centrado en la cuantización, núcleos, tiempo de ejecución y motores de inferencia para dispositivos móviles, dispositivos…

Plataformas de aprendizaje automático
N.º 182 en Repositorios de IA en GitHub

SGLang-Omni

Repositorios de IA en GitHub

SGLang-Omni es un marco de servicio de alto rendimiento diseñado para modelos de audio como TTS y ASR, así como para modelos multimodales unificados. Proporciona un soporte…

MLOps y despliegue de modelos

N.º 78 en Generadores de voz con IA

Ver herramienta

Repositorios de IA en GitHub

Marco de servicio de alto rendimiento diseñado para modelos de audio como TTS y ASR, así como para modelos multimodales unificados. Proporciona un soporte…SGLang-Omni es un marco de servicio de alto rendimiento diseñado para modelos de audio como TTS y ASR, así como para modelos multimodales unificados. Proporciona un soporte…

MLOps y despliegue de modelos
N.º 78 en Generadores de voz con IA

Runware

Apps de IA

Runware es una plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…

MLOps y despliegue de modelos
Ver herramienta

Apps de IA

Plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…Runware es una plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…

MLOps y despliegue de modelos
Ver el Top 250 de Apps de IA

Replicate proporciona una API en la nube para ejecutar y ajustar modelos de aprendizaje automático de código abierto. Despliega modelos personalizados con una sola línea de…

MLOps y despliegue de modelos
Ver herramienta

Proporciona una API en la nube para ejecutar y ajustar modelos de aprendizaje automático de código abierto. Despliega modelos personalizados con una sola línea de…Replicate proporciona una API en la nube para ejecutar y ajustar modelos de aprendizaje automático de código abierto. Despliega modelos personalizados con una sola línea de…

DestacadaMLOps y despliegue de modelos
Ver el Top 150 de Plataformas de IA

SiliconFlow

Plataformas de IA

Una plataforma de infraestructura de IA para que los desarrolladores implementen, ajusten y ejecuten más de 200 LLMs y modelos multimodales optimizados a través de una API…

MLOps y despliegue de modelos
Ver herramienta

Plataformas de IA

Una plataforma de infraestructura de IA para que los desarrolladores implementen, ajusten y ejecuten más de 200 LLMs y modelos multimodales optimizados a través de una API…

DestacadaMLOps y despliegue de modelos
Ver el Top 150 de Plataformas de IA

Baseten

Plataformas de IA

La Plataforma de Inferencia de Baseten permite a los usuarios desplegar y escalar modelos de IA de código abierto y personalizados de manera eficiente. Ofrece inferencia de alto…

MLOps y despliegue de modelos

N.º 72 en Plataformas de IA

Ver herramienta

Plataformas de IA

La Plataforma de Inferencia de Baseten permite a los usuarios desplegar y escalar modelos de IA de código abierto y personalizados de manera eficiente. Ofrece inferencia de alto…

DestacadaMLOps y despliegue de modelos
N.º 72 en Plataformas de IA

SGLang

Frameworks de IA

SGLang es un marco de servicio de alto rendimiento diseñado para modelos de lenguaje grande y multimodales. Proporciona un amplio soporte de hardware y un ecosistema robusto para…

MLOps y despliegue de modelos
Ver herramienta

Frameworks de IA

Marco de servicio de alto rendimiento diseñado para modelos de lenguaje grande y multimodales. Proporciona un amplio soporte de hardware y un ecosistema robusto para…SGLang es un marco de servicio de alto rendimiento diseñado para modelos de lenguaje grande y multimodales. Proporciona un amplio soporte de hardware y un ecosistema robusto para…

DestacadaMLOps y despliegue de modelos
Ver el Top 50 de Frameworks de IA

TensorFold

Repositorios de IA en GitHub

TensorFold es un motor de inferencia LLM de código abierto diseñado para computación de alto rendimiento en diversas plataformas de hardware. Soporta Metal, CUDA y Vulkan,…

MLOps y despliegue de modelos
Ver herramienta

Repositorios de IA en GitHub

Motor de inferencia LLM de código abierto diseñado para computación de alto rendimiento en diversas plataformas de hardware. Soporta Metal, CUDA y Vulkan,…TensorFold es un motor de inferencia LLM de código abierto diseñado para computación de alto rendimiento en diversas plataformas de hardware. Soporta Metal, CUDA y Vulkan,…

MLOps y despliegue de modelos
Ver el Top 250 de Repositorios de IA en GitHub
1 de 8