Descripción
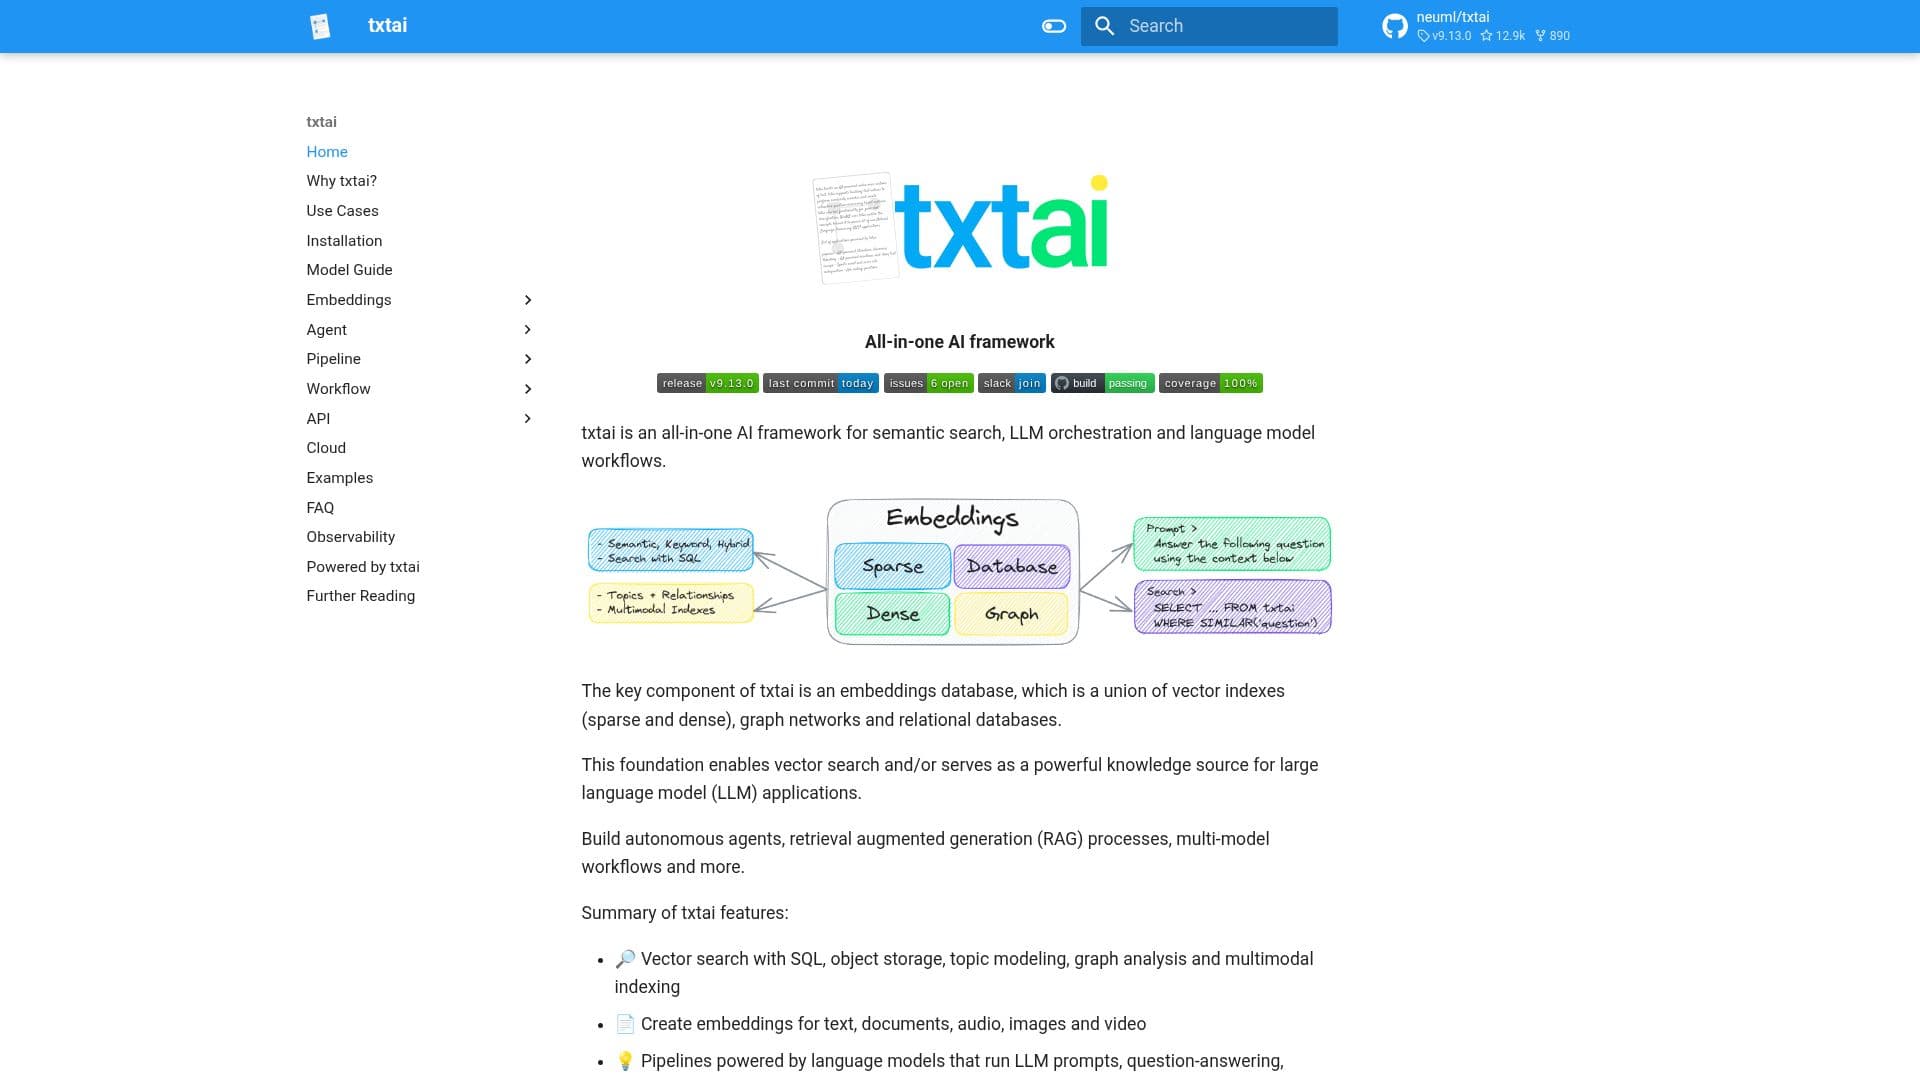
txtai es un marco de IA de código abierto todo en uno que facilita la búsqueda semántica, la orquestación de LLM y los flujos de trabajo de modelos de lenguaje. En su núcleo, txtai utiliza una base de datos de embeddings, combinando índices vectoriales, redes gráficas y bases de datos relacionales. Esta base soporta la búsqueda vectorial y sirve como una fuente de conocimiento robusta para aplicaciones de modelos de lenguaje grande (LLM).
Leer más
El marco permite a los usuarios construir agentes autónomos, procesos de generación aumentada por recuperación (RAG) y flujos de trabajo multimodales. Las características de txtai incluyen búsqueda vectorial con SQL, almacenamiento de objetos, modelado de temas, análisis gráfico e indexación multimodal. Puede crear embeddings para texto, documentos, audio, imágenes y video.
txtai soporta pipelines impulsados por modelos de lenguaje que ejecutan prompts de LLM, preguntas y respuestas, etiquetado, transcripción, traducción, resumen y más. Los flujos de trabajo pueden unir pipelines y agregar lógica empresarial, permitiendo que los procesos de txtai funcionen como microservicios simples o flujos de trabajo multimodales complejos.
El marco también incluye agentes que conectan inteligentemente embeddings, pipelines, flujos de trabajo y otros agentes para resolver problemas complejos de manera autónoma. txtai está construido con Python 3.10+, Hugging Face Transformers, Sentence Transformers y FastAPI, y es de código abierto bajo una licencia Apache 2.0.
NeuML, la empresa detrás de txtai, ofrece servicios de consultoría en IA y está desarrollando txtai.cloud para aplicaciones alojadas de manera fácil y segura. El marco es adecuado para desarrolladores y organizaciones que buscan implementar soluciones avanzadas de IA con flexibilidad y escalabilidad.
- CategoríaBases de datos vectoriales y recuperación
- Modelo de preciosCódigo abierto
- ImplementaciónNube, Local
- PlataformasPython, JavaScript, Java, Rust, Go
Características principales de txtai
Base de datos de embeddings para búsqueda vectorial
Capacidades de búsqueda semántica
Orquestación de LLM
Flujos de trabajo de modelos de lenguaje
Agentes autónomos
Generación aumentada por recuperación (RAG)
Indexación multimodal
Integración con Hugging Face Transformers
¿Cómo usar txtai?
Configurar: Establecer embeddings y pipelines
Usar: Implementar flujos de trabajo y agentes
Optimizar: Escalar con orquestación de contenedores
Desplegar: Ejecutar localmente o en la nube
Casos de uso de txtai
- Búsqueda Semántica
- Orquestación de LLM
- Agentes Autónomos
- Generación Aumentada por Recuperación
- Indexación Multimodal