Descripción
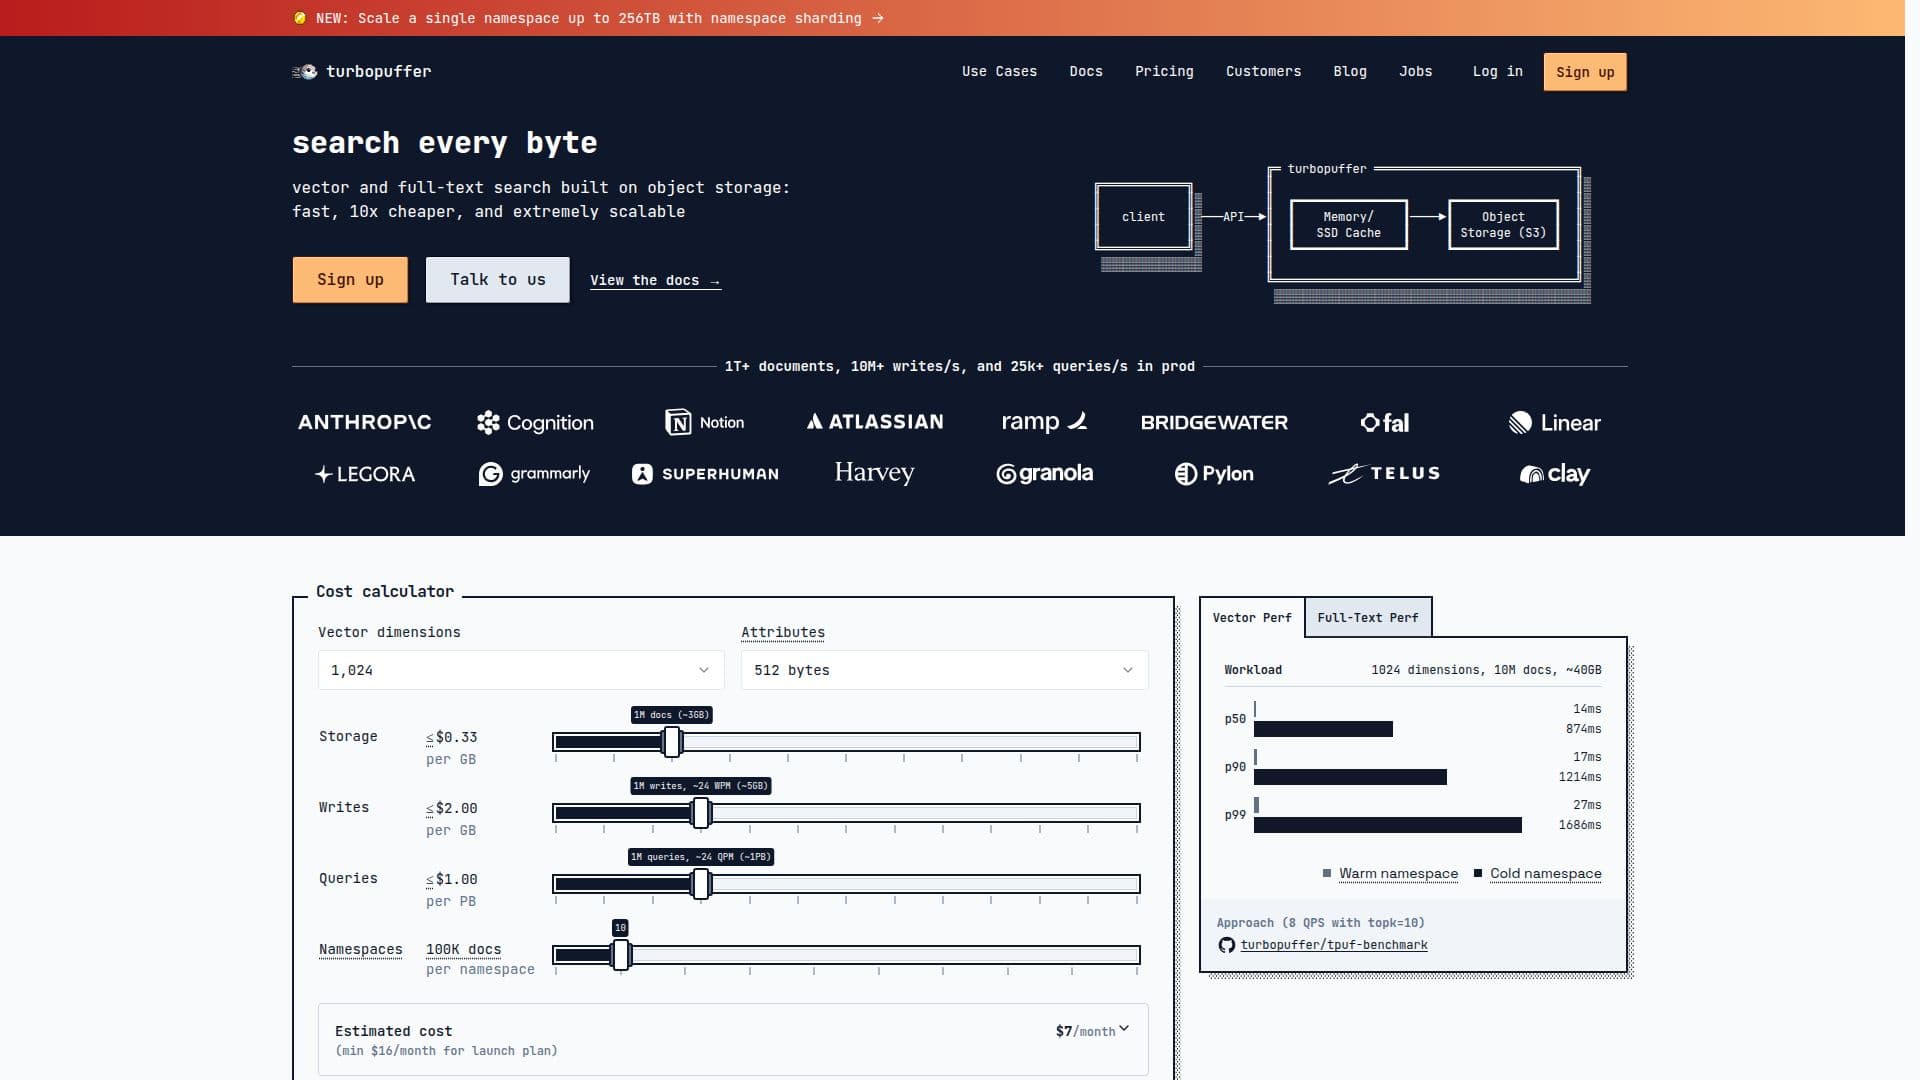
Turbopuffer está diseñado para hacer que cada byte sea buscable, proporcionando un motor de búsqueda rápido y escalable construido sobre almacenamiento de objetos. Soporta búsqueda vectorial y de texto completo, permitiendo a los usuarios buscar de manera eficiente a través de vastas cantidades de datos. Con la capacidad de manejar más de 1 billón de documentos, 10 millones de escrituras por segundo y 25,000 consultas por segundo, turbopuffer está diseñado para un alto rendimiento y fiabilidad.
Leer más
La arquitectura de turbopuffer aprovecha el almacenamiento de objetos como la única fuente de verdad, lo que permite un ahorro significativo de costos y escalabilidad. Al separar el cómputo y el almacenamiento, turbopuffer minimiza la complejidad operativa mientras asegura que los índices de búsqueda puedan escalar automáticamente para satisfacer la demanda. Este enfoque único permite a los usuarios crear espacios de nombres aislados para los datos, asegurando un estricto aislamiento y seguridad de los datos, lo que es particularmente beneficioso para industrias como la salud y las finanzas.
Turbopuffer es especialmente adecuado para organizaciones que requieren capacidades de búsqueda rápidas y fiables a través de grandes conjuntos de datos. Su diseño nativo de almacenamiento de objetos permite una indexación y recuperación eficientes, lo que lo convierte en una excelente opción para aplicaciones que necesitan buscar más de 10 millones de documentos. La plataforma también soporta una API unificada para varios tipos de búsqueda, incluyendo búsqueda vectorial densa y dispersa, búsqueda de texto completo y búsqueda regex, proporcionando flexibilidad para los desarrolladores.
Con un enfoque en el rendimiento, turbopuffer logra altas velocidades de consulta y baja latencia, convirtiéndolo en un fuerte competidor para las empresas que buscan mejorar sus capacidades de recuperación de datos. El modelo de precios se basa en el uso, lo que lo hace accesible para organizaciones de todos los tamaños, y está diseñado para escalar sin problemas a medida que crecen las necesidades de datos. En general, turbopuffer se destaca como una herramienta poderosa para conectar la IA con grandes cantidades de datos frescos, habilitando soluciones de búsqueda más inteligentes y eficientes.
- CategoríaBases de datos vectoriales y recuperación
- Modelo de preciosBasado en uso
- ImplementaciónNube
- PlataformasWeb
Características principales de turbopuffer
Búsqueda vectorial con >90% de recuperación
Capacidades de búsqueda de texto completo
Búsqueda regex con índices de trigramas rápidos
Despliegues multi-inquilino o de un solo inquilino
Opciones de cifrado con claves controladas por el cliente
Espacios de nombres ilimitados para el aislamiento de datos
Alto rendimiento de escritura de 10M+ escrituras/s
Manejo rápido de consultas con 25k+ consultas/s
¿Cómo usar turbopuffer?
Configurar: Configura tu entorno de turbopuffer y conéctalo a tu almacenamiento de objetos.
Indexar: Escribe tus documentos en turbopuffer para crear índices buscables.
Consultar: Usa la API unificada para realizar búsquedas en tus datos indexados.
Optimizar: Ajusta la configuración para el rendimiento de consultas y recuperación de datos según sea necesario.
Casos de uso de turbopuffer
- Búsqueda de Documentos
- Sistemas de Recomendación
- Recuperación de Datos para IA
- Aplicaciones Multi-Inquilino
- Búsqueda Web