Descripción
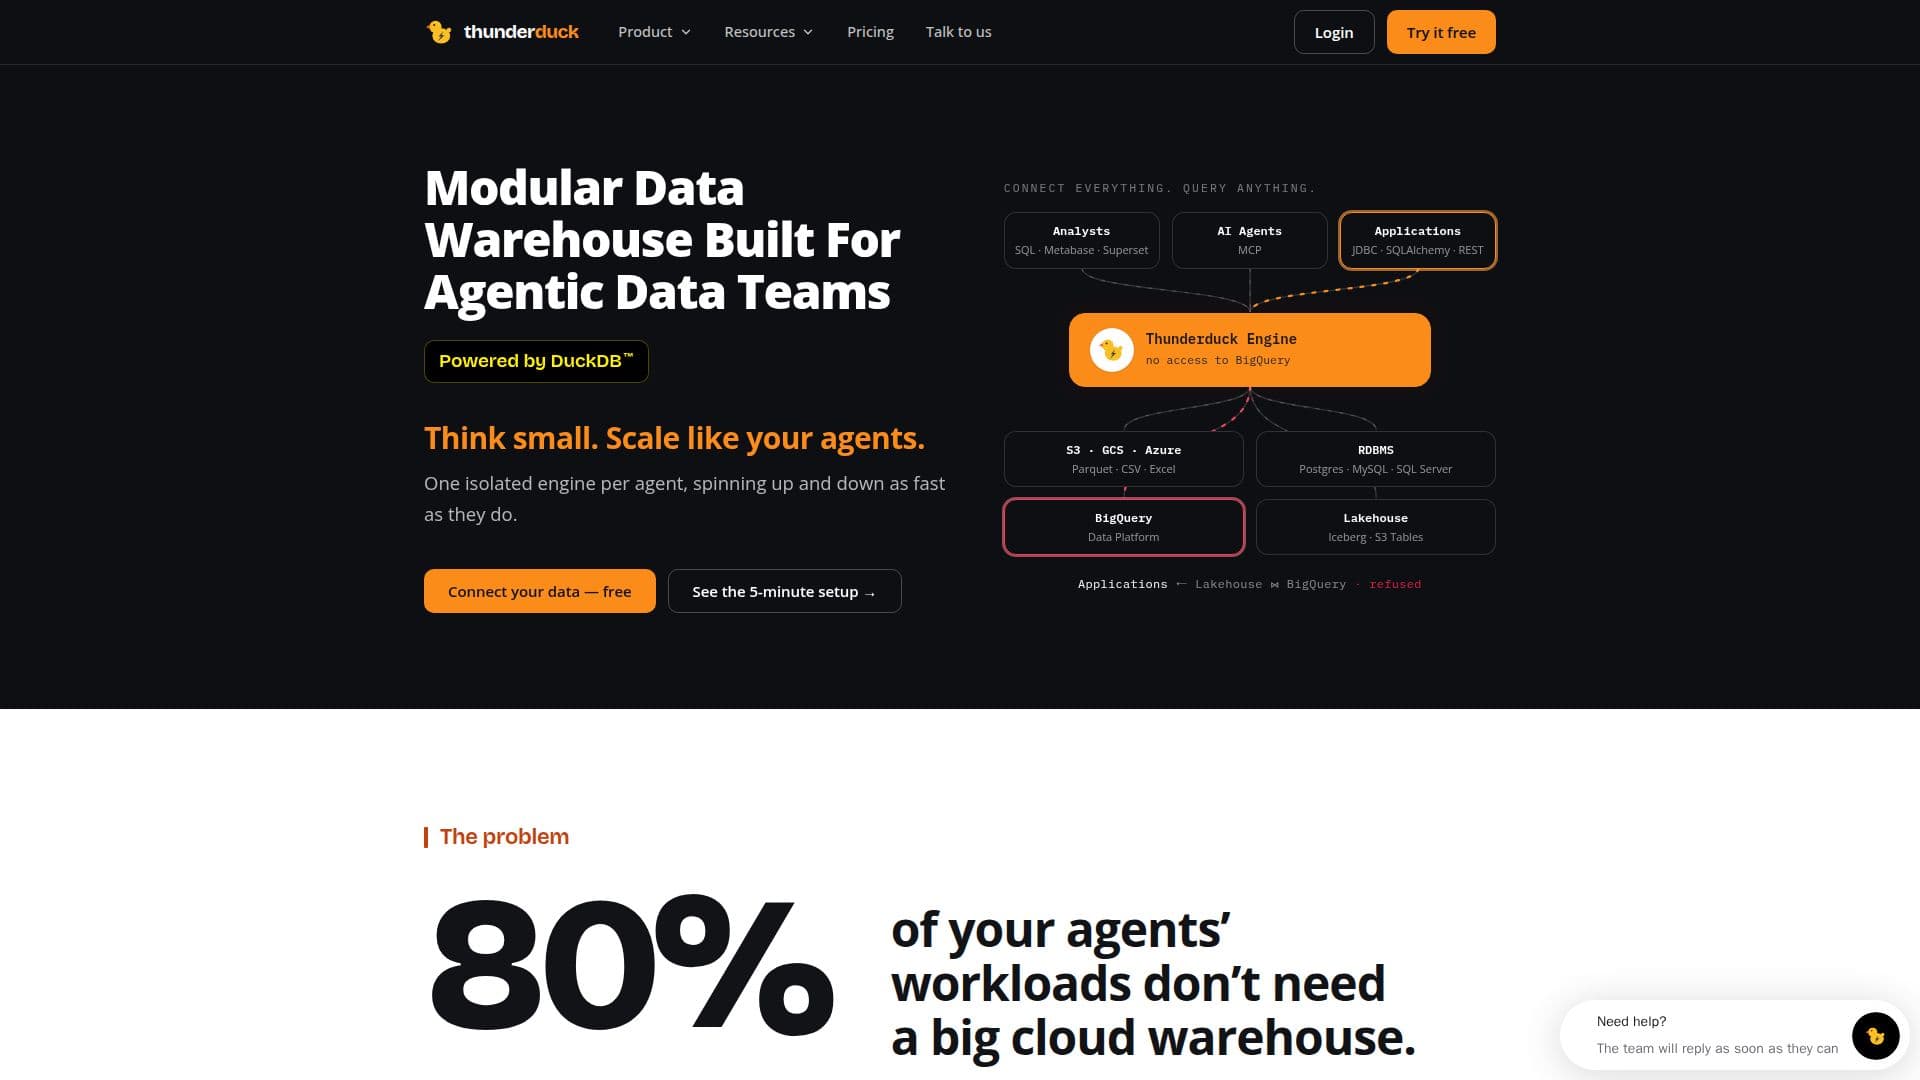
Thunderduck ofrece una solución de almacén de datos modular diseñada específicamente para equipos de datos agentes, aprovechando el poder de DuckDB. Aborda el problema común donde el 80% de las cargas de trabajo de los agentes no requieren un gran almacén en la nube, sin embargo, los equipos incurren en costos significativos de sistemas distribuidos y primas de servicios gestionados. Al proporcionar un motor aislado por agente, Thunderduck permite que los motores se inicien y se detengan rápidamente, coincidiendo con la naturaleza dinámica de las cargas de trabajo agentes.
Leer más
La plataforma está diseñada para ofrecer consultas en menos de un segundo sobre terabytes de datos, independientemente del número de agentes en funcionamiento. Simplifica la construcción de tuberías de datos y automatiza tareas de DevOps, todo mientras mantiene una gobernanza de nivel empresarial. Los usuarios tienen la flexibilidad de desplegar Thunderduck en cualquier lugar, ya sea en las instalaciones con flexibilidad similar a la nube o dentro de su infraestructura de nube existente.
En su núcleo, Thunderduck utiliza DuckDB, una base de datos analítica de código abierto y en proceso con un motor vectorizado. Esta arquitectura significa que se ejecuta donde se ejecuta su código, eliminando la necesidad de gestión de servidores. Soporta multi-tenencia y ofrece seguridad de nivel empresarial, asegurando la soberanía de los datos al mantener los datos dentro de la nube o centro de datos del usuario bajo sus reglas de acceso.
Thunderduck facilita la integración sin problemas con agentes de IA como Claude, ChatGPT o Cursor a través de MCP. Los agentes pueden interpretar los significados de tablas y columnas, no solo los nombres, para encontrar las tablas correctas, leer particiones e índices, y escribir consultas eficientes. Estas consultas se ejecutan bajo roles y límites de costo predefinidos. La plataforma también puede automatizar la construcción de modelos dbt, siguiendo capas de medallón, realizando pruebas en ramas y abriendo solicitudes de extracción para mantener los data marts limpios y manejables.
Soporta federación de consultas sin ETL, permitiendo a los usuarios unir datos de diversas fuentes como Postgres, BigQuery, tablas Iceberg y archivos en una sola consulta, con filtros aplicados a cada fuente. Esto elimina la necesidad de copias de datos, trabajos de carga o supervisión de sincronización para datos pequeños y ad-hoc. Cuando los conjuntos de datos crecen o requieren modelado, los usuarios pueden construir tuberías dbt en Iceberg y continuar consultándolos de manera consistente. Thunderduck también proporciona estimaciones de costos para cada consulta antes de que se ejecute, permitiendo el control del presupuesto y previniendo gastos inesperados.
- CategoríaHerramientas de SQL y bases de datos con IA
- Modelo de preciosFreemium
- ImplementaciónNube, Local
- PlataformasWeb
Características principales de Thunderduck
Arquitectura de almacén de datos modular
Un motor aislado de DuckDB por agente
Consultas en menos de un segundo sobre terabytes de datos
Opciones de despliegue en las instalaciones o en la nube
Tareas de DevOps automatizadas
Gobernanza de nivel empresarial
Soporte multi-inquilino
Menor latencia sin sobrecarga distribuida
Soberanía de datos y reglas de acceso
Integración con agentes de IA (Claude, ChatGPT, Cursor) a través de MCP
Generación de consultas asistida por IA y construcción de modelos dbt
Federación de consultas a través de diversas fuentes (PostgreSQL, BigQuery, Iceberg, S3)
Descubrimiento automático de esquemas, tablas, columnas y tipos
Estimación de costos y tiempo de ejecución para cada consulta antes de la ejecución
Diagnóstico de consultas fallidas impulsado por IA y sugerencias de soluciones
Control de acceso basado en roles para catálogos
Caché de consultas para consultas repetidas instantáneas y gratuitas
¿Cómo usar Thunderduck?
Conectar un Catálogo: Proporcione credenciales para sus fuentes de datos como bases de datos, almacenes, lakehouses o almacenamiento de objetos.
Descubrir Datos: Thunderduck lee automáticamente esquemas, tablas, columnas e infiere significados de columnas, manteniéndolos actualizados.
Consultar y Unir: Dirígete a cualquier tabla como catalogo.esquema.tabla y une a través de múltiples fuentes en una sola declaración SQL.
Integrar Agentes de IA: Conecte Claude, ChatGPT u otros clientes MCP para permitir que los agentes de IA naveguen por catálogos y ejecuten SQL.
Automatizar Flujos de Trabajo: Programe declaraciones SQL en un cronograma o conecte repositorios dbt para ejecutar construcciones, pruebas y instantáneas.
Monitorear y Gobernar: Utilice estimaciones de costos previas a la consulta, registros de auditoría y control de acceso basado en roles para gestionar el uso y la seguridad.
Casos de uso de Thunderduck
- Cargas de Trabajo de Datos Agentes
- Optimización de Costos para Equipos de Datos
- Análisis de Datos en Tiempo Real
- Automatización de Tuberías de Datos
- Soberanía y Seguridad de Datos
- Consulta Asistida por IA
- Unión de Datos de Fuentes Cruzadas
- Gestión Proactiva de Costos
- Gobernanza y Auditoría de Datos
- Construcción de Lakehouses