Descripción
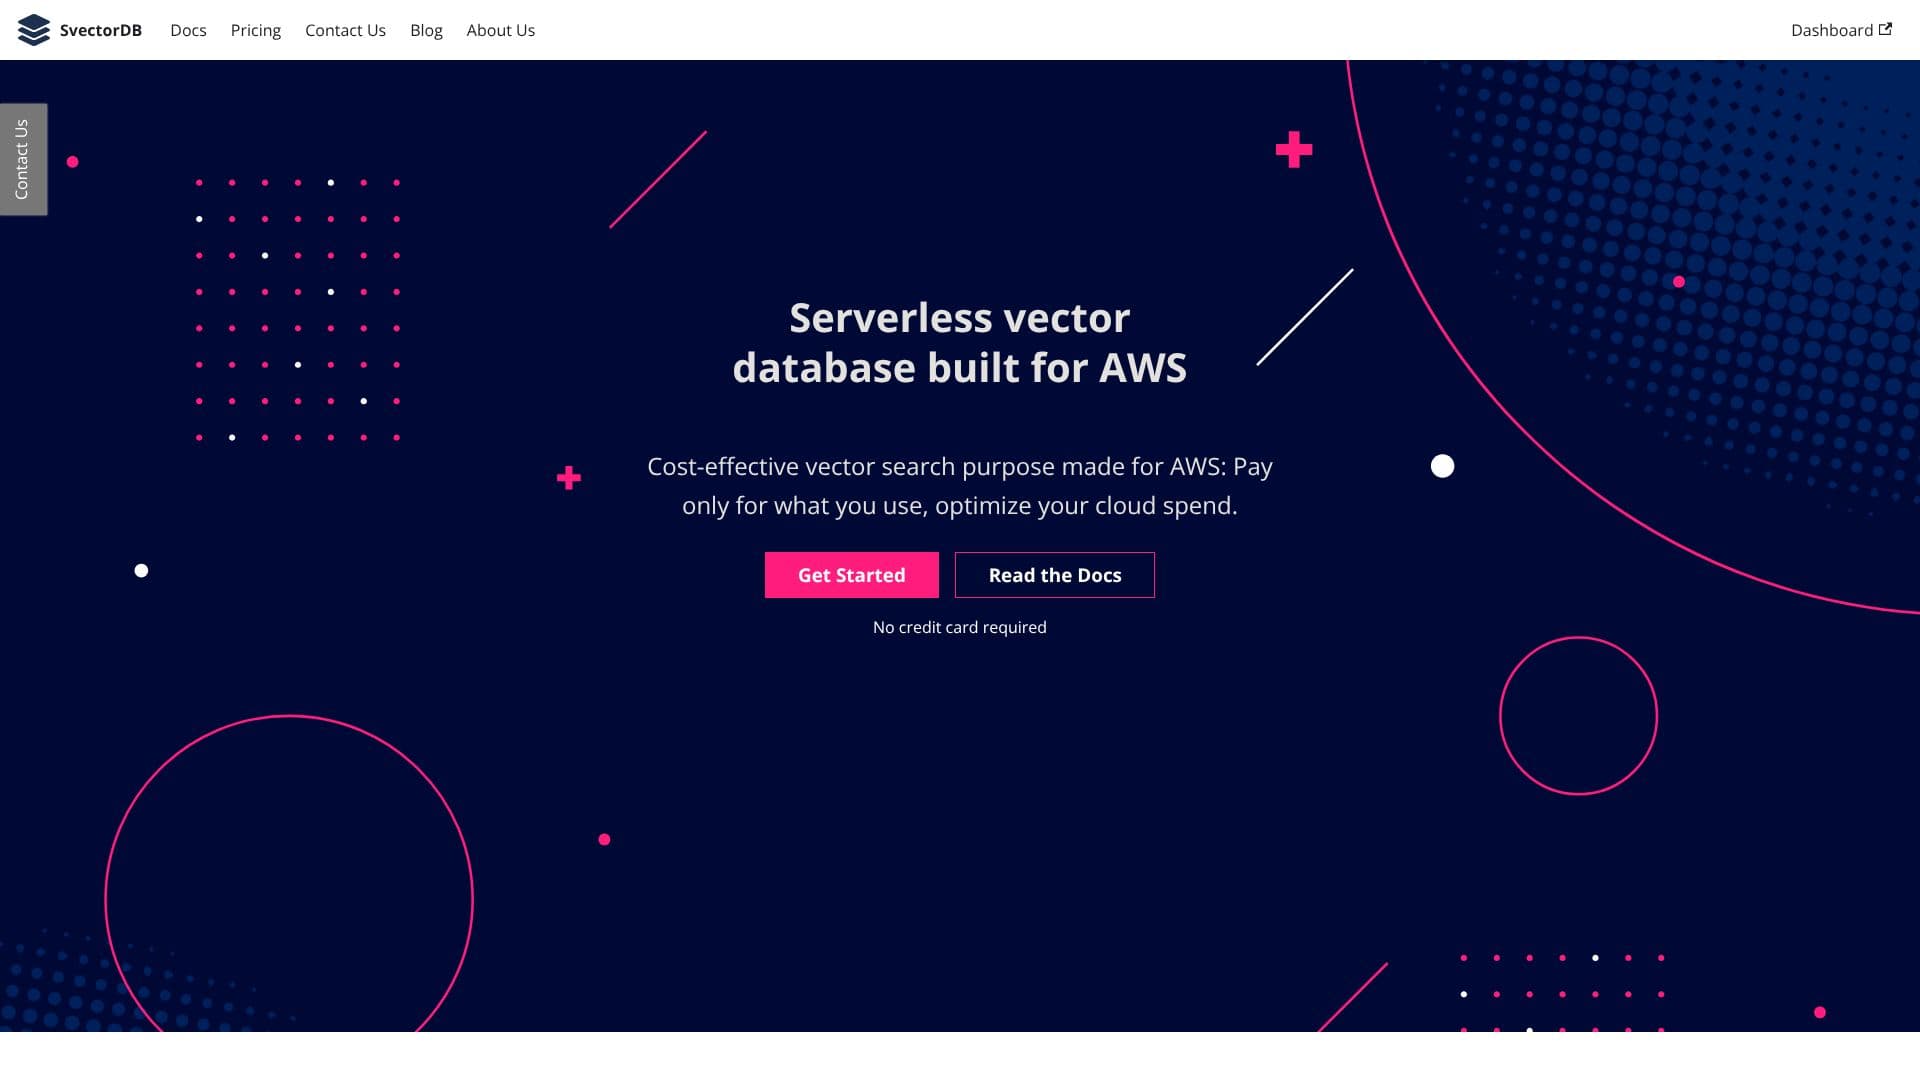
SvectorDB es una base de datos vectorial construida desde cero para entornos serverless, lo que permite a los desarrolladores centrarse en su producto en lugar de en la gestión de la base de datos. Simplifica la escalabilidad de un vector único a millones, proporcionando una solución de alto rendimiento y rentable que puede ser hasta 20 veces más económica que las alternativas. La plataforma admite un inicio rápido con SDK intuitivos de JavaScript y Python, así como una especificación OpenAPI para la integración con cualquier idioma.
Leer más
Las capacidades clave incluyen la búsqueda híbrida, que permite filtrar los resultados basándose en pares clave-valor junto con la similitud vectorial. SvectorDB ofrece actualizaciones instantáneas para inserciones y eliminaciones, eliminando las preocupaciones sobre la consistencia eventual. Su arquitectura nativamente serverless significa precios por solicitud sin necesidad de aprovisionamiento o escalado. El soporte de CloudFormation permite una fácil integración en la infraestructura existente. Los usuarios pueden aprovechar los vectorizadores integrados para texto e imágenes o aportar sus propios embeddings.
El modelo de precios es transparente y por solicitud, sin tarifas mínimas ni costos iniciales. El almacenamiento tiene un precio de $0.25 por GB por mes, y las consultas cuestan $5 por millón de operaciones. Las escrituras cuestan $20 por millón de operaciones. Hay un nivel gratuito disponible, que ofrece hasta 10 índices de nivel gratuito con hasta 5,000 registros cada uno, sin límite de tiempo.
SvectorDB es desarrollado por una micro startup, enfatizando la transparencia y la interacción directa con el cliente. Si bien esto ofrece hiper-respuesta, los clientes potenciales deben ser conscientes de las limitaciones, como la ausencia de instantáneas de la base de datos y un límite máximo predeterminado de 1 millón de registros por base de datos, que se puede aumentar contactando al soporte. El tamaño de la empresa también es un factor a considerar para algunos clientes.
Los casos de uso abarcan motores de recomendación, búsqueda de documentos e imágenes, y generación aumentada por recuperación para mejorar los modelos de IA generativa. La plataforma admite la incrustación de texto e imágenes utilizando modelos como ALL_MINILM_L6_V2 y CLIP_VIT_BASE_PATH32, o embeddings personalizados.
- CategoríaBases de datos vectoriales y recuperación
- Modelo de preciosPago por solicitud
- ImplementaciónSin servidor
Características principales de SvectorDB
Arquitectura serverless
Precios por solicitud
Capacidades de búsqueda híbrida
Actualizaciones instantáneas para operaciones de datos
Vectorizadores integrados para texto e imágenes
Soporte para embeddings personalizados
Especificación OpenAPI para amplio soporte de idiomas
Integración con CloudFormation
Escala desde prototipo hasta producción
Rentable en comparación con alternativas
Nivel gratuito disponible
Modelo de precios transparente
¿Cómo usar SvectorDB?
Configurar: Establezca su ID de base de datos y elija su SDK preferido (JavaScript, Python) o OpenAPI.
Incrustar datos: Utilice los vectorizadores integrados o sus propios embeddings para convertir texto o imágenes en vectores.
Almacenar datos: Utilice la función `setItem` (o `set_item`) para almacenar elementos con sus valores y vectores.
Consultar datos: Realice búsquedas de similitud vectorial o consultas basadas en claves utilizando la función `query`.
Filtrar resultados: Utilice la búsqueda híbrida para filtrar resultados por pares clave-valor junto con la similitud vectorial.
Escalar: SvectorDB maneja automáticamente la escalabilidad desde prototipos pequeños hasta millones de vectores.
Integrar: Conecte SvectorDB en sus aplicaciones existentes y plantillas de CloudFormation.
Casos de uso de SvectorDB
- Motores de Recomendación
- Búsqueda de Documentos
- Búsqueda de Imágenes
- Generación Aumentada por Recuperación
- Prototipado de Funciones de IA
- Filtrado y Análisis de Datos