Descripción
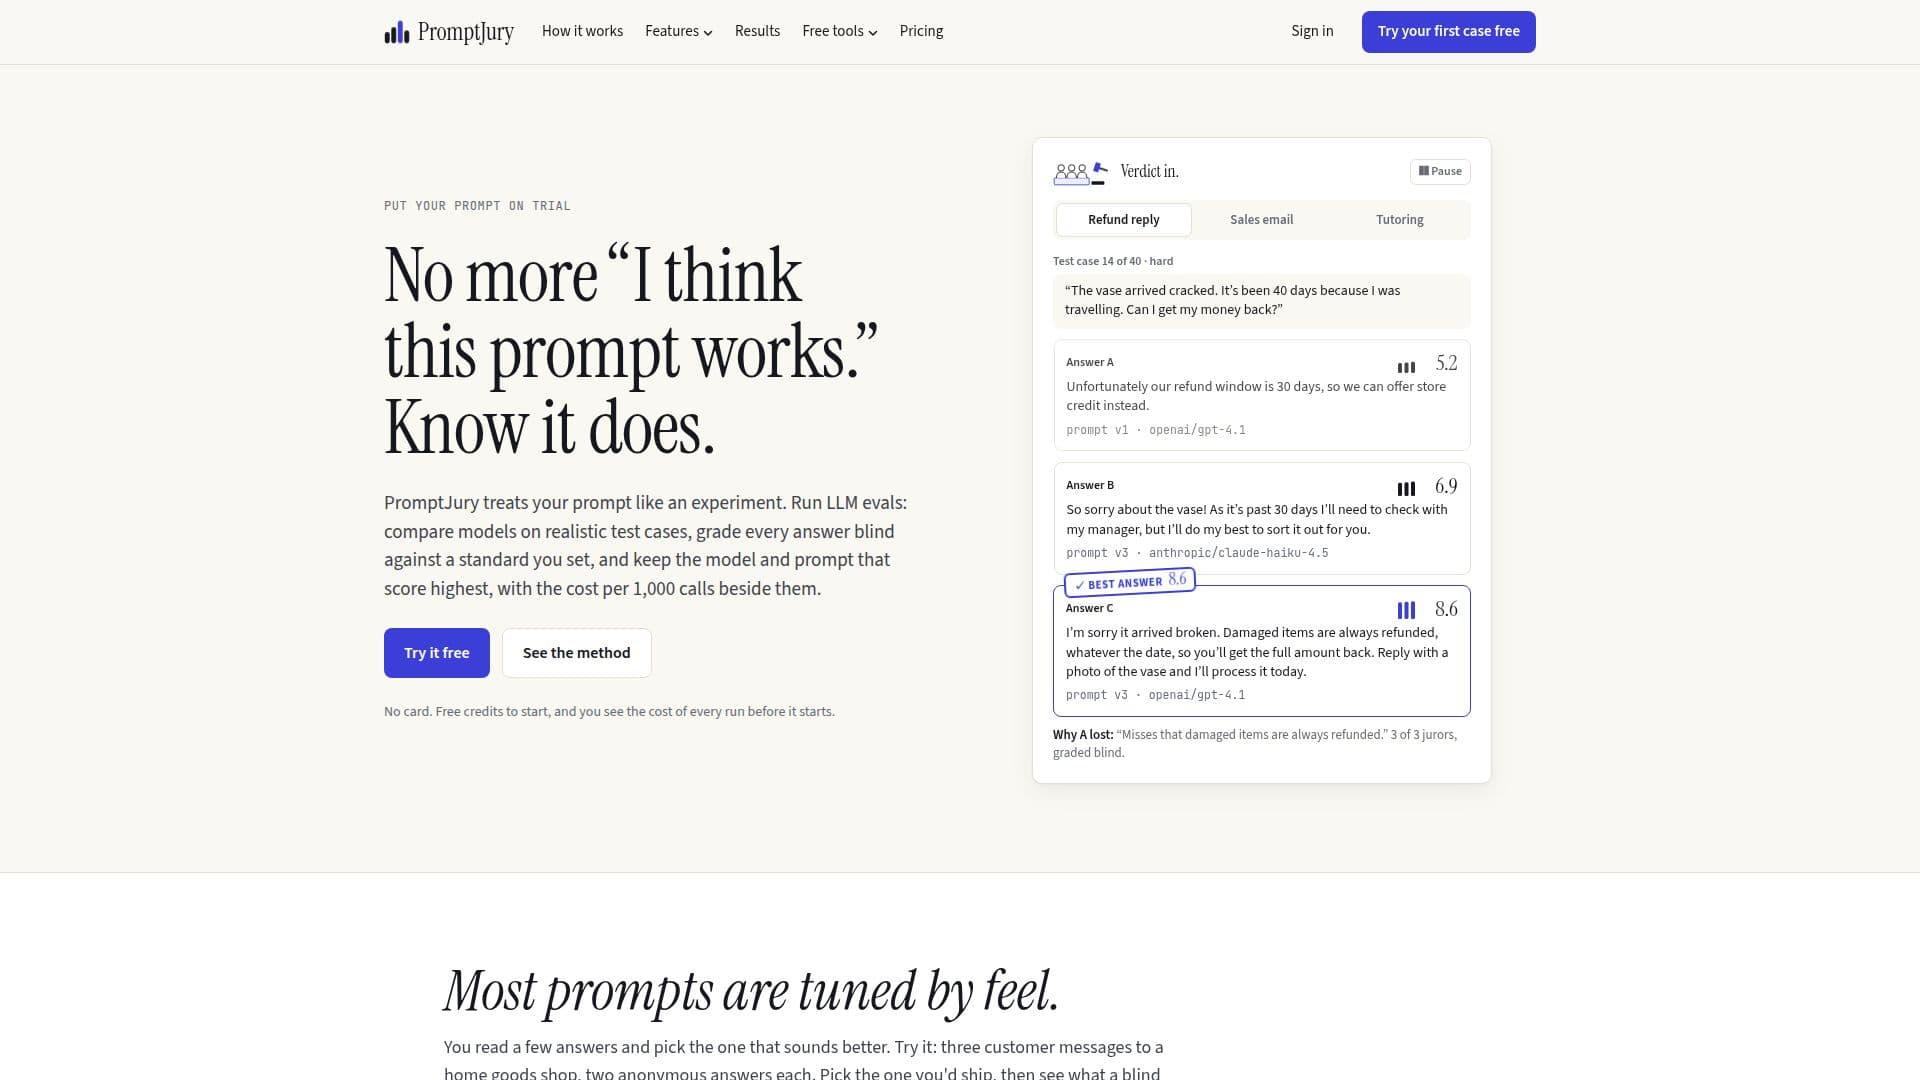
PromptJury ofrece una plataforma integral para evaluar Modelos de Lenguaje Grande (LLMs) y prompts, diseñada para ayudar a los usuarios a tomar decisiones basadas en datos sobre sus aplicaciones de IA. El servicio permite a individuos y equipos realizar evaluaciones de LLM en sus prompts personalizados, comparando modelos como GPT, Claude y Gemini en casos de prueba calificados de forma ciega.
Leer más
Este proceso revela qué combinaciones de modelos y prompts logran las puntuaciones más altas y cuál es el costo de cada opción, proporcionando un enfoque científico para la ingeniería de prompts.
A diferencia de las plataformas de evaluación centradas en desarrolladores que requieren SDKs, configuraciones personalizadas y conjuntos de pruebas proporcionados por el usuario, PromptJury simplifica todo el flujo de trabajo de evaluación. Genera automáticamente guías de calificación y casos de prueba, redacta prompts rivales y realiza calificaciones ciegas utilizando un jurado diverso de modelos de varios fabricantes. La plataforma luego entrega una recomendación clara, incluyendo el prompt ganador, el modelo y su costo asociado, todo sin requerir experiencia en codificación.
PromptJury asegura el rigor científico de sus evaluaciones al establecer una definición clara de una «buena respuesta» antes de que comience cualquier puntuación. Cada prompt y modelo se somete al mismo conjunto de casos de prueba, y la calificación se realiza de forma ciega. Cada puntuación se presenta con un rango, permitiendo a los usuarios evaluar con precisión el impacto de cualquier cambio realizado en sus prompts o modelos. El sistema aborda las preocupaciones sobre la calificación de IA por IA al garantizar que el estándar de calificación sea aprobado por el usuario, múltiples modelos de diferentes fabricantes califican respuestas sin conocer la fuente, y ningún modelo califica su propia salida. La puntuación mediana de tres o más evaluadores previene sesgos de un jurado único, ya sea severo o generoso.
Los usuarios pueden comparar cualquier modelo de chat disponible en la lista en vivo de OpenRouter, incluyendo ofertas de OpenAI, Anthropic, Google, xAI, DeepSeek y Mistral. La plataforma también ayuda a identificar modelos más económicos que rinden de manera comparable a los principales contendientes, proporcionando una «selección de valor» junto al ganador. Esto incluye datos de costo por 1,000 llamadas y posibles ahorros mensuales basados en volúmenes de llamadas definidos por el usuario. Las nuevas cuentas reciben 200 créditos gratuitos para realizar una evaluación inicial sin requerir una tarjeta de crédito, con planes de pago a partir de $25 al mes. El servicio no requiere claves de API, SDKs o una cuenta de OpenRouter, ya que todas las llamadas a modelos se gestionan a través de la propia cuenta de OpenRouter de PromptJury y se pagan con créditos de usuario. La plataforma admite salidas subjetivas al permitir a los usuarios definir dimensiones de calidad con ejemplos escritos para la calificación. Los usuarios también pueden cargar sus propios casos de prueba a través de archivos CSV o JSONL o editar los generados por el sistema. PromptJury declara explícitamente que no entrena con los prompts o datos de los usuarios, asegurando privacidad y control sobre el contenido del usuario.
- CategoríaHerramientas de ingeniería de prompts
- Modelo de preciosFreemium
- ImplementaciónNube
- PlataformasWeb
Características principales de PromptJury
Plataforma de Evaluación de LLM
Comparar GPT, Claude, Gemini y otros modelos
Casos de prueba calificados de forma ciega
Generación automatizada de casos de prueba
Creación automatizada de guías de calificación
Redacta prompts rivales
Proceso de evaluación sin código
Costo por 1,000 llamadas mostrado
Identifica selección de valor (modelo bueno más barato)
Admite calificación de salidas subjetivas
Cargar casos de prueba personalizados (CSV, JSONL)
No se requiere clave de API ni SDK
No entrena con datos de usuario
Pruebas de regresión programadas (reintentos)
Informes de veredicto privados
¿Cómo usar PromptJury?
Describir Tarea: Define el objetivo de tu IA y su audiencia en dos oraciones.
Crear Guía de Calificación: Aprueba cómo se ve una gran respuesta, dimensión por dimensión, con una escala para cada una.
Generar Prompts Competitivos: Permite que los modelos redacten prompts rivales y se critiquen entre sí según tu guía de calificación.
Reunir Casos de Prueba: Usa entradas realistas generadas por el sistema o carga tu propio archivo CSV/JSONL.
Ejecutar Prueba Ciega: Cada prompt y modelo responde a cada caso de prueba, con un panel separado calificando respuestas de forma ciega.
Revisar Veredicto y Mejorar: Obtén el mejor prompt y modelo, con pruebas y sugerencias para mejorar aún más.
Casos de uso de PromptJury
- Optimización de Prompts
- Comparación de Modelos
- Aseguramiento de Calidad
- Eficiencia de Costos
- Calificación de Salidas Subjetivas
- Pruebas de Regresión
- Informes para Clientes
- Desarrollo de Funciones de IA