Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

GPUX

GPUX ofrece inferencia GPU sin servidor para modelos de IA, permitiendo la rápida implementación y ejecución de cargas de trabajo de aprendizaje automático. Proporciona arranques en frío rápidos, soporta varios modelos de IA como Stable Diffusion XL y Whisper, y permite a los usuarios ejecutar inferencias o vender solicitudes en modelos privados, haciendo la IA accesible y eficiente.

Visitar URL
Compartir
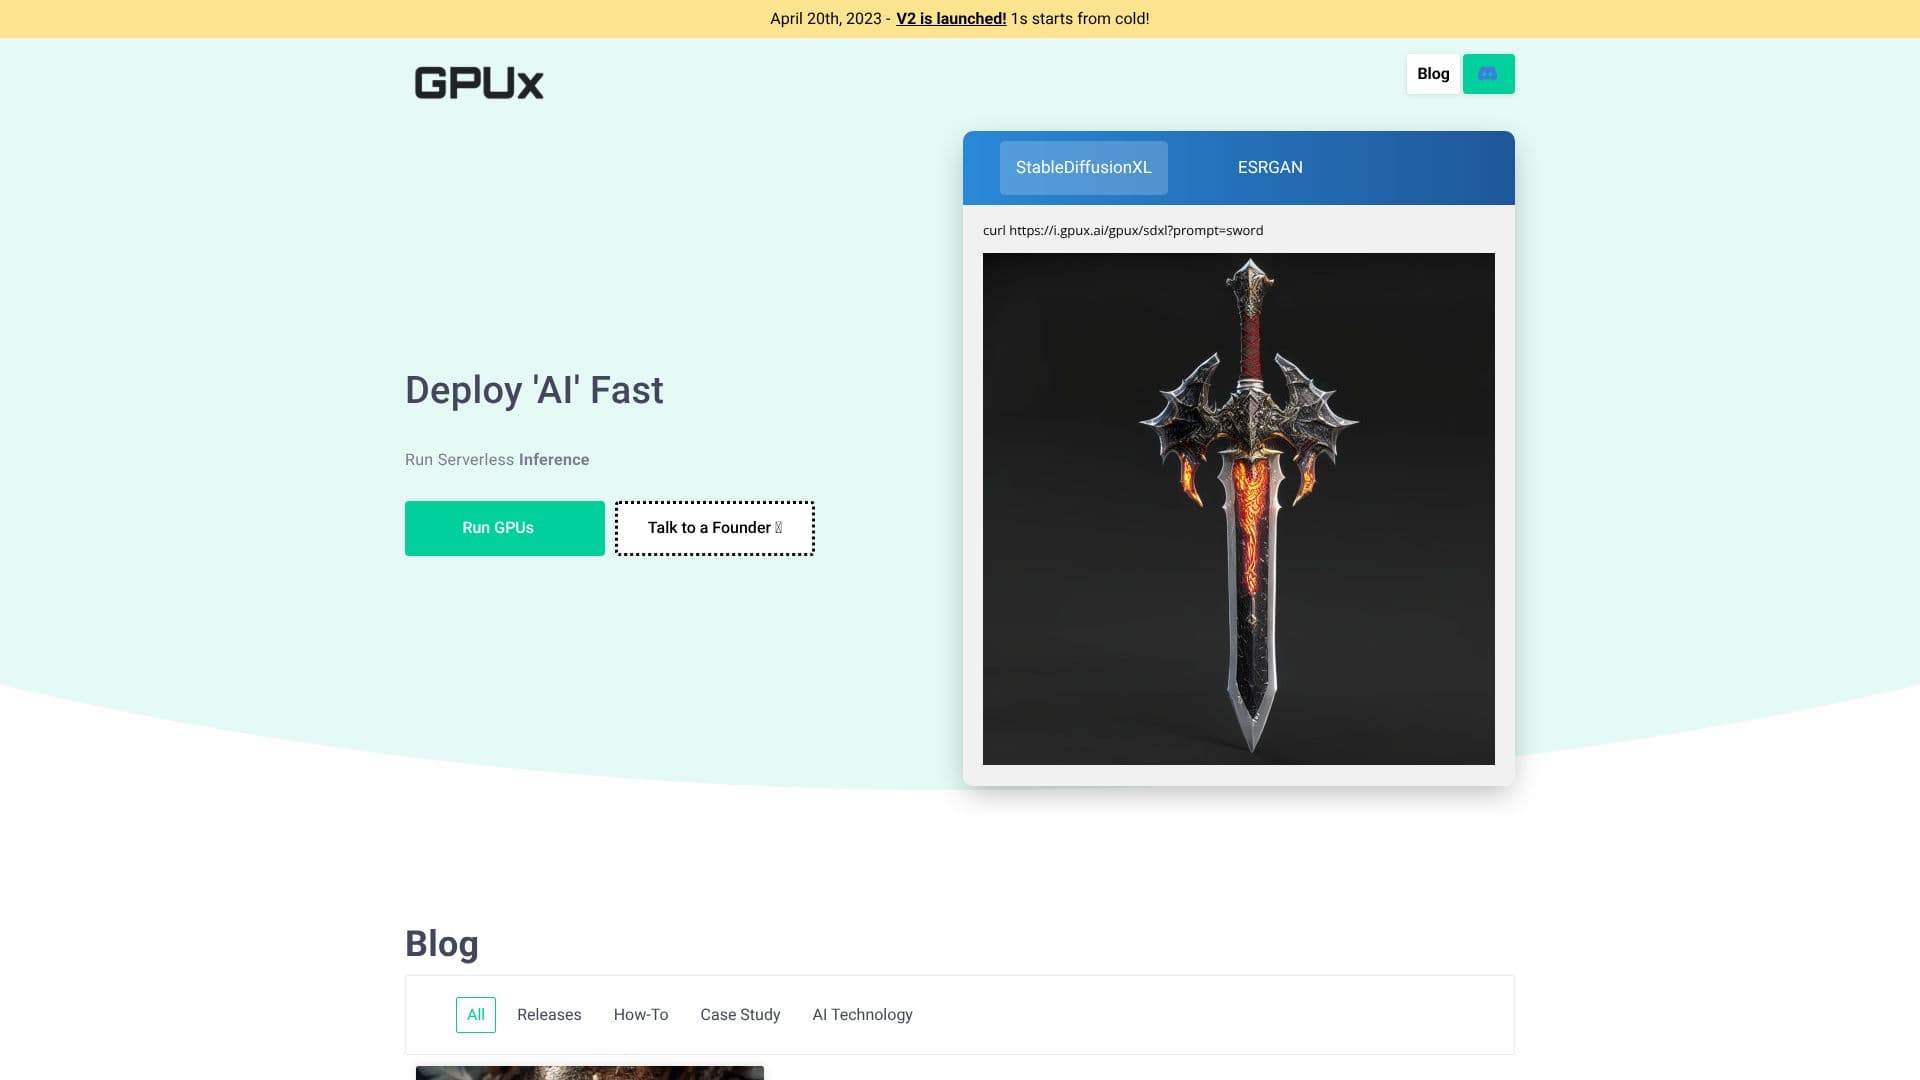
Captura de pantalla de GPUX

GPUX es una plataforma de inferencia sin servidor diseñada para acelerar la implementación y ejecución de modelos de IA y aprendizaje automático. Lanzada con la V2 el 20 de abril de 2023, GPUX se enfoca en proporcionar arranques en frío rápidos, con instancias que comienzan desde solo 1 segundo. Esta capacidad es crucial para aplicaciones que requieren una respuesta inmediata.

Leer más

La plataforma soporta una variedad de modelos de IA populares, incluyendo Stable Diffusion XL (SDXL), ESRGAN y WHISPER, lo que la hace versátil para diversas tareas de IA como la generación de imágenes, el escalado y la conversión de voz a texto. GPUX permite a los usuarios implementar sus modelos de IA y ejecutar inferencias sin servidor, abstraendo las complejidades de la gestión de infraestructura.

Más allá de ejecutar inferencias, GPUX ofrece una característica única para monetizar modelos de IA. Los usuarios pueden vender solicitudes de inferencia en sus modelos privados a otras organizaciones, creando un mercado para capacidades de IA. Este modelo peer-to-peer (P2P) puede generar ingresos para los propietarios de modelos, al tiempo que proporciona acceso a IA especializada para otras empresas.

GPUX enfatiza la importancia del "ajuste correcto" para las cargas de trabajo de aprendizaje automático, trazando un paralelismo con cómo Nike ahora diseña tacos especializados para mujeres. Esto significa adaptar la infraestructura y la implementación a las necesidades específicas de la tarea de IA. La plataforma soporta características como Volúmenes ReadWrite, mejorando la flexibilidad para el manejo de datos durante la inferencia.

El público objetivo de GPUX incluye desarrolladores, científicos de datos y organizaciones que buscan implementar y escalar modelos de IA de manera eficiente sin gestionar el hardware subyacente. La plataforma tiene como objetivo democratizar el acceso a la computación GPU para la inferencia de IA, haciéndola más rápida y rentable. El equipo detrás de GPUX incluye a Annie (Marketing), Ivan (Tecnología) y Henry (Operaciones), con información de contacto y perfiles de LinkedIn proporcionados para la interacción.

GPUX también ofrece recursos como un blog con artículos sobre tecnología de IA, guías prácticas y estudios de caso. Publicaciones recientes del blog destacan mejoras de rendimiento, como hacer que Stable Diffusion XL sea un 50% más rápido en RTX 4090, demostrando un compromiso con la optimización y la educación del usuario. La plataforma está construida con un enfoque en la facilidad de uso y el rendimiento, permitiendo a los usuarios "Implementar IA Rápidamente".

  • CategoríaMLOps y despliegue de modelos
  • ImplementaciónSin servidor
  • PlataformasWeb

  • Inferencia GPU sin servidor

  • Arranques en frío de 1 segundo

  • Soporte para Stable Diffusion XL

  • Soporte para WHISPER

  • Soporte para ESRGAN

  • Ejecutar inferencia en modelos desplegados

  • Vender solicitudes de inferencia en modelos privados

  • Soporte para Volúmenes ReadWrite

  • Modelo P2P para solicitudes de inferencia

  • Rápida implementación de modelos de IA

  • Infraestructura de inferencia escalable

  1. Desplegar Modelo: Sube tu modelo de IA entrenado a la plataforma GPUX.

  2. Configurar Inferencia: Establece los parámetros para ejecutar inferencias en tu modelo.

  3. Ejecutar Inferencia: Realiza tareas de inferencia bajo demanda, aprovechando las GPUs sin servidor.

  4. Optimizar Rendimiento: Utiliza las características para mejorar la velocidad y eficiencia del modelo.

  5. Monetizar Modelo (Opcional): Ofrece servicios de inferencia para tu modelo privado a otros usuarios.

  • Despliegue de Modelos de IA
  • Inferencia sin Servidor
  • Generación de Imágenes
  • Voz a Texto
  • Monetización de Modelos
  • Optimización del Rendimiento de IA
  • Acceso a Computación GPU

Reseñas de GPUX

Cargando...

Herramientas de IA populares como GPUX

EmpirioLabs AI

Apps de IA

Un proveedor especializado en inferencia e integración de IA que alberga modelos abiertos, propietarios y personalizados detrás de una única API compatible con OpenAI, con precios…

Plataformas de aprendizaje automático
Ver herramienta

Apps de IA

Un proveedor especializado en inferencia e integración de IA que alberga modelos abiertos, propietarios y personalizados detrás de una única API compatible con OpenAI, con precios…

Plataformas de aprendizaje automático
Ver el Top 250 de Apps de IA

RunInfra

Apps de IA

RunInfra es una puerta de enlace API alojada para modelos de IA de código abierto, que proporciona a los desarrolladores una clave API compatible con los SDK de OpenAI y…

MLOps y despliegue de modelos

N.º 93 en MLOps y despliegue de modelos

Ver herramienta

Apps de IA

Puerta de enlace API alojada para modelos de IA de código abierto, que proporciona a los desarrolladores una clave API compatible con los SDK de OpenAI y…RunInfra es una puerta de enlace API alojada para modelos de IA de código abierto, que proporciona a los desarrolladores una clave API compatible con los SDK de OpenAI y…

MLOps y despliegue de modelos
N.º 93 en MLOps y despliegue de modelos

ZETIC Melange

Apps de IA

ZETIC Melange automatiza el despliegue de IA en dispositivo para cualquier modelo en cualquier dispositivo. Creado por ex-ingenieros de Qualcomm, optimiza la aceleración NPU,…

MLOps y despliegue de modelos

N.º 137 en MLOps y despliegue de modelos

Ver herramienta

Apps de IA

Automatiza el despliegue de IA en dispositivo para cualquier modelo en cualquier dispositivo. Creado por ex-ingenieros de Qualcomm, optimiza la aceleración NPU,…ZETIC Melange automatiza el despliegue de IA en dispositivo para cualquier modelo en cualquier dispositivo. Creado por ex-ingenieros de Qualcomm, optimiza la aceleración NPU,…

MLOps y despliegue de modelos
N.º 137 en MLOps y despliegue de modelos

Runware

Apps de IA

Runware es una plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…

MLOps y despliegue de modelos
Ver herramienta

Apps de IA

Plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…Runware es una plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…

MLOps y despliegue de modelos
Ver el Top 250 de Apps de IA

SiliconFlow

Plataformas de IA

Una plataforma de infraestructura de IA para que los desarrolladores implementen, ajusten y ejecuten más de 200 LLMs y modelos multimodales optimizados a través de una API…

MLOps y despliegue de modelos
Ver herramienta

Plataformas de IA

Una plataforma de infraestructura de IA para que los desarrolladores implementen, ajusten y ejecuten más de 200 LLMs y modelos multimodales optimizados a través de una API…

DestacadaMLOps y despliegue de modelos
Ver el Top 150 de Plataformas de IA

Un proveedor de inferencia de IA de alta velocidad que sirve modelos en infraestructura ASIC diseñada específicamente a través de una API compatible con OpenAI, ofreciendo un bajo…

MLOps y despliegue de modelos
Ver herramienta

Un proveedor de inferencia de IA de alta velocidad que sirve modelos en infraestructura ASIC diseñada específicamente a través de una API compatible con OpenAI, ofreciendo un bajo…

MLOps y despliegue de modelos
Ver el Top 250 de Apps de IA

Cerebrium

Plataformas de IA

Cerebrium ofrece infraestructura GPU serverless para IA en tiempo real, permitiendo arranques en frío en menos de un segundo para agentes de voz, modelos de video y LLMs.…

MLOps y despliegue de modelos
Ver herramienta

Plataformas de IA

Ofrece infraestructura GPU serverless para IA en tiempo real, permitiendo arranques en frío en menos de un segundo para agentes de voz, modelos de video y LLMs.…Cerebrium ofrece infraestructura GPU serverless para IA en tiempo real, permitiendo arranques en frío en menos de un segundo para agentes de voz, modelos de video y LLMs.…

DestacadaMLOps y despliegue de modelos
Ver el Top 150 de Plataformas de IA
1 de 8