Descripción
Flide es una infraestructura de inferencia avanzada específicamente diseñada para acelerar modelos de decisión estilo Jev. Su innovación central radica en su capacidad para realizar bifurcaciones de estado exactas, permitiendo que un único estado de entrada sea procesado para múltiples preguntas en una sola pasada hacia adelante. Esto significa que el estado se lee una sola vez y luego se bifurca de manera eficiente, asegurando que cada pregunta reciba la respuesta precisa que obtendría si se le preguntara de forma aislada.
Leer más
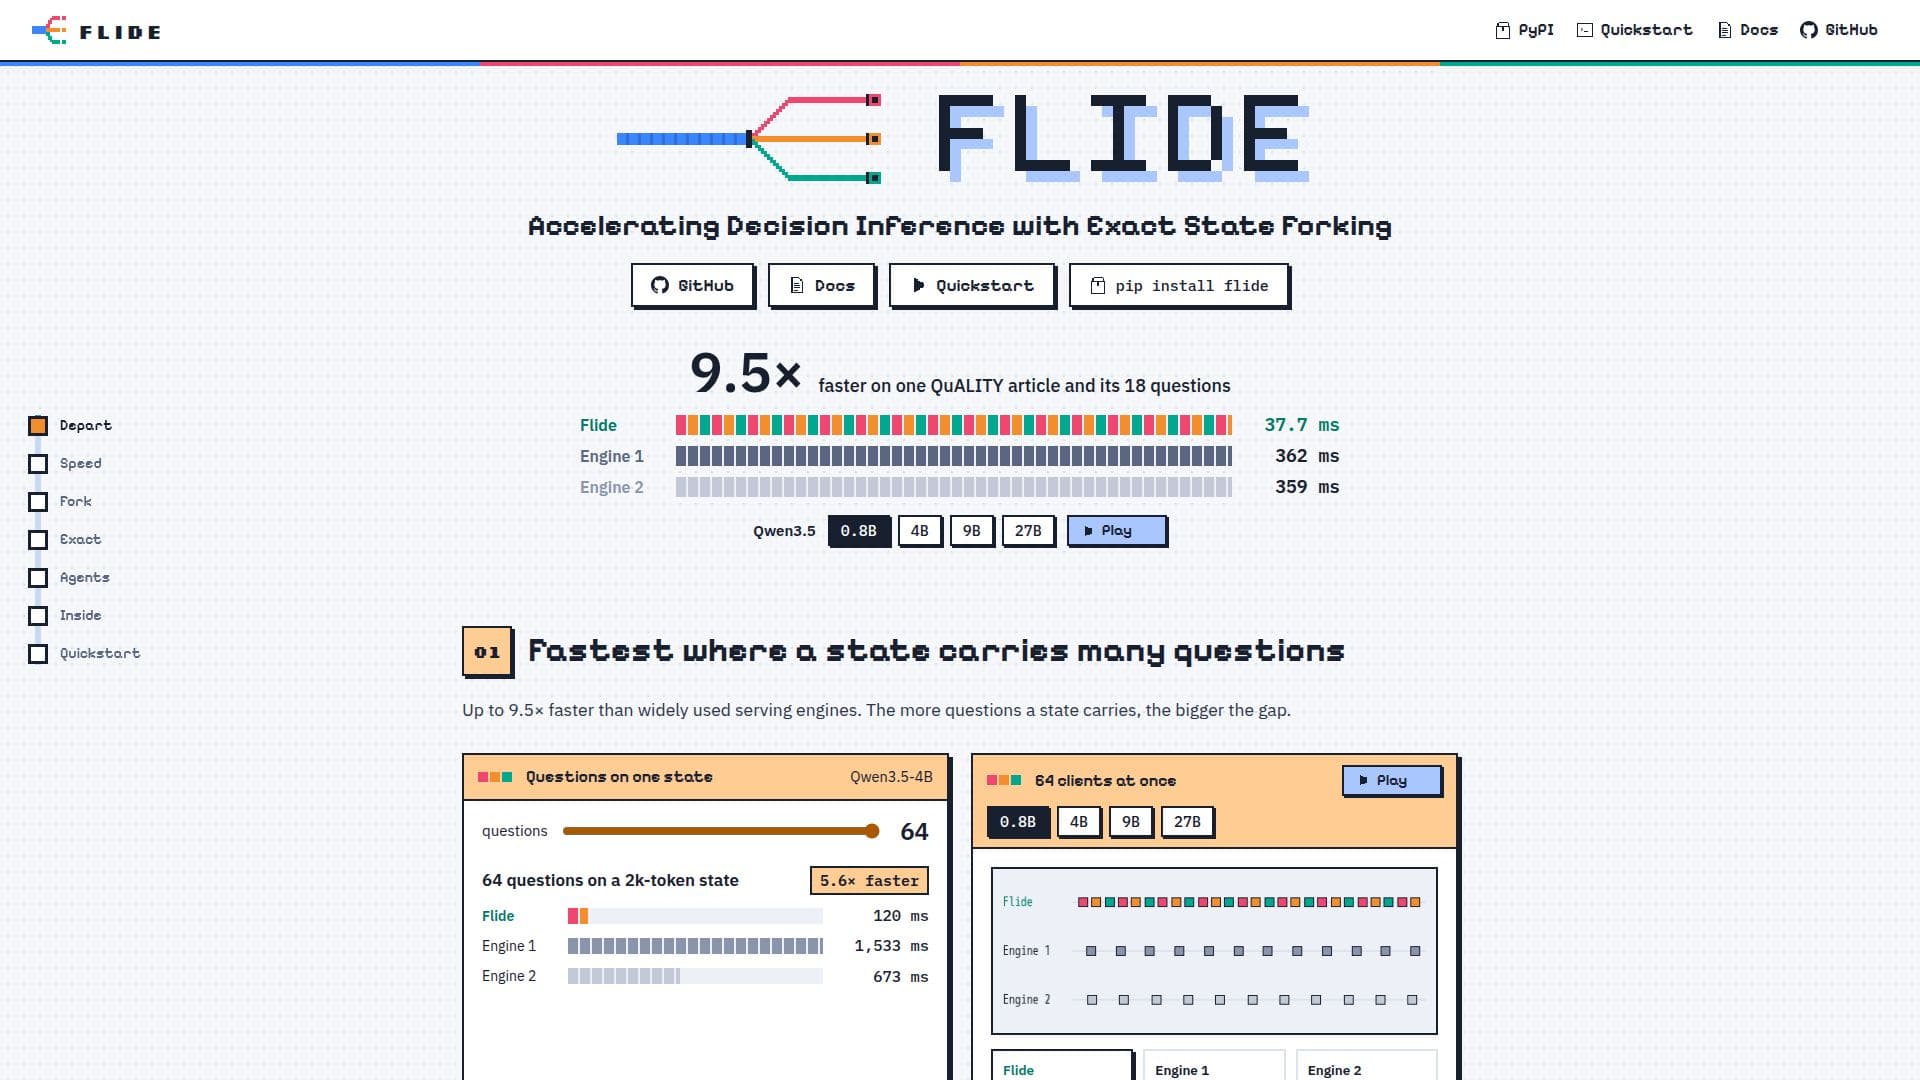
Esta arquitectura única proporciona ganancias de rendimiento sustanciales, con Flide demostrando hasta 9.5 veces más rápida la inferencia en comparación con motores de servicio ampliamente utilizados como vLLM y SGLang. La ventaja de rendimiento se vuelve aún más pronunciada a medida que aumenta el número de preguntas asociadas con un estado dado. Por ejemplo, con 64 preguntas en un estado de 2k tokens, Flide logra una aceleración de 9.5x y un rendimiento 2.2x mayor con 64 clientes.
Más allá de la velocidad, Flide prioriza la precisión, manteniéndose dentro de 1.1 puntos de una referencia float32, lo que lo convierte en uno de los motores más cercanos a una referencia de verdad fundamental. Soporta una variedad de modelos, incluyendo modelos de chat basados en Qwen3.5 y Gemma 4, así como modelos OneJev. Flide también maneja modelos híbridos, donde las capas Gated DeltaNet aseguran que cada pregunta comience desde el estado exacto del contexto compartido. El sistema ofrece una opción `--batch-invariant`, garantizando que una solicitud produzca los mismos bits independientemente de cómo se agrupe.
La instalación es sencilla a través de pip, y soporta el servicio con núcleos preconstruidos para varias GPU de NVIDIA, incluyendo A40, A10, RTX 30, H100 y H200. Flide expone la misma API `/v1/systemone` que vLLM y SGLang, proporcionando probabilidades para cada opción en la respuesta. Soporta entradas multimodales, incluyendo texto, imágenes y video, dependiendo del modelo base. Características como la cuantización FP8 para Qwen3.5 en GPUs Ada, Hopper y Blackwell, y una caché de sesión para reanudar estados de agentes, mejoran aún más sus capacidades.
- CategoríaMLOps y despliegue de modelos
- ImplementaciónAutoalojado
- PlataformasWeb
Características principales de Flide
Bifurcación de Estado Exacta: Procesa un estado para todas las preguntas en una única pasada hacia adelante.
Inferencia Acelerada: Hasta 9.5x más rápido que otros motores de servicio.
Alto Rendimiento: Logra 2.2x de rendimiento con 64 clientes en benchmarks específicos.
Proximidad a Referencia Float32: Se mantiene dentro de 1.1 puntos de una referencia float32 para precisión.
Invariancia de Lote: Asegura resultados consistentes independientemente de la agrupación con `--batch-invariant`.
Mecanismo ForkAttention: Cada pregunta lee su estado en su lugar, como si se preguntara sola.
Exacto en Modelos Híbridos: Soporta capas Gated DeltaNet para un manejo preciso del contexto.
Procesamiento de Flujo Plano Único: Ejecuta solicitudes como un único flujo de tokens reproducido por gráficos CUDA.
API Compatible con vLLM/SGLang: Utiliza el estándar de API `/v1/systemone`.
Núcleos Preconstruidos: Optimizados para GPUs NVIDIA A40, A10, RTX 30, H100 y H200.
Modelos Base: Soporta Qwen3.5 (0.8B, 2B, 4B, 9B, 27B) y Gemma 4 (E2B, E4B, 12B, 26B-A4B, 31B).
Entradas Multimodales: Maneja entradas de texto, imágenes y video.
Cuantización FP8: Ejecuta Qwen3.5 en FP8 en GPUs Ada, Hopper y Blackwell.
Caché de Sesión: Mantiene estados anteriores para que los agentes reanuden (por ejemplo, `--session-cache-gb 40`).
Procesos Frontend: Soporta la ejecución de HTTP, renderizado y tokenización en procesos separados para muchos clientes.
¿Cómo usar Flide?
Instalar Flide: Usa pip para instalar el paquete Flide.
Iniciar un Servidor: Ejecuta `flide serve` para iniciar el servidor de inferencia, especificando opcionalmente `--host`.
Configurar Modelos: Sirve modelos de chat como Qwen3.5 o Gemma 4 directamente, o fusiona adaptadores Open-Jev.
Enviar Solicitudes: Interactúa con el servidor usando la API `/v1/systemone` para enviar estados y preguntas.
Procesar Entradas Multimodales: Incluye rutas de imágenes en el estado y envía medios para modelos que soportan imágenes.
Casos de uso de Flide
- Modelos de Decisión Acelerados
- Inferencia Multimodal
- Procesamiento de Lotes Consistente
- Gestión del Estado del Agente
- Servicio de LLM de Alto Rendimiento
- Investigación y Desarrollo