Descripción
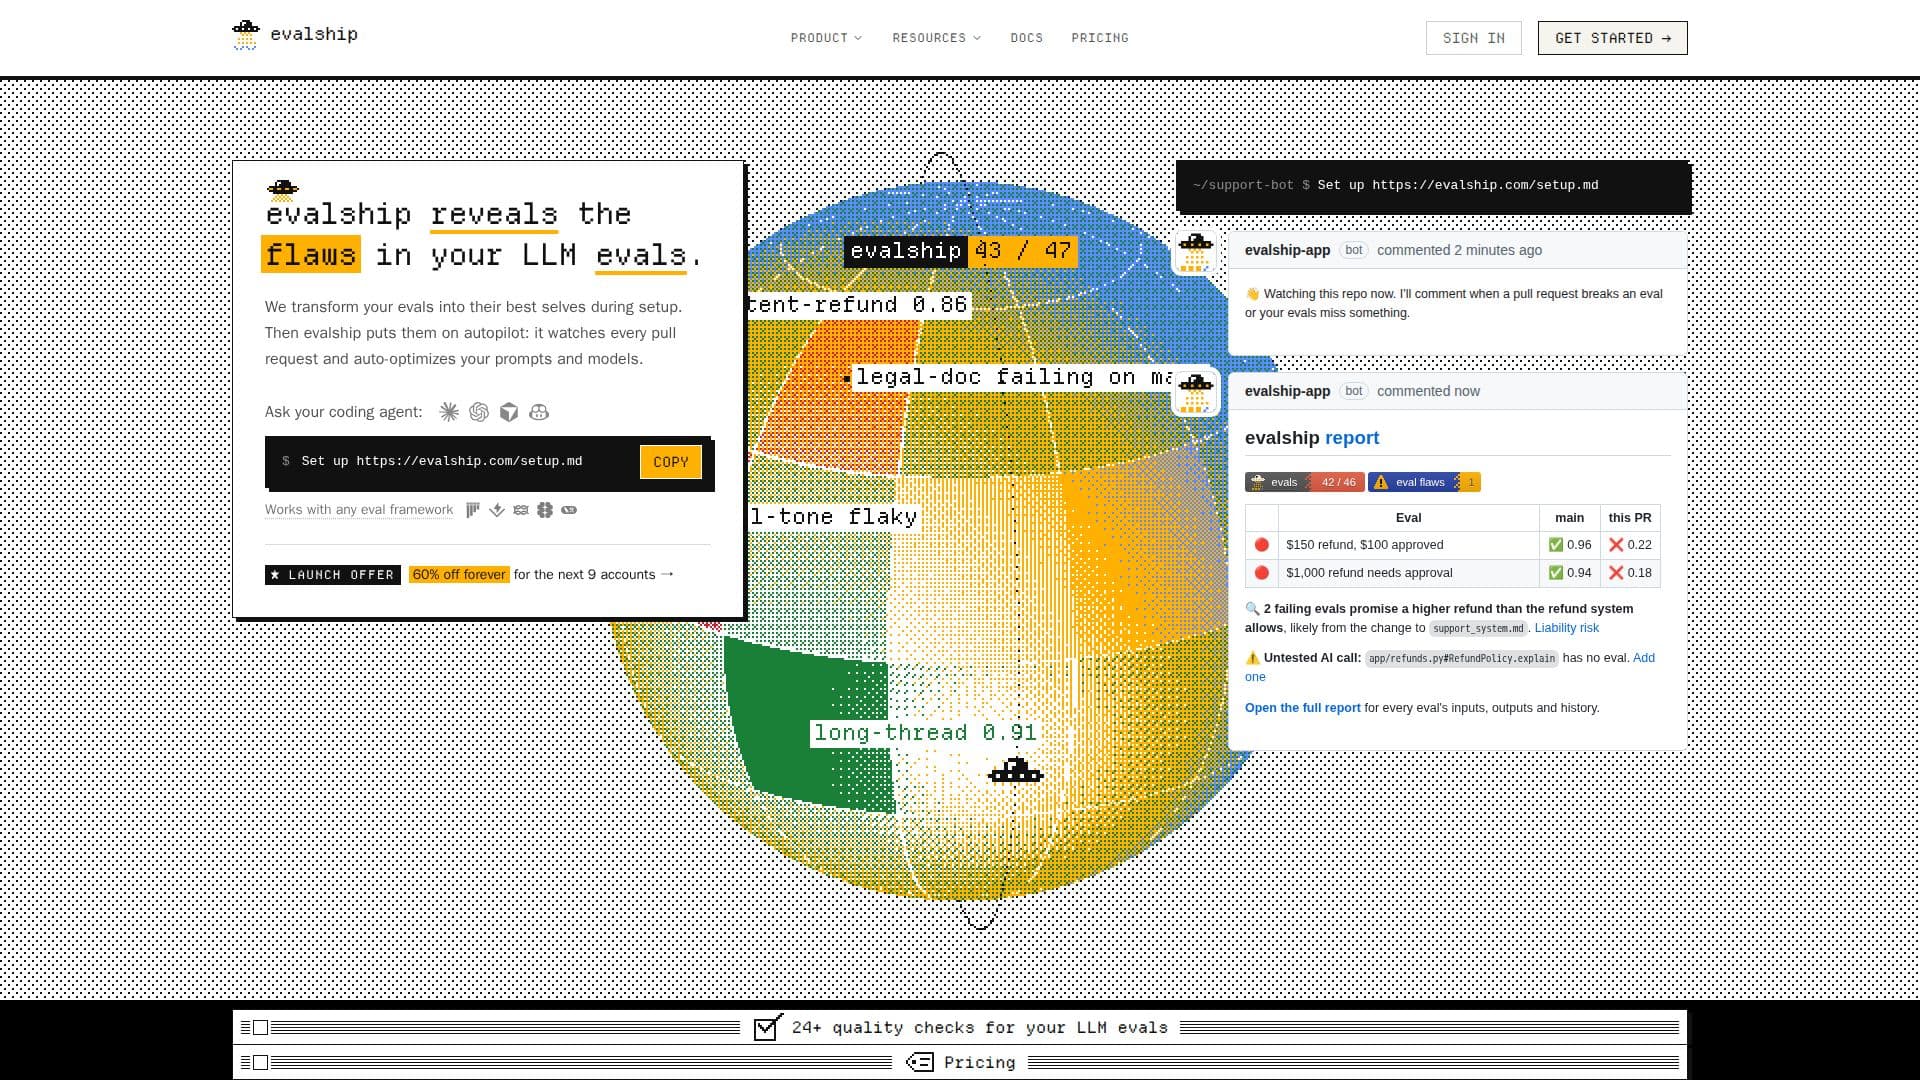
evalship ofrece una solución integral de control de calidad diseñada específicamente para evaluaciones de Modelos de Lenguaje Grande (LLM). Se integra directamente en su flujo de trabajo de GitHub, actuando como un guardián vigilante para su proceso de desarrollo de LLM. El propósito principal de evalship es identificar y abordar fallos en sus configuraciones de evaluación, asegurando que sus LLM funcionen como se espera y no introduzcan regresiones.
Leer más
Al configurarse, evalship revisa minuciosamente sus evaluadores, jueces y prompts existentes para identificar debilidades como evaluaciones que pasan incorrectamente o reglas que carecen de una cobertura de prueba adecuada. Luego, monitorea cada solicitud de extracción, proporcionando retroalimentación inmediata sobre lo que falló, por qué falló y la causa probable. Esto incluye señalar llamadas de IA no probadas y separar regresiones genuinas de resultados de evaluación inestables analizando el rendimiento histórico en su rama predeterminada.
La plataforma funciona sin problemas con varios marcos de evaluación, incluidos aquellos que producen JUnit XML, promptfoo JSON o evalship JSON, como pytest, Vitest, Jest, RSpec, Go, Java, PHPUnit, Rust, Langfuse, Braintrust y LangSmith. No ejecuta sus evaluaciones directamente; en su lugar, su flujo de trabajo de GitHub Actions o agente de codificación las ejecuta utilizando sus claves API, y evalship procesa los resultados.
Más allá de identificar problemas, evalship ayuda a optimizar sus prompts y modelos. A través de su agente de codificación, prueba diferentes cambios en su máquina, como modelos más económicos o reglas más claras, y reporta qué cambios generan mejoras estadísticamente significativas. Esto permite a los equipos tomar decisiones basadas en datos para mejorar el rendimiento del modelo y la eficiencia de costos. evalship también proporciona informes semanales que resumen el rendimiento de la evaluación y destacan problemas críticos detectados antes de que lleguen a producción.
Los precios incluyen un nivel gratuito para repositorios públicos y un repositorio privado con un usuario, ofreciendo 100 análisis de PR y 30 días de historial de evaluaciones. Los planes de pago (Equipo, Pro, Negocios) ofrecen más usuarios, repositorios privados, análisis de PR y un historial de evaluación más largo, con opciones de facturación mensual o anual. Una oferta de lanzamiento proporciona descuentos significativos para los primeros adoptantes. evalship garantiza la seguridad al no almacenar su código fuente ni sus claves API, solo procesando diferencias y resultados de evaluación.
- CategoríaRevisión de código y pruebas con IA
- Modelo de preciosFreemium
- ImplementaciónNube
- PlataformasWeb
Características principales de evalship
Identifica fallos en las evaluaciones de LLM durante la configuración
Comenta en cada solicitud de extracción con un desglose detallado de los fallos de evaluación
Optimiza automáticamente prompts y modelos basándose en datos de rendimiento
Funciona con cualquier marco de evaluación existente (JUnit XML, promptfoo, evalship JSON)
Proporciona más de 24 controles de calidad para evaluaciones de LLM
Separa regresiones de evaluaciones inestables utilizando datos históricos
Detecta llamadas de IA no probadas en solicitudes de extracción
Bloquea fusiones que rompen las reglas de evaluación (configurable)
Desbloquea solicitudes de extracción una vez que se solucionan los problemas
Envía informes semanales de evaluación que resumen el rendimiento y los problemas
Soporta monorepos y múltiples flujos de trabajo de evaluación
Se integra con Langfuse, Braintrust y LangSmith sin requerir un cambio
Ofrece una revisión gratuita de evaluaciones al configurarse
Permite a los agentes de codificación verificar cambios antes de abrir solicitudes de extracción
Garantiza la seguridad al no almacenar código fuente ni claves API
¿Cómo usar evalship?
Configuración: Conecte su repositorio de GitHub y pida a su agente de codificación que configure evalship, que revisa sus evaluaciones y crea una solicitud de extracción de configuración.
Monitorear solicitudes de extracción: evalship observa automáticamente cada solicitud de extracción, comentando sobre cambios que rompen evaluaciones o introducen llamadas de IA no probadas.
Revisar informes: Acceda a informes detallados para cada evaluación sobre entradas, salidas e historial para entender qué falló y por qué.
Optimizar: Utilice la función de optimización de evalship para probar cambios en prompts y modelos con su agente de codificación, identificando mejoras más allá del azar.
Recibir informes: Obtenga informes semanales por correo electrónico que resumen el rendimiento de la evaluación y destacan problemas críticos detectados antes de la fusión.
Casos de uso de evalship
- Control de Calidad de Evaluaciones de LLM
- Revisión Automatizada de Solicitudes de Extracción
- Optimización de Prompts y Modelos
- Prevención de Regresiones
- Detección de Llamadas de IA No Probadas
- Gestión de Evaluaciones Inestables
- Mitigación de Riesgos de Cumplimiento y Responsabilidad
- Mejora del Flujo de Trabajo del Desarrollador