Descripción
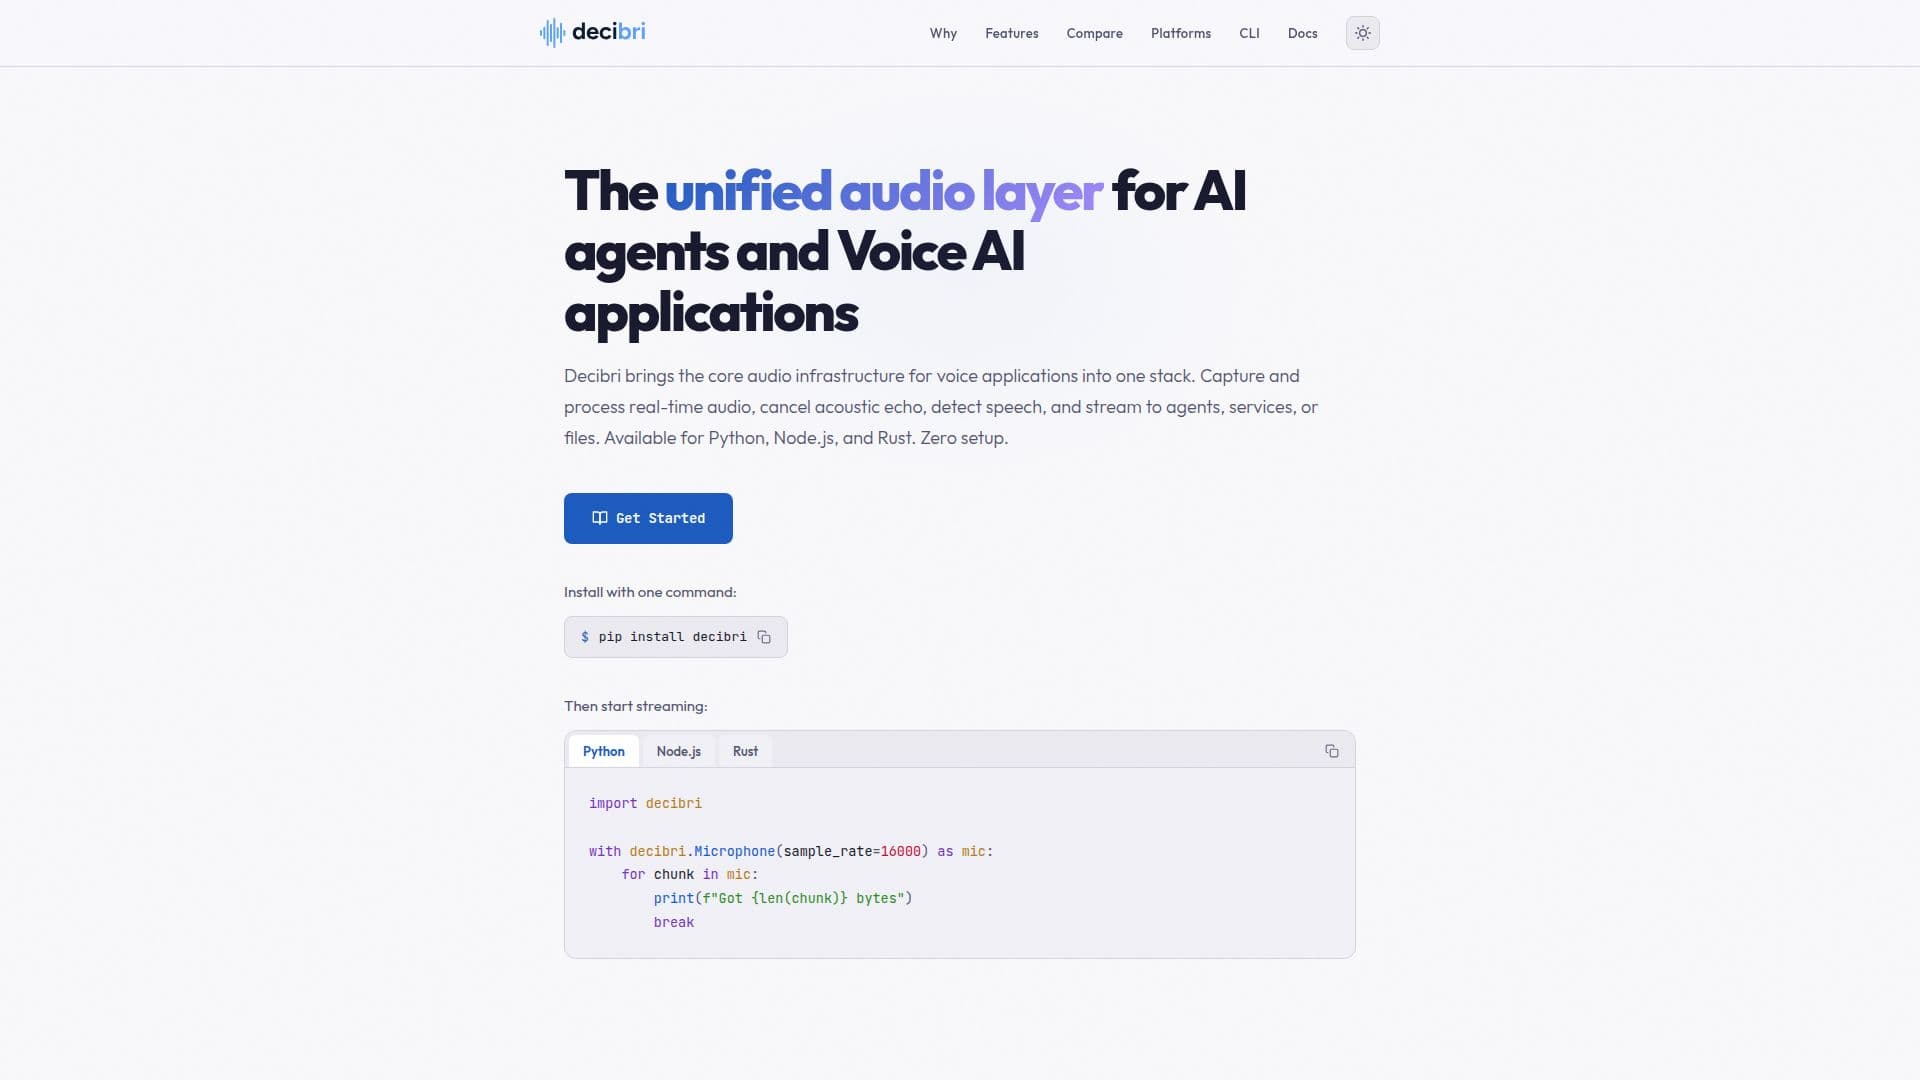
Decibri sirve como una capa de audio unificada diseñada específicamente para agentes de IA y aplicaciones de IA de voz. Proporciona capacidades de audio en tiempo real esenciales, incluyendo captura de micrófono, salida de altavoz y detección de actividad de voz (VAD). La plataforma soporta múltiples lenguajes de programación, a saber, Python, Node.js y Rust, lo que la hace versátil para varios entornos de desarrollo.
Leer más
Una de las principales ventajas de Decibri es su facilidad de instalación y compatibilidad multiplataforma. Ofrece binarios preconstruidos para Python y Node.js en todas las plataformas soportadas (Windows, macOS, Linux), eliminando la necesidad de compilación o herramientas de construcción complejas. Este enfoque de "cero configuración" asegura que los desarrolladores puedan integrar rápidamente funcionalidades de audio en tiempo real en sus proyectos. El núcleo en Rust, que impulsa los paquetes de Python, Node.js y Rust, se compila en código nativo, asegurando un audio de baja latencia predecible directamente desde la capa de audio del sistema operativo.
Decibri captura audio directamente de la capa de audio del sistema operativo, proporcionando fragmentos de audio de 100 ms por defecto en formato PCM de enteros con signo de 16 bits, que es el estándar esperado por la mayoría de los motores de voz y de palabras de activación como Vosk, sherpa-onnx y whisper.cpp. También está disponible un formato de punto flotante de 32 bits. Soporta modismos nativos de flujo para cada lenguaje, permitiendo a los desarrolladores enviar audio a archivos, WebSockets o agentes de voz de manera eficiente. La plataforma también incluye un modelo Silero VAD v6.2 empaquetado para una detección precisa de voz en entornos ruidosos, funcionando localmente a través de ONNX Runtime sin requerir APIs en la nube.
Más allá de la captura y reproducción básicas, Decibri ofrece características avanzadas de procesamiento de audio a través de su Motor de Captura de Audio (ACE), incluyendo eliminación de DC, reducción de ruido, filtrado de paso alto, control automático de ganancia y limitación. También proporciona Cancelación de Eco Acústico (AEC) para eliminar el sonido del altavoz de la captura del micrófono. Para el procesamiento fuera de línea, el Procesador de Archivos de Audio (AFP) permite acondicionar muestras grabadas o en memoria. Decibri se integra con numerosos proveedores de conversión de voz a texto (STT), tanto en la nube (AssemblyAI, AWS Transcribe, Azure AI Speech, Deepgram, Google Cloud Speech-to-Text, Mistral Voxtral, OpenAI Realtime API) como locales (Sherpa-ONNX, Whisper.cpp), así como texto a voz (TTS) local con el modelo Kokoro y detección de palabras clave (KWS) con Sherpa-ONNX.
Decibri está construido para sistemas en tiempo real, asegurando I/O de audio de baja latencia sin herramientas de audio externas o manejo específico de la plataforma. Soporta operaciones asíncronas en Python con `asyncio` y funciona tanto en entornos de Node.js como en navegadores desde un solo paquete. La herramienta `decibri-cli` proporciona capacidades de línea de comandos para captura de audio, reproducción y enumeración de dispositivos, ampliando aún más su utilidad para scripting y pipelines de CI/CD.
- CategoríaCreadores de agentes de IA
- Modelo de preciosGratis
- ImplementaciónLocal
- PlataformasWindows, macOS, Linux, Browser
Características principales de Decibri
Captura de Micrófono en Tiempo Real
Salida y Reproducción de Altavoz
Detección de Actividad de Voz (VAD)
Soporte Multiplataforma (Python, Node.js, Rust)
Binarios Preconstruidos para Cero Configuración
Acceso Directo a la Capa de Audio del SO
Salida de Audio en PCM de 16 bits y Flotante de 32 bits
Soporte de API Asíncrona (asyncio para Python)
Compatibilidad con Navegadores (paquete de Node.js)
Motor de Captura de Audio (eliminación de DC, reducción de ruido, AGC)
Cancelación de Eco Acústico (AEC)
Detección de Voz ML Local (Silero VAD)
Integración con Servicios STT en la Nube
Integración con Modelos Locales STT/TTS/KWS
Interfaz de Línea de Comandos (decibri-cli)
¿Cómo usar Decibri?
Instalar Decibri: Usa `pip install decibri` para Python o `npm install decibri` para Node.js para obtener los binarios preconstruidos.
Abrir Micrófono: Utiliza `decibri.Microphone.open()` en Python o `new Microphone()` en Node.js para comenzar a capturar audio.
Transmitir Audio: Lee fragmentos de audio usando iteradores de Python, flujos legibles de Node.js o canales de Rust.
Procesar Audio: Aplica acondicionamiento incorporado como eliminación de DC, reducción de ruido o cancelación de eco acústico.
Detectar Voz: Habilita el modelo Silero VAD empaquetado para detección de actividad de voz local.
Integrar con Servicios de IA: Envía audio PCM sin procesar a servicios de conversión de voz a texto, agentes de voz u otros modelos de IA.
Reproducir Audio: Usa la API de Altavoz de Decibri para reproducir audio a través del altavoz del sistema.
Grabar en Archivo: Emplea `record_to_file()` para grabaciones de audio simples o control completo de streaming para casos de uso avanzados.
Casos de uso de Decibri
- Agentes de IA de Voz en Tiempo Real
- Integración de Conversión de Voz a Texto
- Detección de Actividad de Voz
- Grabación de Audio para ASR
- Aplicaciones de Audio Multiplataforma
- Backends de Voz del Lado del Servidor
- Detección de Palabras Clave
- Comunicación de Audio Dúplex Completo