Beschreibung
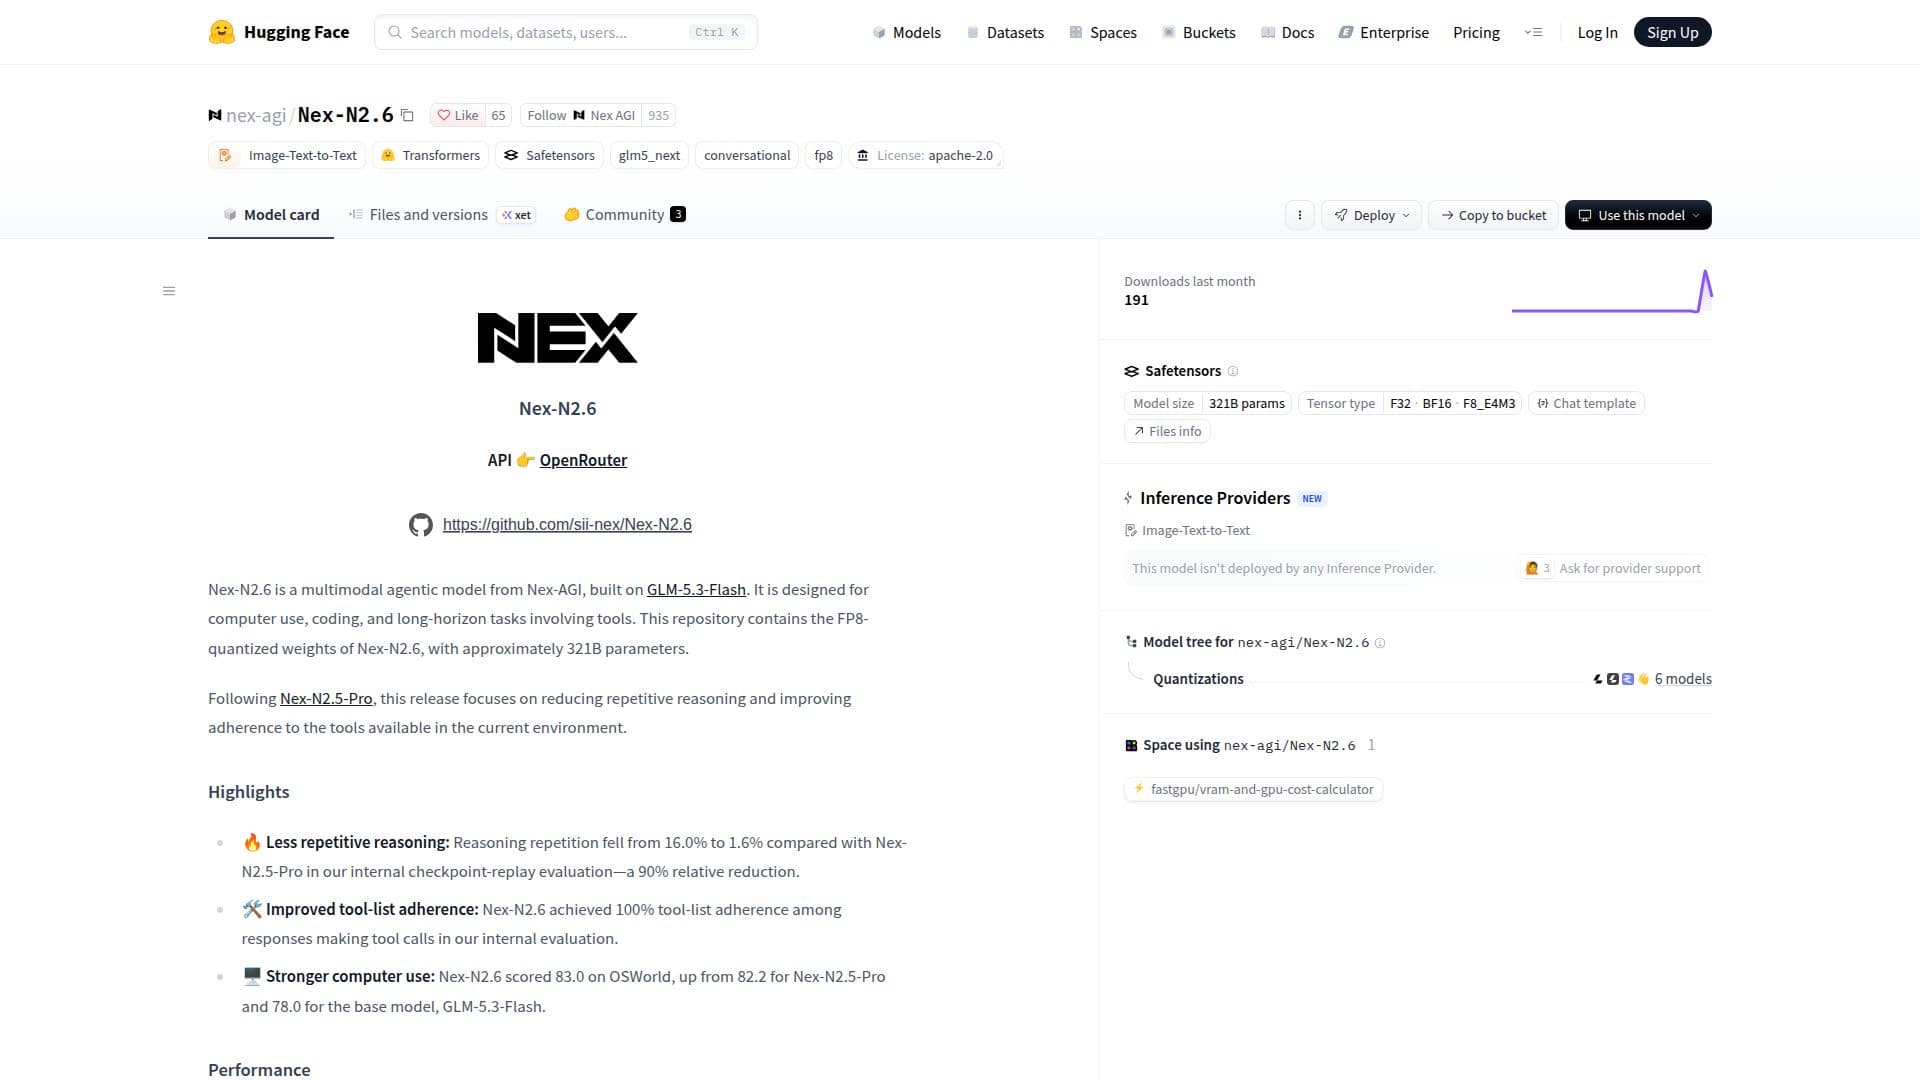
Nex-N2.6 ist ein fortschrittliches multimodales agentisches Modell, das von Nex-AGI entwickelt wurde und auf der grundlegenden Architektur GLM-5.3-Flash basiert. Dieses Modell ist speziell darauf ausgelegt, in anspruchsvollen rechnerischen Umgebungen, einschließlich komplexer Programmieraufgaben und langfristiger Operationen, die eine anspruchsvolle Integration und Nutzung von Werkzeugen erfordern, hervorragende Leistungen zu erbringen. Die aktuelle Version konzentriert sich darauf, die Leistung zu verbessern, indem sie zentrale Bereiche wie die Effizienz des Denkens und die Einhaltung von Werkzeugen anspricht.
Weiterlesen
Ein bedeutendes Highlight von Nex-N2.6 ist die bemerkenswerte Reduzierung repetitiven Denkens. Interne Bewertungen zeigen einen dramatischen Rückgang der Wiederholung im Denken, von 16,0 % in seinem Vorgänger, Nex-N2.5-Pro, auf nur 1,6 %. Dies stellt eine relative Reduzierung von 90 % dar und zeigt eine erhebliche Verbesserung der Fähigkeit des Modells, Informationen effizienter zu verarbeiten und redundante Denkprozesse zu vermeiden. Darüber hinaus zeigt das Modell eine perfekte Einhaltung der Werkzeugliste und erreicht 100 % in internen Bewertungen für Antworten, die Werkzeugaufrufe beinhalten. Dies stellt sicher, dass Nex-N2.6 konsequent nur die in einer Anfrage deklarierten Werkzeuge nutzt, was zu zuverlässigeren und vorhersehbaren Ergebnissen führt.
In Bezug auf die praktische Anwendung zeigt Nex-N2.6 stärkere Fähigkeiten in der Computerbenutzung. Es erzielte 83,0 im OSWorld-Benchmark und übertraf damit Nex-N2.5-Pro (82,2) und das Basis-Modell GLM-5.3-Flash (78,0). Ähnliche Leistungsgewinne sind auch in anderen Benchmarks zu beobachten, wie z.B. Terminal-Bench 2.1, wo Nex-N2.6 84,1 erzielte, und AutomationBench, wo es 45,7 erreichte. Diese Ergebnisse, die vom Nex-AGI-Team berichtet wurden, unterstreichen die robuste Leistung des Modells bei verschiedenen rechnerischen Aufgaben.
Für den Einsatz bietet Nex-N2.6 FP8-quantisierte Gewichte, die es für Inferenzlaufzeiten geeignet machen, die GLM-5.3-Flash unterstützen. Benutzer können das Modell selbst hosten, indem sie dem offiziellen SGLang-Bereitstellungsleitfaden folgen und eine FP8-kompatible Konfiguration sicherstellen. Die gebündelte Chat-Vorlage unterstützt unterschiedliche Denkaufwandsstufen (niedrig, hoch, maximal) und ermöglicht Bildeingaben über unterstützte Bereitstellungs-Laufzeiten. Für werkzeugbasierte Operationen müssen die Benutzer die verfügbaren Werkzeuge mit jeder Anfrage bereitstellen, wobei der Client oder das Agenten-Framework für die Ausführung der Werkzeugaufrufe und die Rückgabe der Ergebnisse verantwortlich ist. Die Nex-Community bietet eine Plattform für Feedback, Diskussionen über Arbeitsabläufe und Entwicklerverbindungen.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungSelbst gehostet
- PlattformenWeb
Nex-N2.6 im Überblick
Multimodales agentisches Modell
Basierend auf der GLM-5.3-Flash-Architektur
Für Computerbenutzung und Programmierung konzipiert
Optimiert für langfristige Aufgaben mit Werkzeugen
FP8-quantisierte Gewichte verfügbar
321 Milliarden Parameter
90 % relative Reduzierung der Wiederholung im Denken
100 % Einhaltung der Werkzeugliste bei Werkzeugaufrufen
Starke Leistung im OSWorld-Benchmark (83,0 Punkte)
Hohe Punktzahlen bei Terminal-Bench 2.1 (84,1) und AutomationBench (45,7)
Unterstützt Werte für Denkaufwand: niedrig, hoch, maximal
Kompatibel mit Bildinhaltsblöcken für Bildeingaben
OpenRouter API-Integration
Community-Support für Feedback und Arbeitsabläufe
Erste Schritte mit Nex-N2.6
Zugriff auf die Modellseite: Navigieren Sie zur Nex-N2.6-Modellseite auf Hugging Face.
Gewichte herunterladen: Laden Sie die FP8-quantisierten Gewichte von Nex-N2.6 herunter.
Laufzeit konfigurieren: Verwenden Sie eine Inferenzlaufzeit mit GLM-5.3-Flash-Unterstützung oder hosten Sie selbst mit SGLang und einer FP8-kompatiblen Konfiguration.
Modellpfad festlegen: Ersetzen Sie den Modellpfad durch das heruntergeladene Nex-N2.6-Verzeichnis und setzen Sie `--served-model-name Nex-N2.6`.
Tokenizer/Prozessor sicherstellen: Behalten Sie den mit den Gewichten gelieferten Tokenizer, Prozessor und die Chat-Vorlage bei.
Eingabeaufforderungen senden: Sobald der OpenAI-kompatible Server lauscht, senden Sie Eingabeaufforderungen und geben Sie `reasoning_effort` (niedrig, hoch, maximal) nach Bedarf an.
Werkzeuge bereitstellen: Für die Nutzung von Werkzeugen stellen Sie die verfügbaren Werkzeuge mit jeder Anfrage bereit; das Client- oder Agenten-Framework führt die Aufrufe aus und gibt die Ergebnisse zurück.
Bild-Eingaben nutzen: Für Bild-Eingaben verwenden Sie Bildinhaltsblöcke, die von Ihrer Bereitstellungs-Laufzeit unterstützt werden.
Nex-N2.6's Anwendungsfälle
- Komplexe Programmieraufgaben
- Langfristige Automatisierung
- Interaktion mit Computersystemen
- Multimodale Datenverarbeitung
- Entwicklung agentischer Arbeitsabläufe
- Leistungsbenchmarking
- Reduzierung repetitiven Denkens