Beschreibung
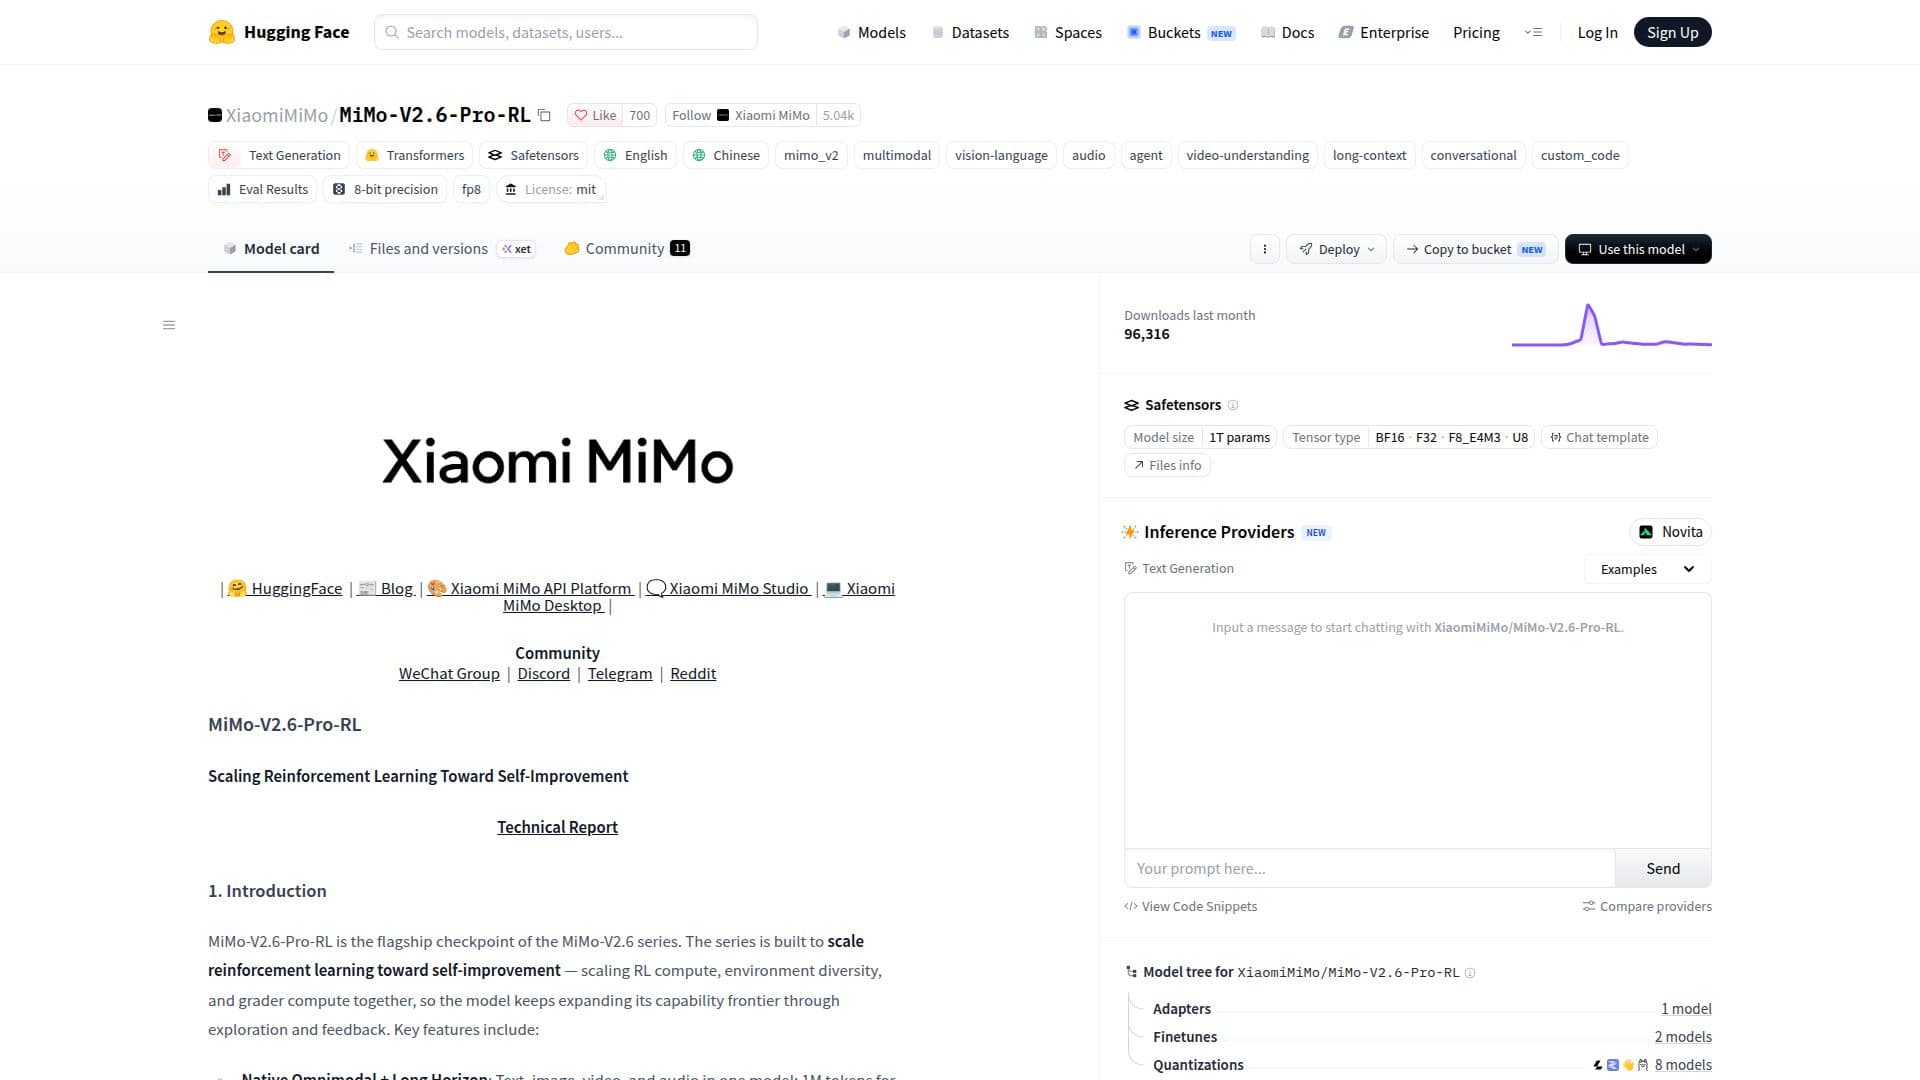
MiMo-V2.6-Pro-RL ist das führende Modell der MiMo-Serie, das entwickelt wurde, um das Verstärkungslernen in Richtung Selbstverbesserung voranzutreiben. Dieses Modell ist darauf ausgelegt, die Berechnungen für RL, die Vielfalt der Umgebungen und die Berechnungen für die Bewertung zusammen zu skalieren, wodurch es seine Fähigkeiten durch Erkundung und Feedback erweitern kann.
Weiterlesen
Zu den Hauptmerkmalen gehören ein nativer omnimodaler Ansatz, der Text, Bild, Video und Audio in einem Modell integriert, sowie eine lange Kontextlänge von 1 Million Tokens, um umfangreiche Repositories und Multi-Session-Agentenläufe zu bewältigen.
Das Modell verwendet eine einzigartige Strategie namens 'You Only RL Once', die Aufgaben mischt und in einem einzigen Batch nutzt, um Fähigkeiten zu verstärken und Strategien über verschiedene Bereiche hinweg zu übertragen. Es nutzt vollständig asynchrone Group Relative Policy Optimization (GRPO) auf großen Batches und verarbeitet Milliarden von Tokens pro Aktualisierung. Das Groupwise Agentic Grading-System verbessert die Selbstverbesserungsschleife, indem es Lösungen bewertet und auf effiziente Wege lenkt.
MiMo-V2.6-Pro-RL bietet auch Multi-Prefix Multi-Teacher On-Policy Distillation (MOPD2), das autonome Schüler-Rollouts mit prefix-konditionierten Rollouts kombiniert und die Fähigkeiten für komplexe Aufgaben erweitert. Die Architektur des Modells umfasst eine Sparse Mixture of Experts mit insgesamt 1,02 Billionen Parametern und einen Vision Encoder mit 681 Millionen Parametern.
Dieses Modell ist über verschiedene Plattformen verfügbar, darunter AI Studio, MiMo Code und Xiaomi MiMo Desktop. Es unterstützt die Docker-Bereitstellung für optimale Leistung und ist über die Xiaomi MiMo Open Platform API und OpenRouter zugänglich.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
MiMo-V2.6-Pro-RL im Überblick
Native Omnimodale Integration
1M Token Kontextlänge
You Only RL Once Strategie
Group Relative Policy Optimization
Groupwise Agentic Grading
Multi-Prefix Multi-Teacher Distillation
Sparse Mixture of Experts Architektur
Verfügbar auf mehreren Plattformen
Erste Schritte mit MiMo-V2.6-Pro-RL
Zugriff auf die Modellseite: Besuchen Sie die offizielle Hugging Face-Seite für MiMo-V2.6-Pro-RL.
Authentifizieren: Stellen Sie sicher, dass Sie die erforderlichen Anmeldeinformationen haben, um auf das Modell zuzugreifen.
Konfigurieren: Richten Sie die Modellparameter gemäß Ihren Anforderungen ein.
Eingabeaufforderungen senden: Geben Sie Ihre Daten ein, um mit dem Modell zu interagieren und Ausgaben zu erhalten.
MiMo-V2.6-Pro-RL's Anwendungsfälle
- Multimodale Verarbeitung
- Verstärkungslernen
- Umfangreiche Datenverarbeitung
- Übertragung von Strategien über Bereiche hinweg
- Fortgeschrittene Bewertungssysteme