Zum Hauptinhalt springen
ToolPotion
KI-Berater
Einreichen

Mage-VL

LLMs#20KI-Modelle & LLMsOpen Source · Web

Mage-VL ist ein codec-natives, proaktives Streaming-Multimodal-Grundmodell, das für ein effizientes Verständnis von Bildern und Videos entwickelt wurde. Es nutzt einen einzigartigen visuellen Encoder und einen kausalen Decoder, um die Echtzeitwahrnehmung beim Streaming zu verbessern und gleichzeitig die Rechenanforderungen zu reduzieren.

URL besuchen
Teilen
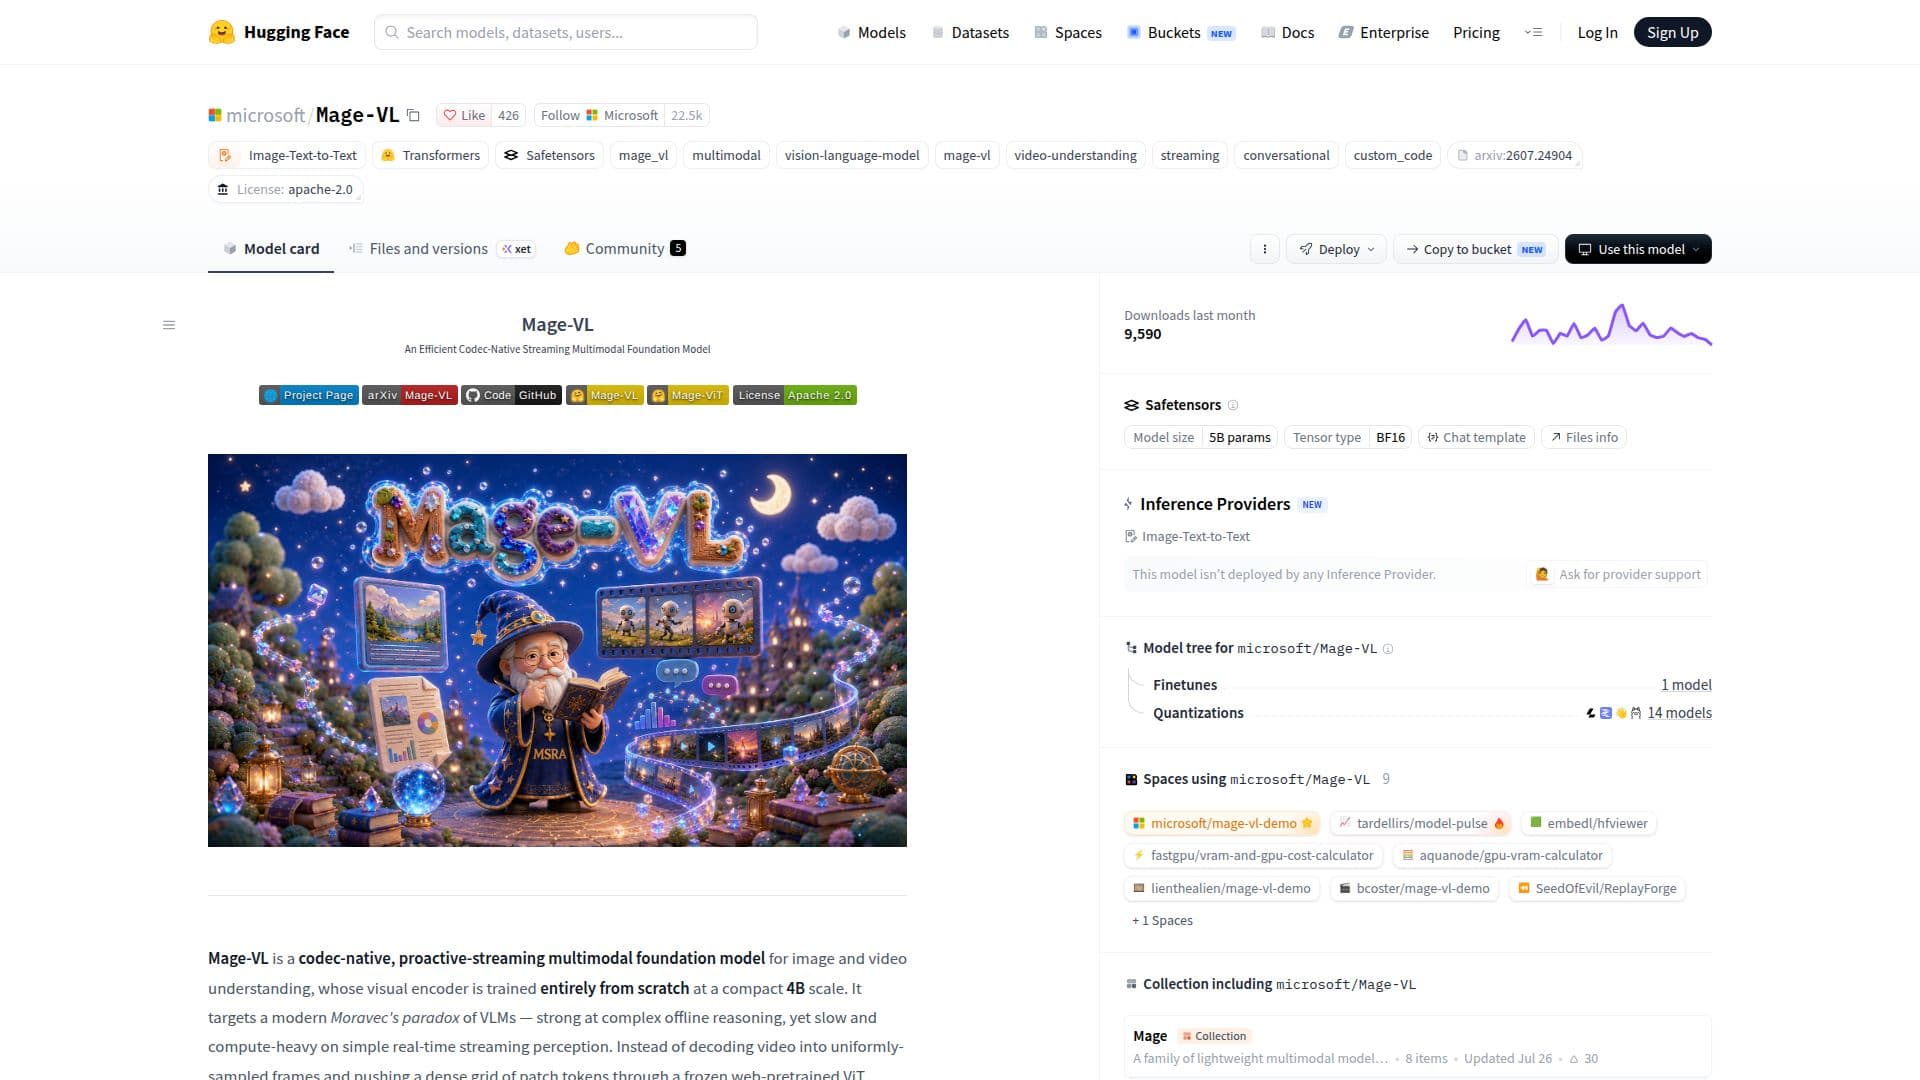
Screenshot von Mage-VL

Mage-VL ist ein innovatives multimodales Grundmodell, das entwickelt wurde, um die Herausforderungen des Verständnisses von Bildern und Videos zu bewältigen. Es ist als codec-natives, proaktives Streaming-Modell konzipiert, das visuelle Daten effizient verarbeitet. Der visuelle Encoder des Modells, Mage-ViT, wird von Grund auf neu trainiert und arbeitet auf einer kompakten 4B-Skala. Dieser Encoder ist einzigartig in seiner Fähigkeit, Tokens basierend auf codec-abgeleiteter spatio-temporaler Wichtigkeit zuzuweisen, was es ihm ermöglicht, Videos bis zu achtmal länger unter demselben Rechenbudget zu verarbeiten.

Weiterlesen

Die Architektur von Mage-VL umfasst einen Qwen3-4B kausalen Decoder, der das einzige vortrainierte Element ist. Dieser Decoder arbeitet in Kombination mit Mage-ViT, um Tokenströme variabler Länge zu verarbeiten und eine einheitliche Schnittstelle für Bilder und Videos unterschiedlicher Längen zu unterstützen. Das duale Design des Modells integriert ein Kognitionstor, das proaktives Streaming ermöglicht, indem es Inhalte überwacht und das vollständige visuelle Sprachmodell nur bei Bedarf aktiviert.

Der codec-native Ansatz des Modells reduziert den Verbrauch visueller Tokens um über 75 %, was zu einer 3,5-fachen Beschleunigung der Inferenz im Vergleich zu traditionellen Methoden führt. Diese Effizienz wird erreicht, ohne die Genauigkeit zu beeinträchtigen, was Mage-VL zu einem leistungsstarken Werkzeug für die Echtzeitanalyse und das Verständnis von Videos macht.

Mage-VL ist besonders stark im Verständnis von Videos und räumlicher Intelligenz und übertrifft vergleichbare Modelle in mehreren Benchmarks. Seine proaktiven Streaming-Fähigkeiten werden durch seine Leistung bei SoccerNet-Streaming-Aufgaben demonstriert, wo es latenzfreie, ereignisgesteuerte Kommentare liefert.

Insgesamt stellt Mage-VL einen bedeutenden Fortschritt in multimodalen KI-Modellen dar und bietet eine dateneffiziente Lösung für komplexe visuelle Aufgaben. Seine Open-Source-Natur und umfassenden Fähigkeiten machen es zu einer wertvollen Ressource für Entwickler und Forscher im Bereich der künstlichen Intelligenz.

  • KategorieKI-Modelle & LLMs
  • PreismodellOpen Source
  • BereitstellungCloud
  • PlattformenWeb

  • Codec-nativer visueller Encoder

  • Proaktives Streaming-Tor

  • Qwen3-4B kausaler Decoder

  • 3,5-fache Inferenzbeschleunigung

  • Daten-effizienter Tokenizer

  • Vortraining mit variabler Auflösung

  • Einheitliches Modell für Bilder und Videos

  • Ereignisgesteuerte Kommentare

  1. Zugriff auf die Modellseite: Besuchen Sie das Hugging Face-Repository

  2. Authentifizieren: Verwenden Sie Ihre Anmeldedaten für Hugging Face

  3. Konfigurieren: Richten Sie die Modellparameter und die Umgebung ein

  4. Eingabeaufforderungen senden: Geben Sie Ihre Bild- oder Videodaten zur Verarbeitung ein

  5. Feinabstimmung: Passen Sie die Modelleinstellungen für spezifische Aufgaben an

  • Echtzeitanalyse von Videos
  • Räumliche Intelligenz
  • Ereignisgesteuerte Kommentare
  • Bildverständnis
  • Proaktives Streaming

Beliebte KI-Tools wie Mage-VL

Qwen3.5-4B ist ein kausales Sprachmodell mit einem Vision-Encoder, das für leistungsstarkes multimodales Lernen entwickelt wurde. Es unterstützt 201 Sprachen und bietet eine…

KI-Modelle & LLMs
Tool ansehen

Kausales Sprachmodell mit einem Vision-Encoder, das für leistungsstarkes multimodales Lernen entwickelt wurde. Es unterstützt 201 Sprachen und bietet eine…Qwen3.5-4B ist ein kausales Sprachmodell mit einem Vision-Encoder, das für leistungsstarkes multimodales Lernen entwickelt wurde. Es unterstützt 201 Sprachen und bietet eine…

KI-Modelle & LLMs
Top 5 KI-Modelle ansehen

DeepSeek-V4-Flash-Vision-Exp ist ein experimentelles multimodales Modell aus der DeepSeek-V4-Familie, das die visuellen Verständnisfähigkeiten verbessert. Es basiert auf der…

KI-Modelle & LLMs
Tool ansehen

Experimentelles multimodales Modell aus der DeepSeek-V4-Familie, das die visuellen Verständnisfähigkeiten verbessert. Es basiert auf der…DeepSeek-V4-Flash-Vision-Exp ist ein experimentelles multimodales Modell aus der DeepSeek-V4-Familie, das die visuellen Verständnisfähigkeiten verbessert. Es basiert auf der…

KI-Modelle & LLMs
Top 50 LLMs ansehen

MiniMax M3 ist ein fortschrittliches KI-Modell, das in der Programmierung und agentischen Aufgaben hervorragende Leistungen erbringt. Es verfügt über ein Kontextfenster von 1M und…

KI-Modelle & LLMs

Platz 49 in LLMs

Tool ansehen

Fortschrittliches KI-Modell, das in der Programmierung und agentischen Aufgaben hervorragende Leistungen erbringt. Es verfügt über ein Kontextfenster von 1M und…MiniMax M3 ist ein fortschrittliches KI-Modell, das in der Programmierung und agentischen Aufgaben hervorragende Leistungen erbringt. Es verfügt über ein Kontextfenster von 1M und…

KI-Modelle & LLMs
Platz 49 in LLMs

Ideogram 4

KI-Modelle

Ideogram 4 ist ein hochmodernes Text-zu-Bild-Modell, das unvergleichliche Kontrolle über Bildkomposition, Stil und Layout bietet. Es unterstützt native 2k-Auflösung und…

KI-Modelle & LLMs
Tool ansehen

KI-Modelle

Hochmodernes Text-zu-Bild-Modell, das unvergleichliche Kontrolle über Bildkomposition, Stil und Layout bietet. Es unterstützt native 2k-Auflösung und…Ideogram 4 ist ein hochmodernes Text-zu-Bild-Modell, das unvergleichliche Kontrolle über Bildkomposition, Stil und Layout bietet. Es unterstützt native 2k-Auflösung und…

KI-Modelle & LLMs
Top 5 KI-Modelle ansehen

SmolVLM2 ist ein fortschrittliches Videoverstehensmodell, das für eine effiziente Ausführung auf verschiedenen Geräten entwickelt wurde. Es bietet verbesserte Videoanalyse- und…

KI-Modelle & LLMs
Tool ansehen

Fortschrittliches Videoverstehensmodell, das für eine effiziente Ausführung auf verschiedenen Geräten entwickelt wurde. Es bietet verbesserte Videoanalyse- und…SmolVLM2 ist ein fortschrittliches Videoverstehensmodell, das für eine effiziente Ausführung auf verschiedenen Geräten entwickelt wurde. Es bietet verbesserte Videoanalyse- und…

KI-Modelle & LLMs
Top 5 KI-Modelle ansehen

Pixtral-12B-2409 ist ein multimodales KI-Modell mit 12 Milliarden Parametern und einem 400 Millionen Parameter Vision-Encoder, das für fortgeschrittene Bild- und…

KI-Modelle & LLMs
Tool ansehen

Multimodales KI-Modell mit 12 Milliarden Parametern und einem 400 Millionen Parameter Vision-Encoder, das für fortgeschrittene Bild- und…Pixtral-12B-2409 ist ein multimodales KI-Modell mit 12 Milliarden Parametern und einem 400 Millionen Parameter Vision-Encoder, das für fortgeschrittene Bild- und…

KI-Modelle & LLMs
Top 5 KI-Modelle ansehen

V-JEPA

KI-GitHub-Repos

V-JEPA ist eine PyTorch-Implementierung für selbstüberwachtes Lernen aus Videos. Sie nutzt eine Joint-Embedding Predictive Architecture, um visuelle Repräsentationen ohne…

KI-Modelle & LLMs
Tool ansehen

KI-GitHub-Repos

PyTorch-Implementierung für selbstüberwachtes Lernen aus Videos. Sie nutzt eine Joint-Embedding Predictive Architecture, um visuelle Repräsentationen ohne…V-JEPA ist eine PyTorch-Implementierung für selbstüberwachtes Lernen aus Videos. Sie nutzt eine Joint-Embedding Predictive Architecture, um visuelle Repräsentationen ohne…

KI-Modelle & LLMs
Top 250 KI-GitHub-Repos ansehen

LTX-2

KI-Modelle

LTX-2 ist ein auf DiT basierendes Audio-Video-Grundmodell, das entwickelt wurde, um synchronisierte Videos und Audios zu generieren. Es kombiniert moderne…

KI-Modelle & LLMs
Tool ansehen

KI-Modelle

Auf DiT basierendes Audio-Video-Grundmodell, das entwickelt wurde, um synchronisierte Videos und Audios zu generieren. Es kombiniert moderne…LTX-2 ist ein auf DiT basierendes Audio-Video-Grundmodell, das entwickelt wurde, um synchronisierte Videos und Audios zu generieren. Es kombiniert moderne…

EmpfohlenKI-Modelle & LLMs
Top 5 KI-Modelle ansehen
1 von 8