Beschreibung
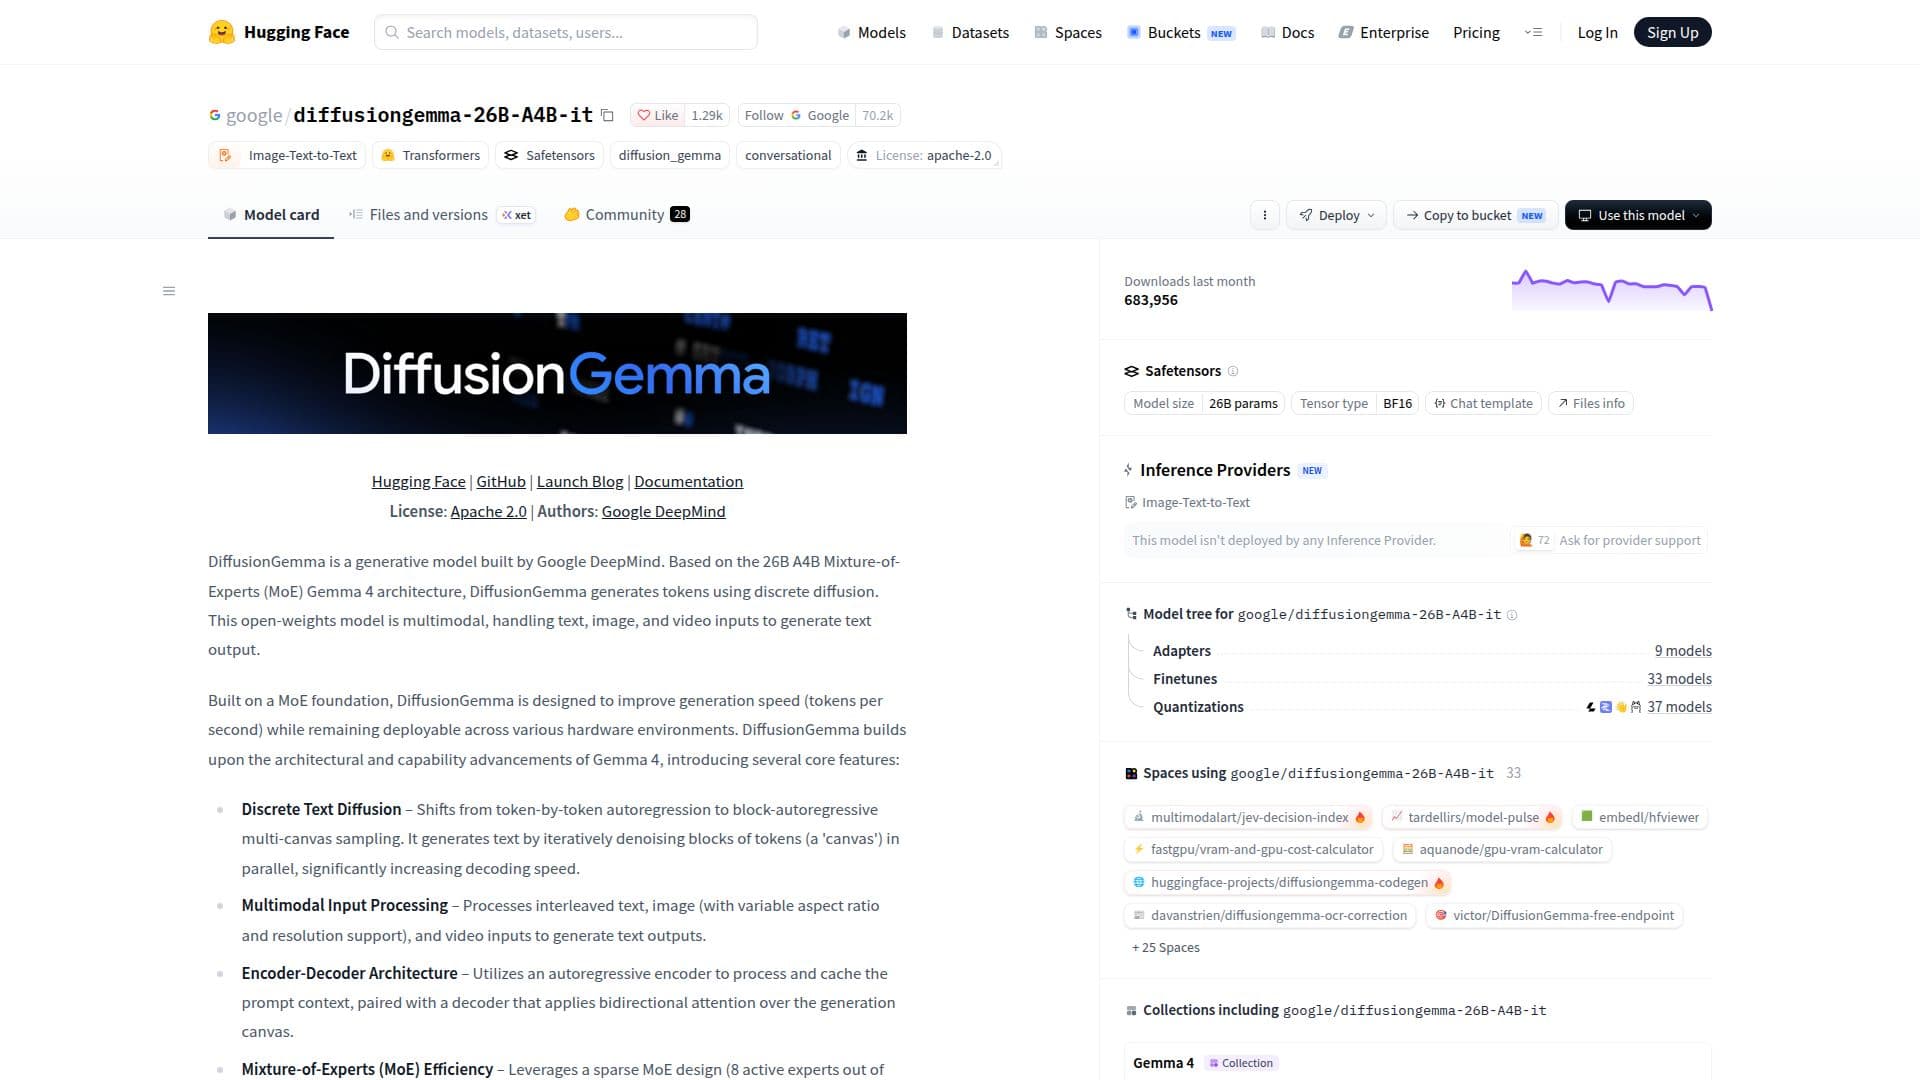
DiffusionGemma, entwickelt von Google DeepMind, ist ein generatives Modell, das die 26B A4B Mixture-of-Experts (MoE) Gemma 4 Architektur nutzt. Es ist darauf ausgelegt, Texteingaben aus multimodalen Eingaben, einschließlich Text, Bildern und Videos, zu generieren. Das Modell verwendet diskrete Diffusion, um die Geschwindigkeit der Token-Generierung zu erhöhen, was es für den Einsatz in verschiedenen Hardware-Umgebungen geeignet macht.
Weiterlesen
Die Architektur des Modells verfügt über eine block-autoregressive Multi-Canvas-Sampling-Methode, die die Dekodierungsgeschwindigkeit erheblich erhöht, indem Blöcke von Tokens parallel entrauscht werden. Dieser Ansatz ermöglicht es DiffusionGemma, Texte schneller zu generieren als traditionelle autoregressive Modelle. Die Encoder-Decoder-Architektur nutzt einen autoregressiven Encoder, um den Kontext des Prompts zu verarbeiten und zwischenzuspeichern, während der Decoder bidirektionale Aufmerksamkeit über die Generierungs-Canvas anwendet.
Das spärliche MoE-Design von DiffusionGemma, mit 8 aktiven Experten aus 128, bietet starke Denkfähigkeiten und gleichzeitig einen geringen Speicherbedarf. Diese Effizienz macht es geeignet für die lokale Ausführung und optimiert für Inferenz mit kleinen Batch-Größen, wodurch eine Hochgeschwindigkeitsgenerierung auf einem einzelnen fähigen Beschleuniger erreicht wird.
Das Modell unterstützt native System-Prompt-Updates, die strukturierte und kontrollierbare Gespräche ermöglichen. Es enthält auch einen konfigurierbaren Denkmodus für verbesserte Denkfähigkeiten. Mit einem Kontextfenster von bis zu 256K Tokens kann DiffusionGemma Aufgaben mit langem Kontext effektiv bewältigen.
DiffusionGemma wurde gegen verschiedene Benchmarks evaluiert und zeigt wettbewerbsfähige Leistungen in Textgenerierungs- und Denkaufgaben. Es unterstützt mehrsprachige Fähigkeiten, ist auf über 140 Sprachen vortrainiert und bietet robuste Funktionen zum Verständnis von Bildern und Videos, einschließlich Objekterkennung, Dokumentenverarbeitung und Videoanalyse.
Insgesamt ist DiffusionGemma ein vielseitiges Modell, das für die Hochgeschwindigkeits-Generierung multimodaler Texte konzipiert ist und sich für eine Vielzahl von Anwendungen in der Inhaltserstellung, Forschung und Bildung eignet.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Weights
- BereitstellungCloud
- PlattformenWeb
DiffusionGemma im Überblick
Diskrete Textdiffusion
Verarbeitung multimodaler Eingaben
Encoder-Decoder-Architektur
Effizienz der Mixture-of-Experts
Denkmodus
Optimiert für Inferenz mit kleinen Batch-Größen
Unterstützung für native System-Prompts
Verarbeitung von langem Kontext
Erste Schritte mit DiffusionGemma
Zugriff auf die Modellseite: Besuchen Sie die Hugging Face Modellseite
Authentifizierung: Melden Sie sich an oder erstellen Sie ein Konto
Konfiguration: Richten Sie die Modellparameter ein
Eingabeaufforderungen senden: Geben Sie Text-, Bild- oder Videoaufforderungen ein
Feinabstimmung: Passen Sie die Einstellungen für spezifische Aufgaben an
DiffusionGemma's Anwendungsfälle
- Textgenerierung
- Bilddatenextraktion
- Videoverständnis
- Mehrsprachige Unterstützung
- Forschung und Bildung