

Zum Hauptinhalt springen
ToolPotion
KI-Berater
Einreichen

BERT Multilinguale Modelle

LLMs#46KI-Modelle & LLMsOpen Source · Web

BERT bietet zwei mehrsprachige Modelle: Cased und Uncased, die über 100 Sprachen unterstützen. Das Cased-Modell wird für nicht-lateinische Alphabete und allgemeine Zwecke empfohlen, während das Uncased-Modell eine ältere Version ist. Diese Modelle sind für Aufgaben des natürlichen Sprachverständnisses konzipiert und können für spezifische Anwendungen feinabgestimmt werden.

URL besuchen
Teilen
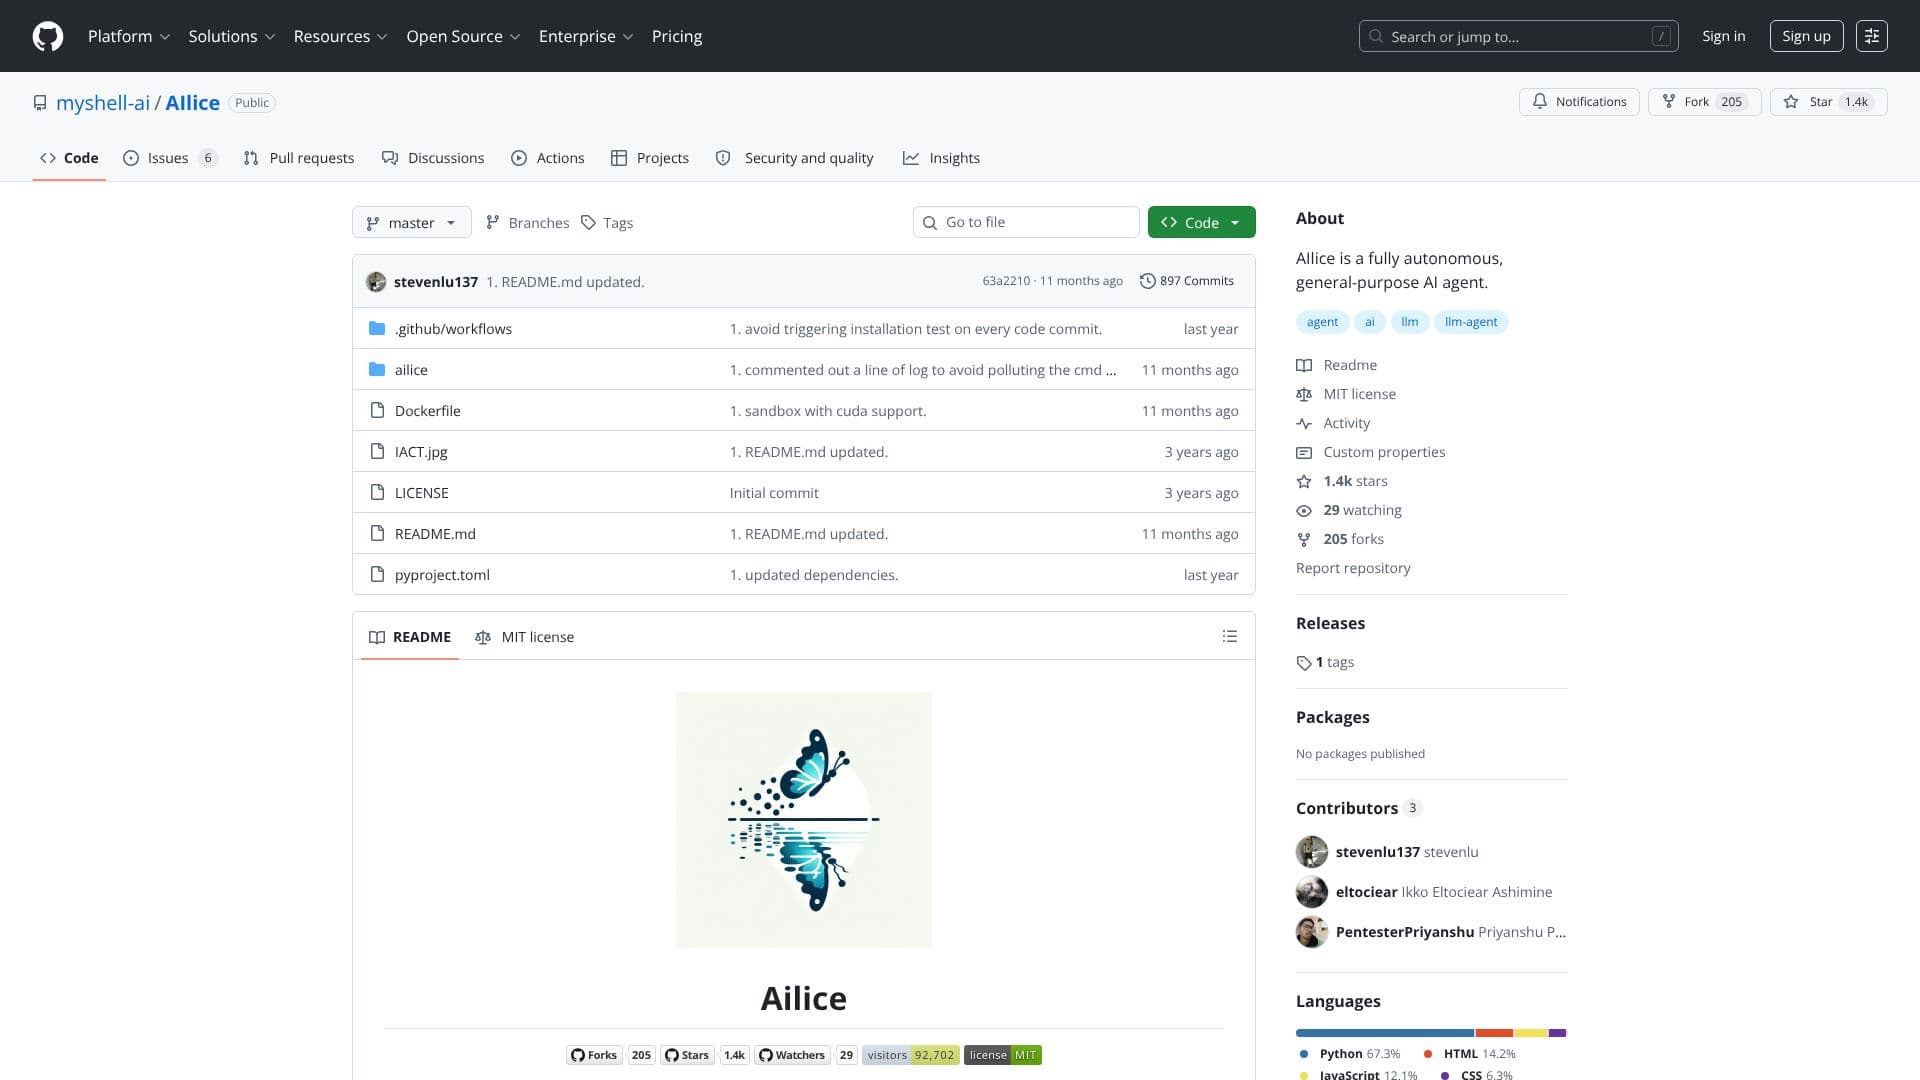
Screenshot von BERT Multilinguale Modelle

Das BERT (Bidirectional Encoder Representations from Transformers)-Projekt stellt vortrainierte Modelle für Aufgaben der natürlichen Sprachverarbeitung bereit. Zu seinen Angeboten gehören mehrsprachige Modelle, die für eine Vielzahl von Sprachen entwickelt wurden und sprachübergreifendes Verständnis und Anwendungen ermöglichen. Derzeit sind zwei primäre mehrsprachige Modelle verfügbar: BERT-Base, Multilingual Cased (Neu, empfohlen) und BERT-Base, Multilingual Uncased (Orig, nicht empfohlen).

Weiterlesen

Das BERT-Base, Multilingual Cased-Modell unterstützt 104 Sprachen und verfügt über eine 12-Schichten-Architektur mit 768 Hidden Units, 12 Attention Heads und 110 Millionen Parametern. Dieses Modell wird aufgrund seiner verbesserten Normalisierung für viele Sprachen, insbesondere für solche mit nicht-lateinischen Alphabeten, empfohlen. Bei der Verwendung dieses Modells ist es entscheidend, `--do_lower_case=false` in den Ausführungsskripten zu setzen. Das Multilingual Uncased-Modell, das 102 Sprachen mit der gleichen Architektur unterstützt, wird für neue Projekte nicht empfohlen.

Für chinesische Sprachaufgaben ist auch ein dediziertes BERT-Base, Chinese-Modell verfügbar, das vereinfachtes und traditionelles Chinesisch unterstützt. Obwohl die mehrsprachigen Modelle Chinesisch enthalten, kann ein reines Chinesisch-Modell für die chinesisch-spezifische Feinabstimmung bessere Ergebnisse liefern. Die Leistung dieser Modelle wurde auf dem XNLI-Datensatz, einer sprachübergreifenden Aufgabe zur Schlussfolgerung natürlicher Sprache, bewertet. Die Ergebnisse deuten darauf hin, dass einzelne Sprachmodelle für Sprachen mit vielen Ressourcen mehrsprachigen Modellen überlegen sein mögen, aber letztere eine praktische Lösung für eine breite Sprachabdeckung bieten, ohne dass zahlreiche einzelne Sprachmodelle gepflegt werden müssen.

Die Feinabstimmung der mehrsprachigen BERT-Modelle erfordert keine wesentlichen API-Änderungen. Möglicherweise sind jedoch Aktualisierungen des `BasicTokenizer` für die Tokenisierung chinesischer Zeichen erforderlich. Die Modelle können mithilfe bereitgestellter Skripte wie `run_classifier.py`, das zur Unterstützung von Datensätzen wie XNLI aktualisiert wurde, in Arbeitsabläufe integriert werden. Die Datenstichprobenstrategie für das Vortraining umfasste eine exponentiell geglättete Gewichtung von Wikipedia-Daten, um Sprachen mit vielen und wenigen Ressourcen auszugleichen und eine bessere Darstellung für alle zu gewährleisten. Die Tokenisierung verwendet ein gemeinsames WordPiece-Vokabular mit spezifischer Behandlung für CJK-Sprachen, um das Fehlen von Leerzeichen zu berücksichtigen. Das mehrsprachige Modell lässt bewusst Sprachmarker weg, um Zero-Shot-Lernfähigkeiten zu ermöglichen.

  • KategorieKI-Modelle & LLMs
  • PreismodellOpen Source
  • BereitstellungCloud
  • PlattformenWeb

  • Unterstützt 104 Sprachen (Multilingual Cased)

  • Unterstützt 102 Sprachen (Multilingual Uncased)

  • 12-Schichten-Transformer-Architektur

  • 768 Hidden Units

  • 12 Attention Heads

  • 110 Millionen Parameter

  • Multilingual Cased-Modell empfohlen für verbesserte Normalisierung

  • Zero-Shot-Lernfähigkeit

  • Unterstützung für Feinabstimmung für spezifische Aufgaben

  • Vortrainiert auf Wikipedia-Daten

  • Gemeinsames WordPiece-Vokabular

  • Verarbeitet CJK-Sprachen mit Zeichen-Tokenisierung

  • Open-Source TensorFlow-Code verfügbar

  1. Modellzugriff: Laden Sie vortrainierte mehrsprachige BERT-Modelle herunter.

  2. Umgebung einrichten: Installieren Sie TensorFlow und notwendige Abhängigkeiten.

  3. Integration über API: Laden Sie Modelle und Tokenizer mit bereitgestellten Bibliotheken.

  4. Daten vorbereiten: Formatieren Sie Ihre mehrsprachigen Textdaten für Training oder Inferenz.

  5. Feinabstimmung: Passen Sie das Modell an spezifische Downstream-Aufgaben wie Klassifizierung oder Fragebeantwortung an.

  6. Inferenz ausführen: Verwenden Sie das feinabgestimmte Modell zur Verarbeitung neuer Textdaten.

  7. Leistung bewerten: Beurteilen Sie die Modellgenauigkeit auf relevanten mehrsprachigen Benchmarks.

  • Sprachübergreifende Klassifizierung
  • Mehrsprachige Sentiment-Analyse
  • Zero-Shot sprachübergreifende Übertragung
  • Bewertung maschineller Übersetzung
  • Mehrsprachige Fragebeantwortung
  • Sprachübergreifende Informationssuche
  • Schlussfolgerung natürlicher Sprache

Von Google

BERT Multilinguale Modelle Bewertungen

Wird geladen...

Beliebte KI-Tools wie BERT Multilinguale Modelle

Das BERT-Basismodell (uncased) ist ein vortrainiertes Transformermodell, das für das Verständnis der englischen Sprache entwickelt wurde. Es nutzt maskiertes Sprachmodellieren und…

Tools für Verarbeitung natürlicher Sprache
Tool ansehen

Das BERT-Basismodell (uncased) ist ein vortrainiertes Transformermodell, das für das Verständnis der englischen Sprache entwickelt wurde. Es nutzt maskiertes Sprachmodellieren und…

EmpfohlenTools für Verarbeitung natürlicher Sprache
Top 5 KI-Modelle ansehen

SmolLM3 ist ein Sprachmodell mit 3 Milliarden Parametern, das entwickelt wurde, um die Grenzen kleiner Modelle zu erweitern. Es unterstützt duales Modus-Reasoning, sechs Sprachen…

KI-Modelle & LLMs

Platz 45 in LLMs

Tool ansehen

Sprachmodell mit 3 Milliarden Parametern, das entwickelt wurde, um die Grenzen kleiner Modelle zu erweitern. Es unterstützt duales Modus-Reasoning, sechs Sprachen…SmolLM3 ist ein Sprachmodell mit 3 Milliarden Parametern, das entwickelt wurde, um die Grenzen kleiner Modelle zu erweitern. Es unterstützt duales Modus-Reasoning, sechs Sprachen…

KI-Modelle & LLMs
Platz 45 in LLMs

SpanBERT

KI-GitHub-Repos

SpanBERT ist ein KI-Modell, das auf die Verbesserung des Pre-Trainings durch die Darstellung und Vorhersage von Spans (Textabschnitten) fokussiert ist. Es bietet vortrainierte…

KI-Modelle & LLMs
Tool ansehen

KI-GitHub-Repos

KI-Modell, das auf die Verbesserung des Pre-Trainings durch die Darstellung und Vorhersage von Spans (Textabschnitten) fokussiert ist. Es bietet vortrainierte…SpanBERT ist ein KI-Modell, das auf die Verbesserung des Pre-Trainings durch die Darstellung und Vorhersage von Spans (Textabschnitten) fokussiert ist. Es bietet vortrainierte…

KI-Modelle & LLMs
Top 250 KI-GitHub-Repos ansehen

XLM-RoBERTa ist ein mehrsprachiges Modell, das auf 2,5 TB Daten in 100 Sprachen vortrainiert wurde. Es glänzt in Aufgaben wie Sequenzklassifikation und Tokenklassifikation und ist…

KI-Modelle & LLMs
Tool ansehen

Mehrsprachiges Modell, das auf 2,5 TB Daten in 100 Sprachen vortrainiert wurde. Es glänzt in Aufgaben wie Sequenzklassifikation und Tokenklassifikation und ist…XLM-RoBERTa ist ein mehrsprachiges Modell, das auf 2,5 TB Daten in 100 Sprachen vortrainiert wurde. Es glänzt in Aufgaben wie Sequenzklassifikation und Tokenklassifikation und ist…

EmpfohlenKI-Modelle & LLMs
Top 5 KI-Modelle ansehen

DeepSeek ist ein KI-Forschungsunternehmen, das sich der Entwicklung allgemeiner künstlicher Intelligenz widmet. Es bietet Open-Source-Frontier-LLMs wie DeepSeek-V4, DeepSeek-R1…

KI-Modelle & LLMs

Platz 2 in LLMs

Tool ansehen

KI-Forschungsunternehmen, das sich der Entwicklung allgemeiner künstlicher Intelligenz widmet. Es bietet Open-Source-Frontier-LLMs wie DeepSeek-V4, DeepSeek-R1…DeepSeek ist ein KI-Forschungsunternehmen, das sich der Entwicklung allgemeiner künstlicher Intelligenz widmet. Es bietet Open-Source-Frontier-LLMs wie DeepSeek-V4, DeepSeek-R1…

EmpfohlenKI-Modelle & LLMs
Platz 2 in LLMs

Qwen1.5-110B ist ein transformer-basiertes Sprachmodell, das erhebliche Leistungsverbesserungen, mehrsprachige Unterstützung und eine stabile Kontextlänge von 32K bietet. Ideal…

KI-Modelle & LLMs
Tool ansehen

Transformer-basiertes Sprachmodell, das erhebliche Leistungsverbesserungen, mehrsprachige Unterstützung und eine stabile Kontextlänge von 32K bietet. Ideal…Qwen1.5-110B ist ein transformer-basiertes Sprachmodell, das erhebliche Leistungsverbesserungen, mehrsprachige Unterstützung und eine stabile Kontextlänge von 32K bietet. Ideal…

KI-Modelle & LLMs
Top 5 KI-Modelle ansehen

Das intfloat multilingual-e5-large Modell ist ein robustes KI-Tool, das für mehrsprachige Text-Embeddings entwickelt wurde. Es unterstützt 100 Sprachen und ist für Aufgaben wie…

KI-Modelle & LLMs
Tool ansehen

Llama-3.1-8B-Instruct ist ein mehrsprachiges großes Sprachmodell, das von Meta entwickelt wurde und für auf Anweisungen basierende Aufgaben optimiert ist. Es ist für kommerzielle…

KI-Modelle & LLMs
Tool ansehen

Mehrsprachiges großes Sprachmodell, das von Meta entwickelt wurde und für auf Anweisungen basierende Aufgaben optimiert ist. Es ist für kommerzielle…Llama-3.1-8B-Instruct ist ein mehrsprachiges großes Sprachmodell, das von Meta entwickelt wurde und für auf Anweisungen basierende Aufgaben optimiert ist. Es ist für kommerzielle…

EmpfohlenKI-Modelle & LLMs
Top 5 KI-Modelle ansehen
1 von 8








