Beschreibung
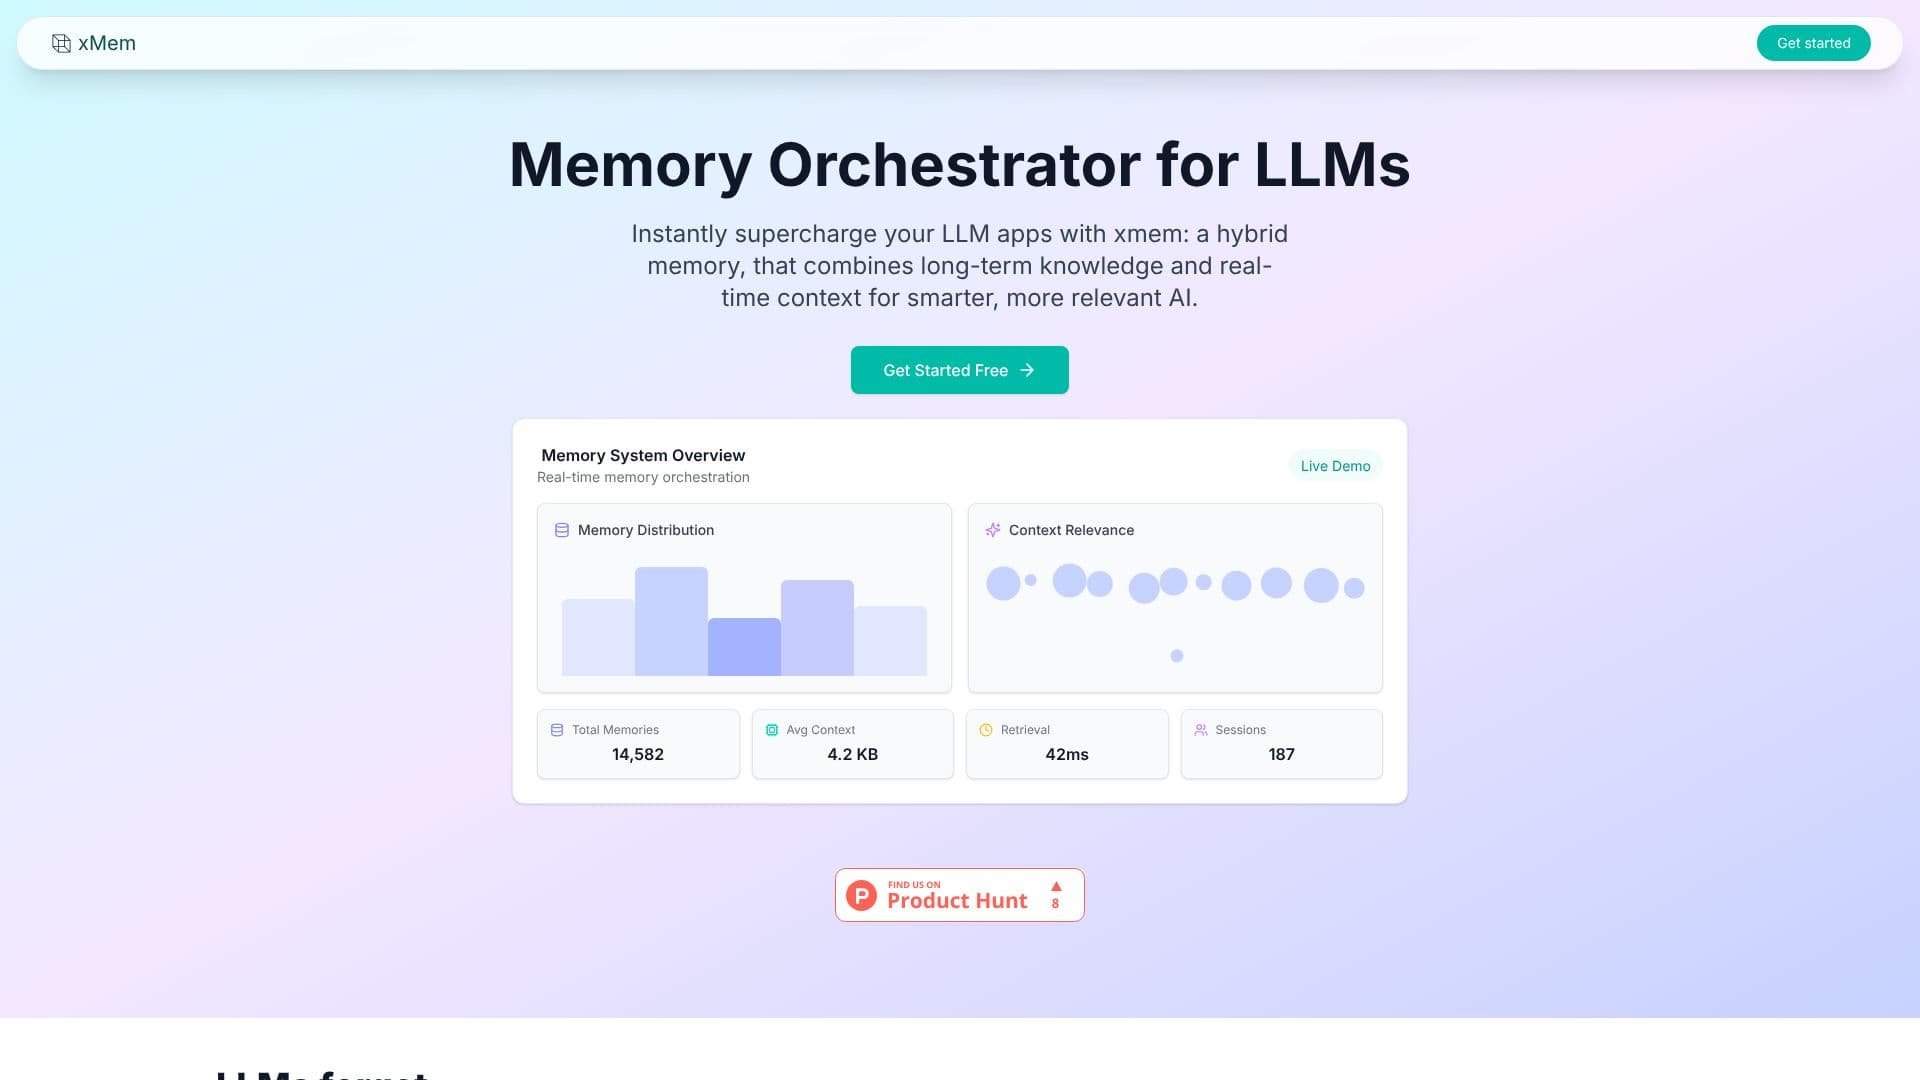
LLMs haben oft Probleme mit dem Gedächtnis, was zu verlorenem Kontext und repetitiven Benutzererlebnissen führt. xMem begegnet dieser Herausforderung, indem es ein hybrides Speichersystem bereitstellt, das sowohl langfristiges Wissen als auch Echtzeit-Sitzungskontext für jede LLM-Interaktion orchestriert. Dies stellt sicher, dass Ihre KI-Anwendungen relevant, genau und auf dem neuesten Stand bleiben, auch über mehrere Sitzungen hinweg.
Weiterlesen
xMems System ist darauf ausgelegt, die häufigen Fallstricke des LLM-Gedächtnisverlusts zu vermeiden. Es kombiniert einen persistenten Speicher für langfristiges Wissen, Dokumente und Notizen, der über Vektorsuche zugänglich ist, mit einer Sitzungsspeicherkomponente, die aktuelle Konversationen, Anweisungen und Kontext für den sofortigen Abruf verfolgt. Dieser duale Ansatz ermöglicht LLMs den Zugriff auf ein umfassendes Verständnis vergangener Interaktionen und gespeicherter Informationen.
Der Kern der Funktionalität von xMem liegt in seiner RAG (Retrieval-Augmented Generation)-Orchestrierung. Es stellt automatisch den relevantesten Kontext für jeden LLM-Aufruf zusammen, wodurch manuelles Tuning überflüssig wird. Der Datenfluss beinhaltet die Verarbeitung von Benutzeranfragen über Sitzungsspeicher und Vektordatenbanken (wie Qdrant, ChromaDB, Pinecone), bevor sie mit dem optimal zusammengestellten Kontext an LLM-Anbieter (wie Llama.cpp, Ollama, OpenAI) weitergeleitet werden.
Darüber hinaus verfügt xMem über einen dynamischen, sich entwickelnden Wissensgraphen, der Konzepte, Fakten und Benutzerkontext in Echtzeit verknüpft. Dieser Graph ermöglicht es LLMs, Informationen zu verarbeiten, abzurufen und zu verbinden, ähnlich wie ein menschliches Gehirn, was zu intelligenteren und relevanteren Antworten führt. Diese Fähigkeit ist besonders vorteilhaft für Anwendungen wie RAG, Agenten und Copilots.
xMem ist nach einer Open-Source-Philosophie aufgebaut und gewährleistet die Kompatibilität mit einer breiten Palette von Open-Source-LLMs und Vektordatenbanken. Seine mühelose Integration wird durch eine einfach zu bedienende API und ein Überwachungs-Dashboard erleichtert. Das System bietet intelligentes Speichermanagement, semantische Suche und Abruf durch Vektordatenbank-Integration sowie Echtzeit-Kontextzusammenstellung zur Verarbeitung von Kontextgrößen bis zu 8,2 KB bei geringer Latenz.
- KategorieVektordatenbanken & Retrieval
- PreismodellKostenloser Tarif
- BereitstellungSelbstgehostet / Cloud
- PlattformenWeb
xMem's Kernfunktionen
Hybrides Speichersystem, das Langzeit- und Sitzungskontext kombiniert
Persistenter Speicher für Benutzerwissen und Kontext
Sitzungsspeicher zur Verfolgung aktueller Interaktionen
RAG-Orchestrierung zur automatischen Kontextzusammenstellung
Echtzeit-Wissensgraph zur Verknüpfung von Konzepten
Vektorsuche für den Wissensabruf
Unterstützung für Open-Source-LLMs (Llama, Mistral, etc.)
Integration mit verschiedenen Vektordatenbanken (Qdrant, ChromaDB, Pinecone)
Einfache API für nahtlose Integration
Überwachungs-Dashboard zur Übersicht
Intelligentes Speichermanagement
Semantische Such- und Abruffunktionen
Dynamische und sich entwickelnde Wissensstruktur
Wie verwendet man xMem?
Konfigurieren: Richten Sie Ihren Vektorspeicher, Sitzungsspeicher und LLM-Anbieter ein.
Integrieren: Verwenden Sie die xMem API, um Ihre LLM-Anwendung zu verbinden.
Abfragen: Senden Sie Prompts an den Orchestrator für kontextbezogen relevante Antworten.
Überwachen: Nutzen Sie das Dashboard, um Speichernutzung und Leistung zu verfolgen.
Optimieren: Verfeinern Sie die Kontextzusammenstellung und den Wissensgraphen für verbesserte KI-Genauigkeit.
xMem's Anwendungsfälle
- Kontextbezogene Chatbots
- Personalisierte Assistenten
- RAG-Systeme
- KI-Agenten
- Copilots
- Wissensmanagement
- Kundensupport-KI