Beschreibung
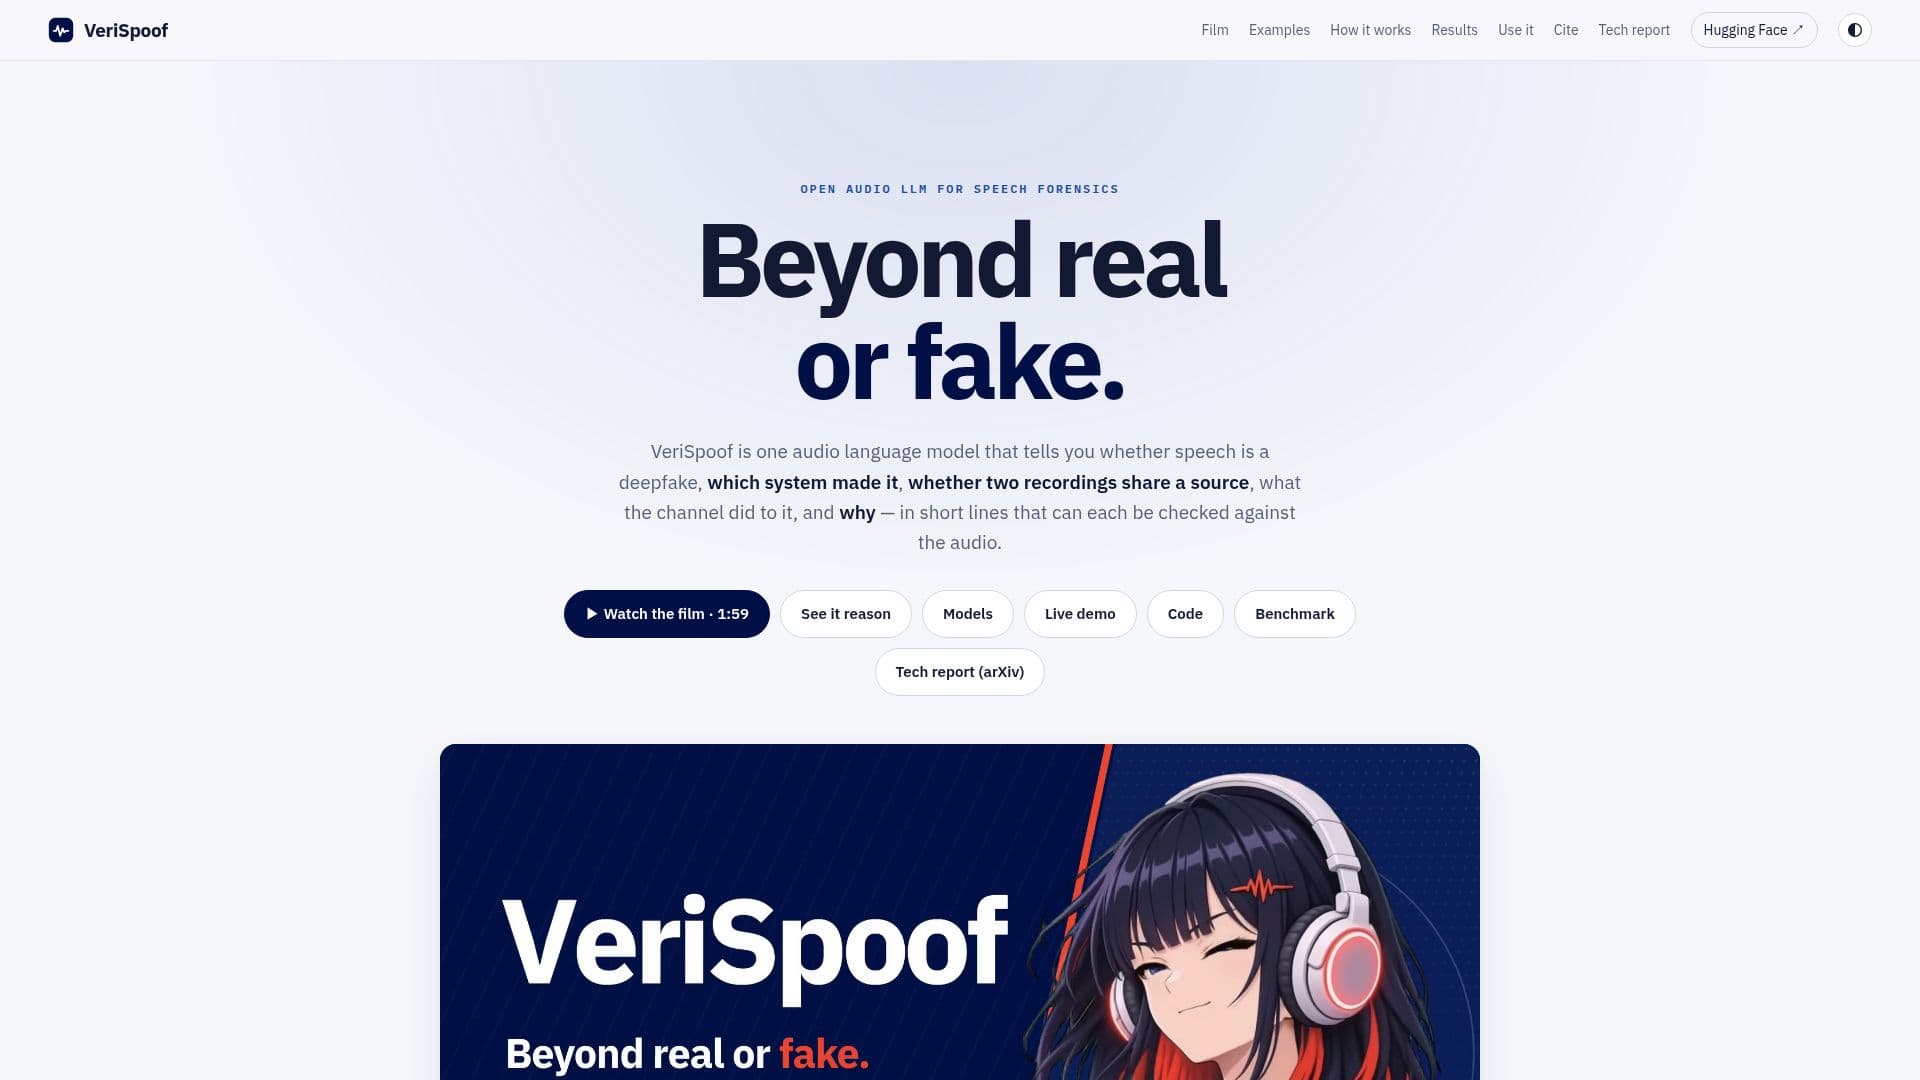
VeriSpoof ist ein bahnbrechendes Audio-Sprachmodell, das für fortschrittliche Forensik von Sprach-Deeptakes entwickelt wurde. Es bietet eine umfassende Lösung zur Bestimmung, ob Sprache ein Deeptake ist, identifiziert das System, das es erzeugt hat, bewertet, ob zwei Aufnahmen eine gemeinsame Quelle haben, analysiert Kanaleffekte und erklärt seine Schlussfolgerungen auf transparente, überprüfbare Weise.
Weiterlesen
Das Modell hat außergewöhnliche Leistungen gezeigt und einen pooled Equal Error Rate (EER) von 2,14 % über 14 Speech-DF-Arena-Sets erreicht, wodurch es als der am höchsten eingestufte offene Gewichtdetektor positioniert ist. Seine Architektur basiert auf einem Audio-LLM (Large Language Model), das Aufnahmen in Äußerungs- und Rahmentoken umwandelt, die dann von einem MiniCPM5-2B-Modell mit LoRA gelesen werden. Im Gegensatz zu traditionellen Systemen verlässt sich VeriSpoof nicht auf separate Aufgabenköpfe; stattdessen ist jede Antwort ein Satz, dessen Wahrscheinlichkeit direkt als Punktzahl dient, was eine flexible Schwellenwertbestimmung an jedem Betriebspunkt ermöglicht.
Die Begründung von VeriSpoof ist eine zentrale Stärke, wobei jede Zeile seiner Argumentation unabhängig gegen Wellenformmessungen, protokollierte Bedingungen, beschriftete Zeitspannen und Generator-Metadaten überprüft wird. Dies stellt sicher, dass Beobachtungen, Kanalstatus, Lokalisierung synthetisierter Segmente und Quellprofile rigoros validiert werden. Das System umfasst auch kontrafaktisches Training, bei dem Entscheidungen darauf trainiert werden, den angegebenen Beweisen zu folgen, selbst wenn die Lokalisierung absichtlich umgekehrt wird, um robustes und logisch konsistentes Denken zu gewährleisten.
VeriSpoof ist hauptsächlich für die Forschung zur Erkennung von Deeptakes, Quellverfolgung und erklärbarer Forensik gedacht und bietet ein leistungsstarkes Werkzeug zur Überprüfung von Audiourteilen. Es wird empfohlen, seine Punktzahlen mit anderen Beweisen und menschlicher Überprüfung für endgültige forensische Entscheidungen zu kombinieren. Das Projekt umfasst sowohl ein Basis- als auch ein Plus-Modell, wobei VeriSpoof-Plus in verschiedenen Bewertungsmetriken und Datensätzen eine überlegene Leistung zeigt. Die Gewichte und der Code für VeriSpoof werden unter einer CC BY-NC 4.0-Lizenz veröffentlicht, während seine Basismodelle, MiniCPM5-2B und Qwen3-ASR-1.7B, unter Apache-2.0 betrieben werden.
- KategorieKI-Inhaltsdetektoren
- PreismodellFree (Open-Weight)
- BereitstellungLocal (Inference Package)
- PlattformenWindows, macOS, Linux
VeriSpoof's Kernfunktionen
Erkennung von Sprach-Deeptakes: Identifiziert, ob Sprache ein Deeptake ist.
Quellenverifizierung: Bestimmt, welches System den Deeptake erzeugt hat.
Quellenattribution: Stellt fest, ob zwei Aufnahmen von demselben Generator stammen.
Kanalbeschreibung: Analysiert und beschreibt die Kanaleffekte auf Audio.
Erklärbare Entscheidungen: Bietet kurze, überprüfbare Aussagen zur Erklärung seiner Schlussfolgerungen.
Fundierte Begründung: Jede Behauptung wird gegen Wellenformmessungen und Datensatzbeschriftungen überprüft.
Hohe Genauigkeit: Erreichte 2,14 % pooled EER auf Speech-DF-Arena und belegt Platz 1 unter den offenen Gewichtdetektoren.
Einheitliches Audio-LLM: Ein Modell behandelt alle forensischen Fragen ohne separate Aufgabenköpfe.
Punktzahlbasierte Antworten: Antworten sind Sätze, deren Wahrscheinlichkeit die Punktzahl darstellt.
Kontrafaktisches Testen: Ermöglicht das Ersetzen der angegebenen Lokalisierung, um Entscheidungen neu zu bewerten.
Offline-Inferenz: Unterstützt das Ausführen von echten Testaufnahmen offline.
Offenes Gewichtmodell: Verfügbar für Forschung und Entwicklung.
Mehrsprachige Untertitel: Filmvorführungen enthalten chinesische und englische Untertitel.
Forschungsorientiert: Entwickelt für die Forschung zu Deeptake-Erkennung, Quellverfolgung und erklärbarer Forensik.
Überprüfbare Urteile: Vier Zeilen zu einem Urteil, das überprüft werden kann.
Wie verwendet man VeriSpoof?
Audio eingeben: Stellen Sie dem Modell eine einzelne Audioaufnahme oder ein Paar Aufnahmen zur Verfügung.
Mit LLM verarbeiten: Die Audioelemente wandeln die Eingabe in Äußerungs- und Rahmentoken für das LLM um.
Ein-Schritt-Antwort erhalten: Erhalten Sie eine sofortige Antwort zum Status des Deeptakes oder zur Ähnlichkeit der Quelle.
Fundierte Begründung überprüfen: Untersuchen Sie die detaillierte, zeilenweise Erklärung für die Entscheidung des Modells.
Behauptungen überprüfen: Überprüfen Sie jede Behauptung in der Begründung gegen Wellenformmessungen und Datensatzbeschriftungen.
Kontrafaktische Tests durchführen: Optional, ändern Sie Parameter wie Lokalisierung und führen Sie das Modell erneut aus, um Änderungen in den Entscheidungen zu beobachten.
VeriSpoof's Anwendungsfälle
- Forschung zur Deeptake-Erkennung
- Audio-Quellenverfolgung
- Erklärbare Forensik
- Analyse von Audio-Kanälen
- Analyse synthetischer Sprache
- Benchmarking von Deeptake-Detektoren