Beschreibung
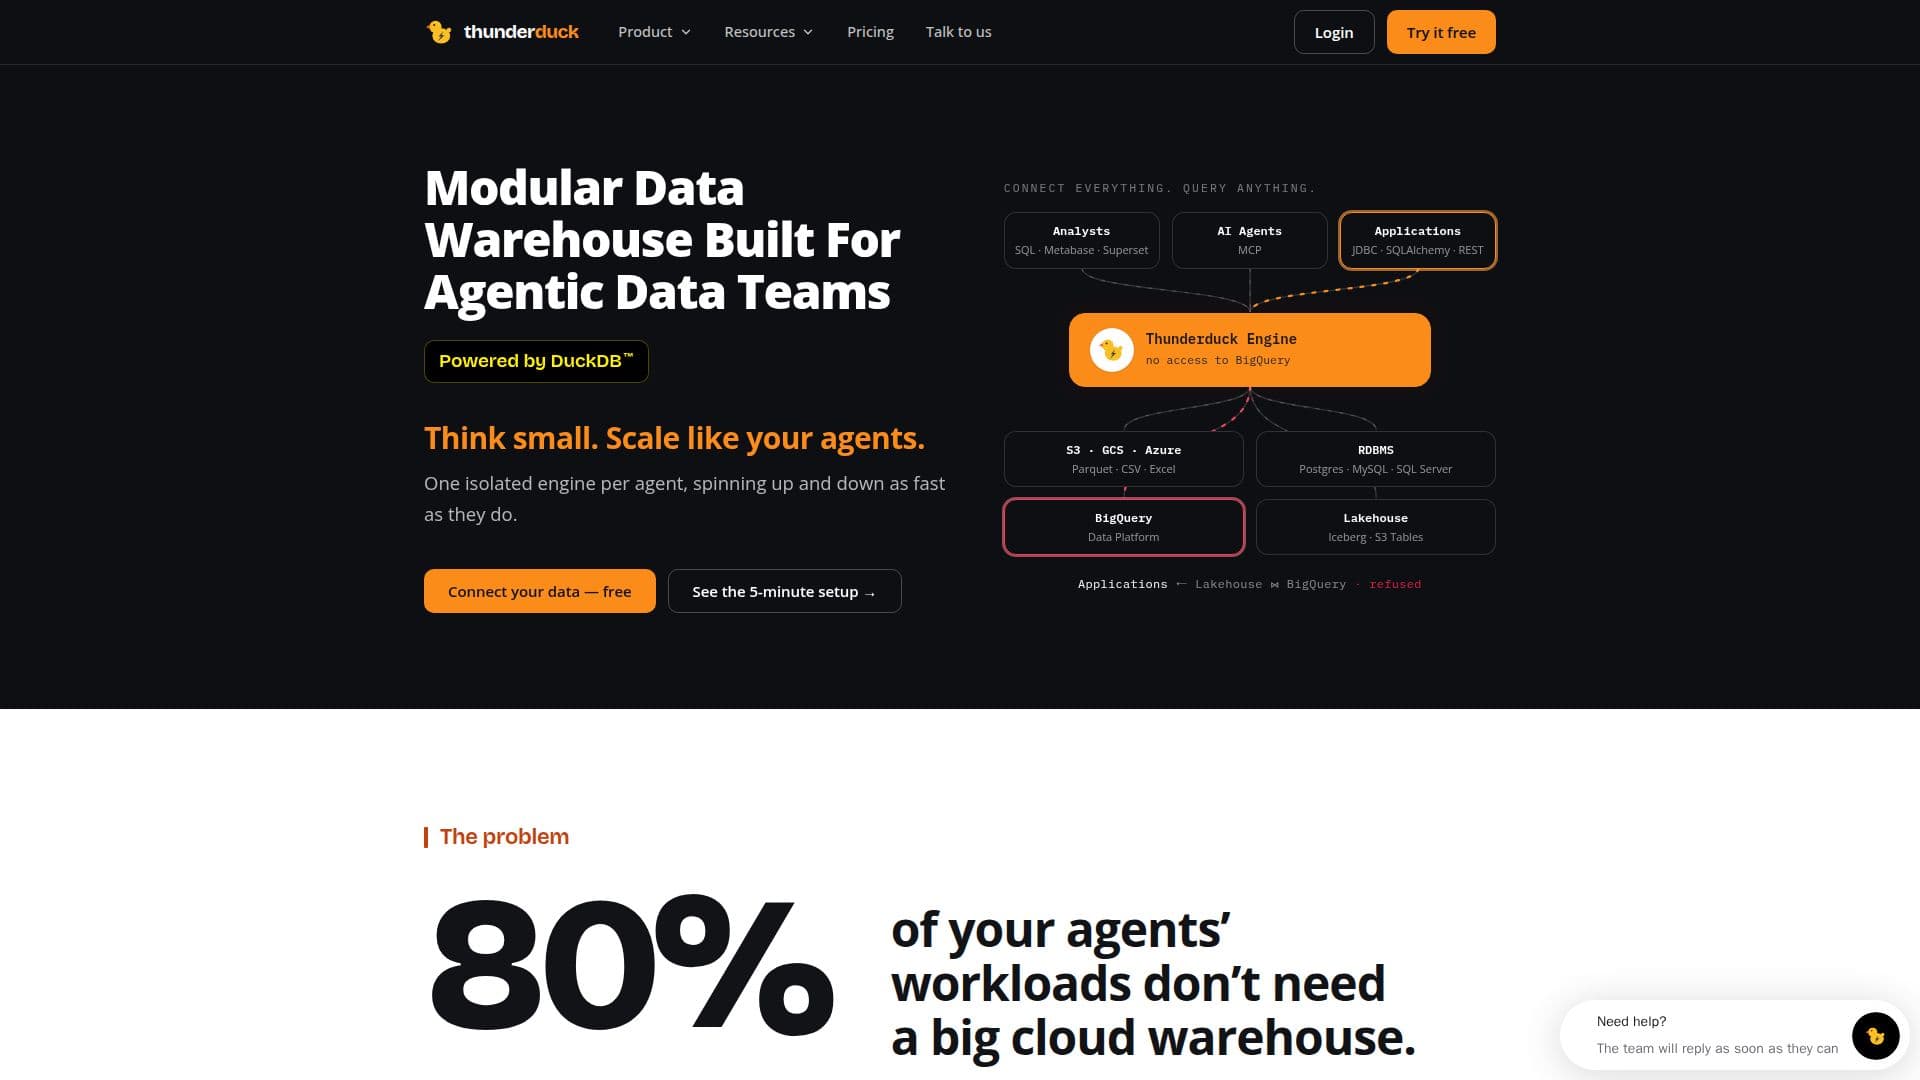
Thunderduck bietet eine modulare Data Warehouse-Lösung, die speziell für agentische Datenteams entwickelt wurde und die Leistungsfähigkeit von DuckDB nutzt. Es adressiert das häufige Problem, dass 80 % der Arbeitslasten von Agenten kein großes Cloud-Warehouse benötigen, während Teams dennoch erhebliche Kosten für verteilte Systeme und verwaltete Dienste tragen. Durch die Bereitstellung einer isolierten Engine pro Agent ermöglicht Thunderduck ein schnelles Hoch- und Herunterfahren der Engines, um der dynamischen Natur agentischer Arbeitslasten gerecht zu werden.
Weiterlesen
Die Plattform ist so konzipiert, dass sie Sub-Sekunden-Abfragen auf Terabytes von Daten liefert, unabhängig von der Anzahl der laufenden Agenten. Sie vereinfacht den Aufbau von Datenpipelines und automatisiert DevOps-Aufgaben, während sie gleichzeitig Unternehmens-gerechte Governance aufrechterhält. Benutzer haben die Flexibilität, Thunderduck überall bereitzustellen, sei es vor Ort mit cloud-ähnlicher Flexibilität oder innerhalb ihrer bestehenden Cloud-Infrastruktur.
Im Kern nutzt Thunderduck DuckDB, eine Open-Source-analytische Datenbank mit einem vektorisierenden Engine. Diese Architektur bedeutet, dass sie dort läuft, wo Ihr Code läuft, wodurch die Notwendigkeit für Servermanagement entfällt. Sie unterstützt Multi-Tenancy und bietet Unternehmens-gerechte Sicherheit, um die Datensouveränität zu gewährleisten, indem Daten innerhalb der Cloud oder des Rechenzentrums des Benutzers unter deren Zugriffsregeln gehalten werden.
Thunderduck ermöglicht eine nahtlose Integration mit KI-Agenten wie Claude, ChatGPT oder Cursor über MCP. Agenten können die Bedeutungen von Tabellen und Spalten interpretieren, nicht nur die Namen, um die richtigen Tabellen zu finden, Partitionen und Indizes zu lesen und effiziente Abfragen zu schreiben. Diese Abfragen laufen unter vordefinierten Rollen und Kostenlimits. Die Plattform kann auch den Aufbau von dbt-Modellen automatisieren, die Medaillon-Schichten folgen, Tests auf Branches durchführen und Pull-Requests öffnen, um saubere und verwaltbare Datenmärkte aufrechtzuerhalten.
Sie unterstützt die Abfrage-Föderation ohne ETL, sodass Benutzer Daten aus verschiedenen Quellen wie Postgres, BigQuery, Iceberg-Tabellen und Dateien in einer einzigen Abfrage zusammenführen können, wobei Filter an jede Quelle weitergegeben werden. Dies beseitigt die Notwendigkeit für Datenkopien, Ladejobs oder Synchronisationsüberwachung für kleine und ad-hoc Daten. Wenn Datensätze wachsen oder Modellierung erfordern, können Benutzer dbt-Pipelines in Iceberg erstellen und weiterhin konsistent abfragen. Thunderduck bietet auch eine Kostenschätzung für jede Abfrage, bevor sie ausgeführt wird, um die Budgetkontrolle zu ermöglichen und unerwartete Ausgaben zu verhindern.
- KategorieKI-SQL- & -Datenbank-Tools
- PreismodellFreemium
- BereitstellungCloud, On-Premise
- PlattformenWeb
Thunderduck's Kernfunktionen
Modulare Data Warehouse-Architektur
Eine isolierte DuckDB-Engine pro Agent
Sub-Sekunden-Abfragen auf Terabytes von Daten
Bereitstellungsoptionen vor Ort oder in der Cloud
Automatisierte DevOps-Aufgaben
Unternehmens-gerechte Governance
Multi-Tenant-Unterstützung
Geringere Latenz ohne verteilte Überlastung
Datensouveränität und Zugriffsregeln
Integration mit KI-Agenten (Claude, ChatGPT, Cursor) über MCP
KI-unterstützte Abfragegenerierung und dbt-Modellierung
Abfrage-Föderation über verschiedene Quellen (PostgreSQL, BigQuery, Iceberg, S3)
Automatische Entdeckung von Schemata, Tabellen, Spalten und Typen
Kosten- und Laufzeitschätzung für jede Abfrage vor der Ausführung
KI-gestützte Diagnose fehlgeschlagener Abfragen und vorgeschlagene Lösungen
Rollenbasierte Zugriffskontrolle für Kataloge
Abfrage-Caching für sofortige, kostenlose Wiederholungsabfragen
Wie verwendet man Thunderduck?
Katalog verbinden: Geben Sie Anmeldeinformationen für Ihre Datenquellen wie Datenbanken, Warehouses, Lakehouses oder Objektspeicher an.
Daten entdecken: Thunderduck liest automatisch Schemata, Tabellen, Spalten und leitet die Bedeutungen der Spalten ab, um sie aktuell zu halten.
Abfragen und verbinden: Sprechen Sie jede Tabelle als katalog.schema.tabelle an und verbinden Sie mehrere Quellen in einer einzigen SQL-Anweisung.
KI-Agenten integrieren: Verbinden Sie Claude, ChatGPT oder andere MCP-Clients, um KI-Agenten zu ermöglichen, Kataloge zu durchsuchen und SQL auszuführen.
Workflows automatisieren: Planen Sie SQL-Anweisungen nach einem Cron-Zeitplan oder verbinden Sie dbt-Repositories, um Builds, Tests und Snapshots auszuführen.
Überwachen und verwalten: Nutzen Sie Kostenschätzungen vor der Abfrage, Audit-Protokolle und rollenbasierte Zugriffskontrolle, um Nutzung und Sicherheit zu verwalten.
Thunderduck's Anwendungsfälle
- Agentische Daten-Workloads
- Kostenoptimierung für Datenteams
- Echtzeit-Datenanalyse
- Automatisierung von Datenpipelines
- Datensouveränität und Sicherheit
- KI-unterstütztes Abfragen
- Datenzusammenführung über verschiedene Quellen
- Proaktive Kostenverwaltung
- Daten-Governance und Auditing
- Lakehouse-Bau