Beschreibung
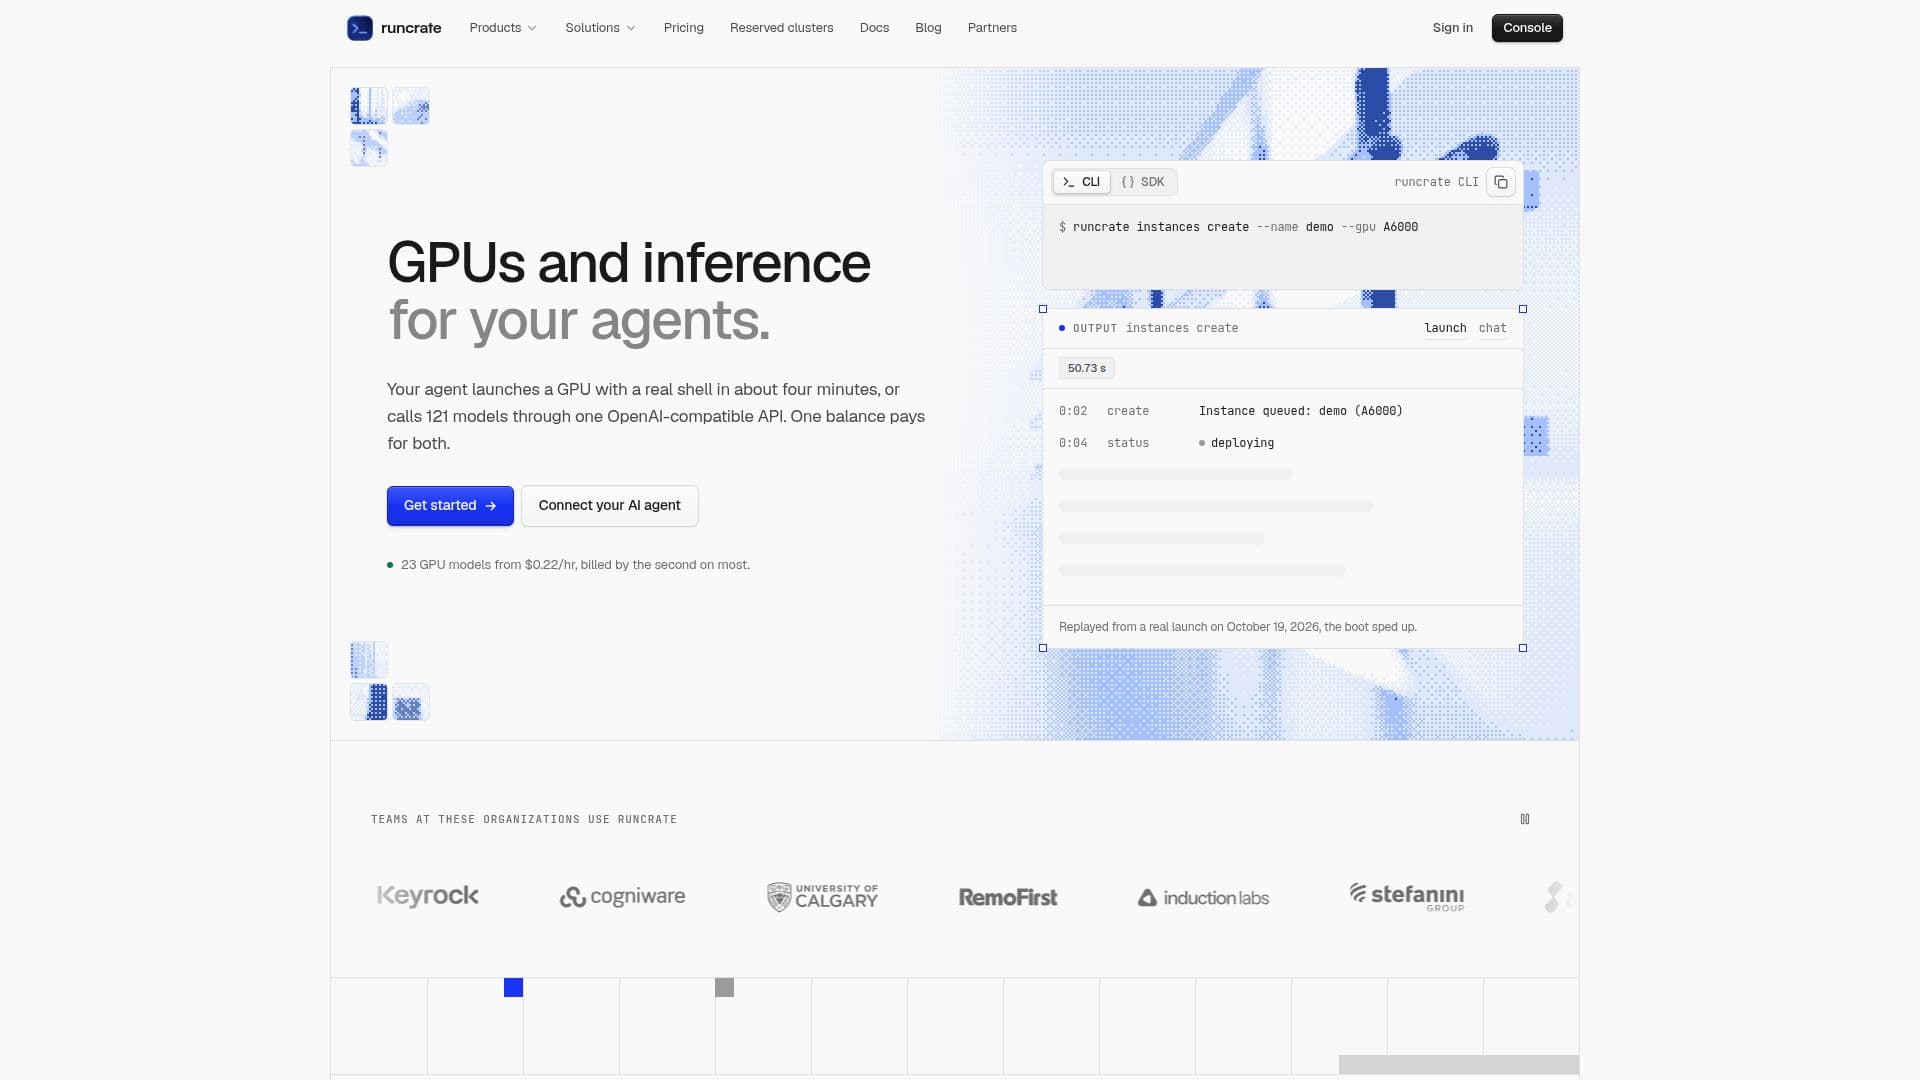
Runcrate, entwickelt von Aeonmind, bietet eine umfassende KI-Cloud-Infrastruktur, die für KI- und Machine-Learning-Teams konzipiert ist. Es bietet bedarfsgesteuerten Zugriff auf leistungsstarke GPUs, einschließlich H100, H200, A100, L40S und RTX 4090, die für die meisten Modelle pro Sekunde abgerechnet werden. GPU-Instanzen können innerhalb von Minuten gestartet und betriebsbereit gemacht werden, wodurch Genehmigungswarteschlangen und Quotenanforderungen entfallen.
Weiterlesen
Die Plattform verfügt auch über eine OpenAI-kompatible Inferenz-API, die es Benutzern ermöglicht, 121 verschiedene Modelle für verschiedene Aufgaben wie Textgenerierung, Vision, Bildverarbeitung, Video, Sprache, Transkription und Einbettungen aufzurufen. Diese einheitliche API vereinfacht die Integration und Nutzung von Modellen, wobei ein einzelner Kontostand sowohl die GPU-Nutzung als auch die Modellinferenz abdeckt.
Runcrate unterstützt eine Vielzahl von KI-Entwicklungsaktivitäten. Benutzer können offene Modelle wie Llama, Mistral oder Qwen mit ihren eigenen Daten unter Verwendung von LoRA feinabstimmen, Open-Source-LLMs auf dedizierten GPUs mit vLLM bereitstellen und Audio- und Videodateien im großen Maßstab mit der Whisper-API transkribieren. Die Plattform erleichtert auch das Ausführen von ComfyUI auf RTX 4090-Instanzen und die Entwicklung von RAG-Pipelines, indem Dokumente eingebettet und Chat-Modelle für Antworten verwendet werden.
Für die Datenpersistenz bietet Runcrate Speichervolumen, die Code, Daten und Checkpoints zwischen Instanzen speichern, sodass die Arbeit nicht verloren geht, wenn GPUs beendet werden. Die Abrechnung ist präzise und beginnt erst, wenn eine Instanz läuft, und wird typischerweise pro Sekunde berechnet, ohne Gebühren für die Bootzeit. Die Plattform integriert sich mit Tools wie Claude Code, Codex und Cursor, sodass Agenten GPU-Instanzen direkt starten und verwalten können.
Das Preismodell von Runcrate umfasst die Abrechnung pro Sekunde für GPU-Instanzen, die Abrechnung pro Token für Inferenz-API-Aufrufe und monatliche Tarife für Speichervolumen. Prepaid-Optionen sind für GPUs und Inferenz verfügbar, und Benutzer können Multi-Node-Cluster für langfristige Projekte reservieren. Die Vision des Unternehmens ist es, die KI-Entwicklung kostengünstiger und zugänglicher zu machen, indem Infrastrukturengpässe beseitigt und offene Modelle gefördert werden.
- KategorieMachine-Learning-Plattformen
- PreismodellBezahlen nach Nutzung
- BereitstellungCloud
- PlattformenWeb
Runcrate's Kernfunktionen
Bedarfsgesteuerte GPU-Instanzen (H100, H200, A100, L40S, RTX 4090)
Abrechnung pro Sekunde für die meisten GPUs
OpenAI-kompatible Inferenz-API mit 121 Modellen
Schnelle Bereitstellung von GPU-Instanzen (typischerweise innerhalb von Minuten)
Unterstützung für die Feinabstimmung von LLMs (Llama, Mistral, Qwen) mit LoRA/QLoRA
Bereitstellung von Open-Source-LLMs auf dedizierten GPUs mit vLLM
Whisper-API für Audio- und Video-Transkription
Speichervolumen für persistente Daten über Instanzen hinweg
Einheitliches Konto und Guthaben für alle Produkte (GPUs, Inferenz, Speicher)
Integration mit KI-Agenten und Entwickler-Tools (Claude Code, Codex, Cursor)
Prepaid-Optionen und reservierte Cluster verfügbar
Keine Abrechnung während der GPU-Bootzeit
Zugriff auf Jupyter und VS Code im Browser
Bereitgestellte Images für Feinabstimmung und Bereitstellung
Automatische Aufladung zur Verwaltung von Kreditgrenzen
Wie verwendet man Runcrate?
Verbinden: Fügen Sie Runcrate zu Ihrem bevorzugten Tool (Claude Code, Codex, Cursor oder Terminal) mit einem Befehl hinzu.
Anmelden: Genehmigen Sie den Zugriff über Ihren Browser, ohne einen Schlüssel einfügen zu müssen.
GPU starten: Bitten Sie Ihren Agenten, eine bestimmte GPU mit einem gewünschten Crate zu starten, z.B. „Starten Sie eine H100 mit dem Finetune-Crate.“
Ressourcen konfigurieren: Wählen Sie Ihr GPU-Modell aus und konfigurieren Sie die erforderlichen Ressourcen.
Bereitstellen: Starten Sie die Instanz; die Abrechnung beginnt, wenn die GPU-Instanz läuft.
Verwalten: Bereitstellen, verwalten und beenden Sie GPU-Instanzen direkt vom Terminal oder integrierten Tools.
Nutzen: Verwenden Sie die GPU für das Training, die Bereitstellung von Modellen oder rufen Sie Modelle über die OpenAI-kompatible API auf.
Daten speichern: Halten Sie Ihre Arbeit zwischen Instanzen mithilfe persistenter Speichervolumen.
Runcrate's Anwendungsfälle
- Modelltraining
- KI-Inferenz
- Feinabstimmung von LLMs
- RAG-Pipelines
- Betrieb von KI-Agenten
- Bild- und Videoerzeugung
- Sprach- und Audioverarbeitung
- Computer Vision-Aufgaben
- Datenverarbeitung
- Forschung und Experimente