Beschreibung
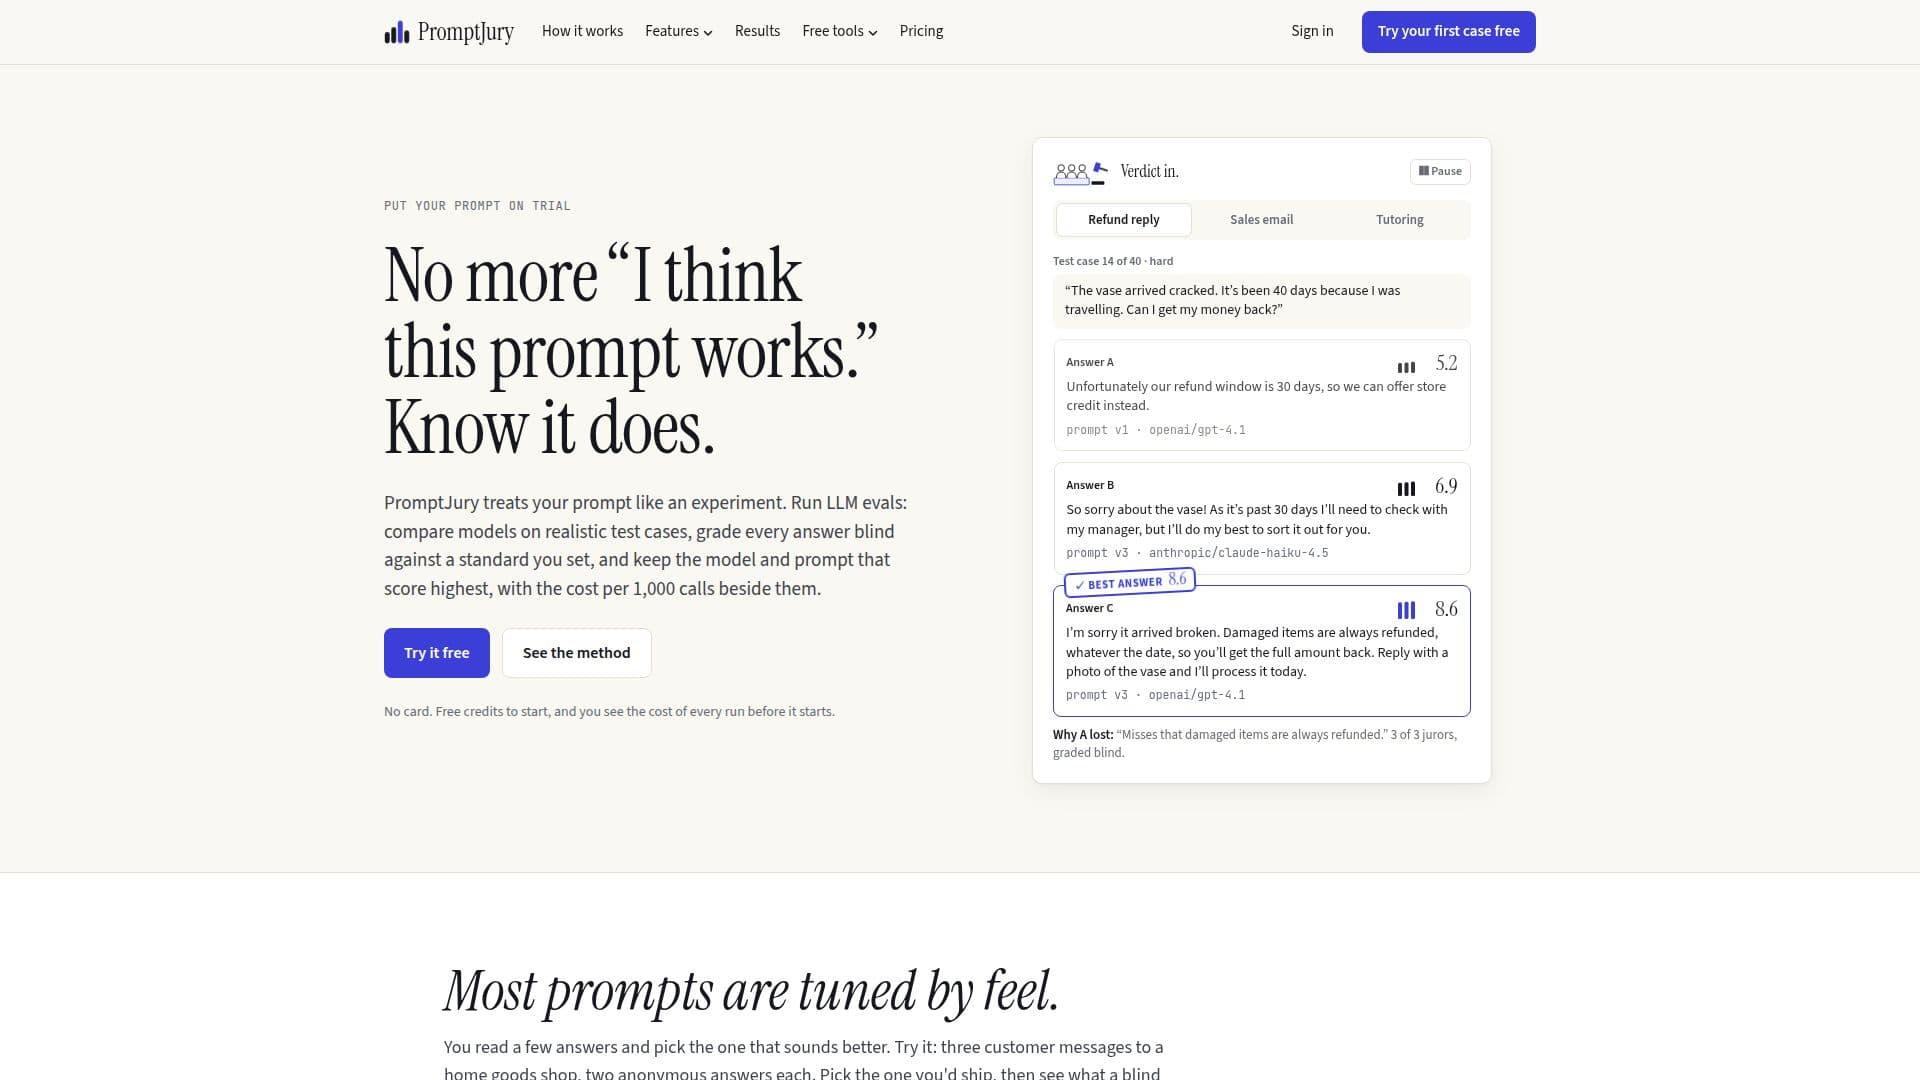
PromptJury bietet eine umfassende Plattform zur Bewertung von Large Language Models (LLMs) und Eingabeaufforderungen, die darauf ausgelegt ist, Nutzern zu helfen, datengestützte Entscheidungen über ihre KI-Anwendungen zu treffen. Der Dienst ermöglicht es Einzelpersonen und Teams, LLM-Bewertungen mit ihren benutzerdefinierten Eingabeaufforderungen durchzuführen und Modelle wie GPT, Claude und Gemini anhand blind bewerteter Testfälle zu vergleichen. Dieser Prozess zeigt, welche Modell- und Eingabeaufforderungskombinationen die höchsten Punktzahlen erzielen und welche Kosten mit jeder Option verbunden sind, und bietet einen wissenschaftlichen Ansatz für das Prompt Engineering.
Weiterlesen
Im Gegensatz zu entwicklerzentrierten Bewertungsplattformen, die SDKs, benutzerdefinierte Konfigurationen und vom Nutzer bereitgestellte Testsets erfordern, optimiert PromptJury den gesamten Bewertungsworkflow. Es generiert automatisch Bewertungsleitfäden und Testfälle, entwirft rivalisierende Eingabeaufforderungen und führt eine blinde Bewertung mit einer vielfältigen Jury von Modellen verschiedener Hersteller durch. Die Plattform liefert dann eine klare Empfehlung, einschließlich der gewinnenden Eingabeaufforderung, des Modells und der damit verbundenen Kosten, alles ohne dass Programmierkenntnisse erforderlich sind.
PromptJury gewährleistet die wissenschaftliche Strenge seiner Bewertungen, indem es eine klare Definition einer „guten Antwort“ festlegt, bevor die Bewertung beginnt. Jede Eingabeaufforderung und jedes Modell wird denselben Testfällen unterzogen, und die Bewertung erfolgt blind. Jede Punktzahl wird mit einem Bereich präsentiert, der es Nutzern ermöglicht, die Auswirkungen von Änderungen an ihren Eingabeaufforderungen oder Modellen genau zu bewerten. Das System geht Bedenken hinsichtlich der KI-Bewertung von KI nach, indem sichergestellt wird, dass der Bewertungsstandard vom Nutzer genehmigt wird, mehrere Modelle verschiedener Hersteller die Antworten bewerten, ohne die Quelle zu kennen, und kein Modell seine eigenen Ausgaben bewertet. Die Medianpunktzahl von drei oder mehr Bewertern verhindert eine Verzerrung durch einen einzelnen strengen oder großzügigen Juror.
Nutzer können jedes Chat-Modell vergleichen, das auf der Live-Liste von OpenRouter verfügbar ist, einschließlich Angeboten von OpenAI, Anthropic, Google, xAI, DeepSeek und Mistral. Die Plattform hilft auch dabei, günstigere Modelle zu identifizieren, die vergleichbare Leistungen wie die besten Mitbewerber erbringen, und bietet eine „Wertauswahl“ neben dem Gewinner. Dies umfasst Daten zu Kosten pro 1.000 Anrufen und potenzielle monatliche Einsparungen basierend auf benutzerdefinierten Anrufvolumina. Neue Konten erhalten 200 kostenlose Credits, um eine erste Bewertung ohne Kreditkarte durchzuführen, wobei kostenpflichtige Pläne bei 25 $ pro Monat beginnen. Der Dienst erfordert keine API-Schlüssel, SDKs oder ein OpenRouter-Konto, da alle Modellaufrufe über das eigene OpenRouter-Konto von PromptJury verwaltet und mit Benutzer-Credits bezahlt werden. Die Plattform unterstützt subjektive Ausgaben, indem sie es Nutzern ermöglicht, Qualitätsdimensionen mit schriftlichen Beispielen zur Bewertung zu definieren. Nutzer können auch ihre eigenen Testfälle über CSV- oder JSONL-Dateien hochladen oder die systemgenerierten bearbeiten. PromptJury erklärt ausdrücklich, dass es nicht auf Benutzeraufforderungen oder Daten trainiert, um die Privatsphäre und Kontrolle über die Inhalte der Nutzer zu gewährleisten.
- KategoriePrompt-Engineering-Tools
- PreismodellFreemium
- BereitstellungCloud
- PlattformenWeb
PromptJury's Kernfunktionen
LLM-Bewertungsplattform
Vergleich von GPT, Claude, Gemini und anderen Modellen
Blind bewertete Testfälle
Automatisierte Testfallgenerierung
Automatisierte Erstellung von Bewertungsleitfäden
Entwirft rivalisierende Eingabeaufforderungen
Bewertungsprozess ohne Programmierung
Kosten pro 1.000 Anrufen angezeigt
Identifiziert Wertauswahl (günstigstes gutes Modell)
Unterstützt die Bewertung subjektiver Ausgaben
Hochladen benutzerdefinierter Testfälle (CSV, JSONL)
Kein API-Schlüssel oder SDK erforderlich
Trainiert nicht auf Benutzerdaten
Geplante Regressionstests (Wiederholungen)
Private Urteilsberichte
Wie verwendet man PromptJury?
Aufgabe beschreiben: Definieren Sie das Ziel Ihrer KI und ihr Publikum in zwei Sätzen.
Bewertungsleitfaden erstellen: Genehmigen Sie, wie eine großartige Antwort aussieht, dimensioniert nach Dimension, mit einer Skala für jede.
Konkurrenzfähige Eingabeaufforderungen generieren: Lassen Sie Modelle rivalisierende Eingabeaufforderungen entwerfen und sich gegenseitig anhand Ihres Bewertungsleitfadens kritisieren.
Testfälle sammeln: Verwenden Sie systemgenerierte realistische Eingaben oder laden Sie Ihre eigene CSV/JSONL-Datei hoch.
Blindversuch durchführen: Jede Eingabeaufforderung und jedes Modell beantwortet jeden Testfall, wobei ein separates Gremium die Antworten blind bewertet.
Urteil überprüfen und verbessern: Erhalten Sie die beste Eingabeaufforderung und das beste Modell, mit Nachweisen und Vorschlägen zur weiteren Verbesserung.
PromptJury's Anwendungsfälle
- Eingabeaufforderungsoptimierung
- Modellvergleich
- Qualitätssicherung
- Kosteneffizienz
- Bewertung subjektiver Ausgaben
- Regressionstests
- Kundenberichterstattung
- Entwicklung von KI-Funktionen