Beschreibung
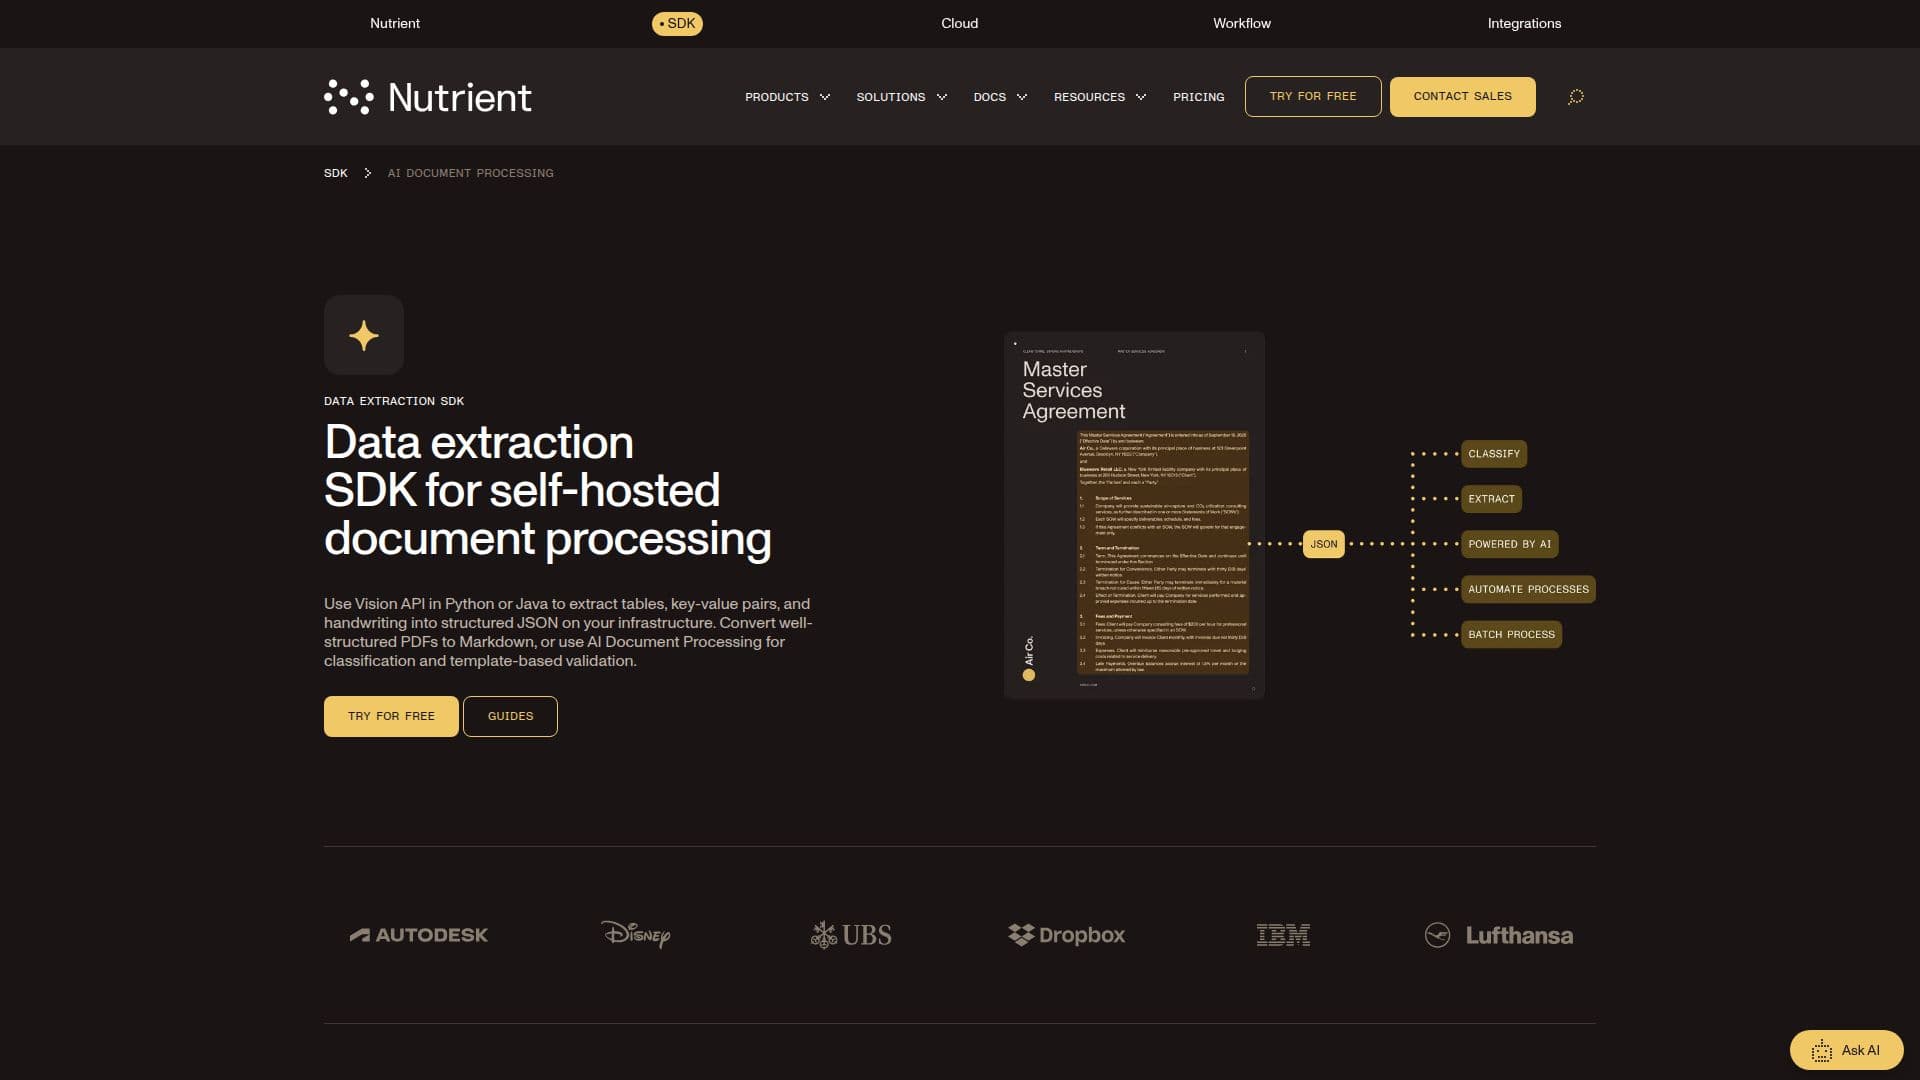
Nutrient AI Dokumentenverarbeitung ist ein SDK zur Extraktion von Dokumentendaten, das zuvor unter dem Namen XtractFlow von Nutrient (ehemals PSPDFKit) verkauft wurde. Es läuft als Teil der Python- und Java-SDKs von Nutrient und wurde entwickelt, um Rechnungen, Bestellungen, Ausweisdokumente, Lebensläufe und Quittungen auf der eigenen Infrastruktur eines Unternehmens zu verarbeiten, anstatt über einen Cloud-Dienst eines Drittanbieters.
Weiterlesen
Ein LLM identifiziert den Dokumenttyp und leitet ihn an eine passende Extraktionsvorlage weiter; zehn Vorlagen sind sofort einsatzbereit und decken Dokumente wie Rechnungen, Pässe, Ausweise und Quittungen ab. Benutzerdefinierte Vorlagen können erstellt werden, indem die benötigten Felder in einfacher Sprache beschrieben werden, anstatt Regeln oder reguläre Ausdrücke zu schreiben. Extrahierte Werte werden von elf integrierten Validierern überprüft, darunter IBAN, USt-IdNr., Kreditkartennummer, Postadresse, E-Mail und Telefonnummer; jeder Wert, der eine Überprüfung nicht besteht, wird als verifiziert gekennzeichnet, anstatt stillschweigend akzeptiert zu werden.
Die gleiche Produktseite behandelt auch Nutrients Data Extraction SDK auf niedrigerer Ebene, das strukturiertes JSON mit Elementkoordinaten, Leseordnung und Vertrauenswürdigkeitsscores mithilfe von OCR, On-Premises-AI-Modellen für Layout und Handschrift (ICR) oder einem Vision-Language-Modell zurückgibt, das lokal mit Qwen ausgeführt oder mit einem Cloud-Anbieter wie Claude oder OpenAI verbunden werden kann. Es liest mehr als 100 Dateitypen, darunter gescannte PDFs, Office-Dokumente, CAD-Dateien und über 40 Kamera-RAW-Formate, und verarbeitet mehrspaltige Layouts, gemischte Sprachen und schiefe Scans. Ein separater PDF-zu-Markdown-Modus konvertiert bereits digitale PDFs in sauberes Markdown, ohne ein AI-Modell auszuführen.
Die AI Dokumentenverarbeitung benötigt einen verbundenen LLM-Anbieter (OpenAI oder Azure OpenAI); die OCR-, ICR- und PDF-zu-Markdown-Modi laufen vollständig lokal, ohne dass Netzwerkzugang erforderlich ist. Die Datenextraktion ist heute für Python (3.8+) und Java (8+) verfügbar, mit geplanter Unterstützung für .NET und eine DWS Processor API; eine kostenlose Testversion wird angeboten, ohne dass Zahlungsinformationen erforderlich sind.
Dies ist ein Entwickler-SDK, kein gehostetes No-Code-Tool, das sich an Ingenieurteams richtet, die Rechnungsverarbeitung, ID-Verifizierung oder Dokumentenaufnahme-Pipelines erstellen, die kontrollieren müssen, wohin ihre Dokumente und Daten gehen. Die plattformübergreifende Unterstützung für die AI Dokumentenverarbeitung über die derzeitige Verfügbarkeit hinaus wird als bald verfügbar aufgeführt, anstatt heute ausgeliefert zu werden.
- KategorieWeb Scraping & Datenextraktion
- PreismodellKomponentenbasiert
- BereitstellungOn-Premises, Cloud
- PlattformenPython, Java
Nutrient AI Dokumentenverarbeitung's Kernfunktionen
LLM-basierte Dokumentklassifizierung, die jedes Dokument an eine passende Extraktionsvorlage weiterleitet
Zehn sofort einsatzbereite Vorlagen für Rechnungen, Pässe, Ausweise, Quittungen und mehr
Benutzerdefinierte Extraktionsvorlagen, die in einfacher Sprache definiert sind, ohne dass Regex oder Regel-Engine erforderlich sind
Elf integrierte Validierer (IBAN, USt-IdNr., Kreditkarte, Postadresse, E-Mail, Telefonnummer und mehr)
Drei Extraktionsmotoren (OCR, ICR und VLM), die in strukturiertes JSON mit Koordinaten und Vertrauenswürdigkeitsscores zusammengeführt werden
On-Premises-Verarbeitung für jeden Motor, einschließlich des Vision-Language-Modells, mit Cloud-Anbietern, die nur verbunden werden, wenn dies gewünscht ist
Unterstützung für mehr als 100 Dateitypen, einschließlich gescannter PDFs, Office-Dokumente und CAD-Dateien
PDF-zu-Markdown-Konvertierung für digital geborene PDFs, ohne dass ein AI-Modell oder Netzwerkzugang erforderlich ist
Python- und Java-SDKs sind heute verfügbar, mit geplanter Unterstützung für .NET und eine DWS Processor API
Wie verwendet man Nutrient AI Dokumentenverarbeitung?
SDK installieren: Fügen Sie das Nutrient Python- oder Java-SDK zu Ihrem Projekt hinzu.
Extraktionsmodus auswählen: Wählen Sie PDF zu Markdown für saubere digitale PDFs oder Datenextraktion (OCR, ICR oder VLM) für Scans und komplexe Layouts.
Ein LLM verbinden (optional): Für die AI Dokumentenverarbeitung konfigurieren Sie einen OpenAI- oder Azure OpenAI-Schlüssel, um Klassifizierung und Vorlagen zu aktivieren.
Extraktion durchführen: Verarbeiten Sie ein Dokument und erhalten Sie strukturiertes JSON mit Koordinaten, Vertrauenswürdigkeitsscores und Leseordnung.
Felder validieren: Integrierte Validierer kennzeichnen Werte, wie eine IBAN oder USt-IdNr., die eine Formatüberprüfung nicht bestehen.
Auf Ihrer Infrastruktur bereitstellen: Führen Sie das SDK selbstgehostet aus, da die Dokumentendaten in Ihrem Netzwerk bleiben, es sei denn, Sie verbinden einen Cloud-Anbieter.
Nutrient AI Dokumentenverarbeitung's Anwendungsfälle
- Rechnungsverarbeitung
- ID- und Passverifizierung
- Digitalisierung gescannter Dokumente
- Selbstgehostete Datenpipelines