Beschreibung
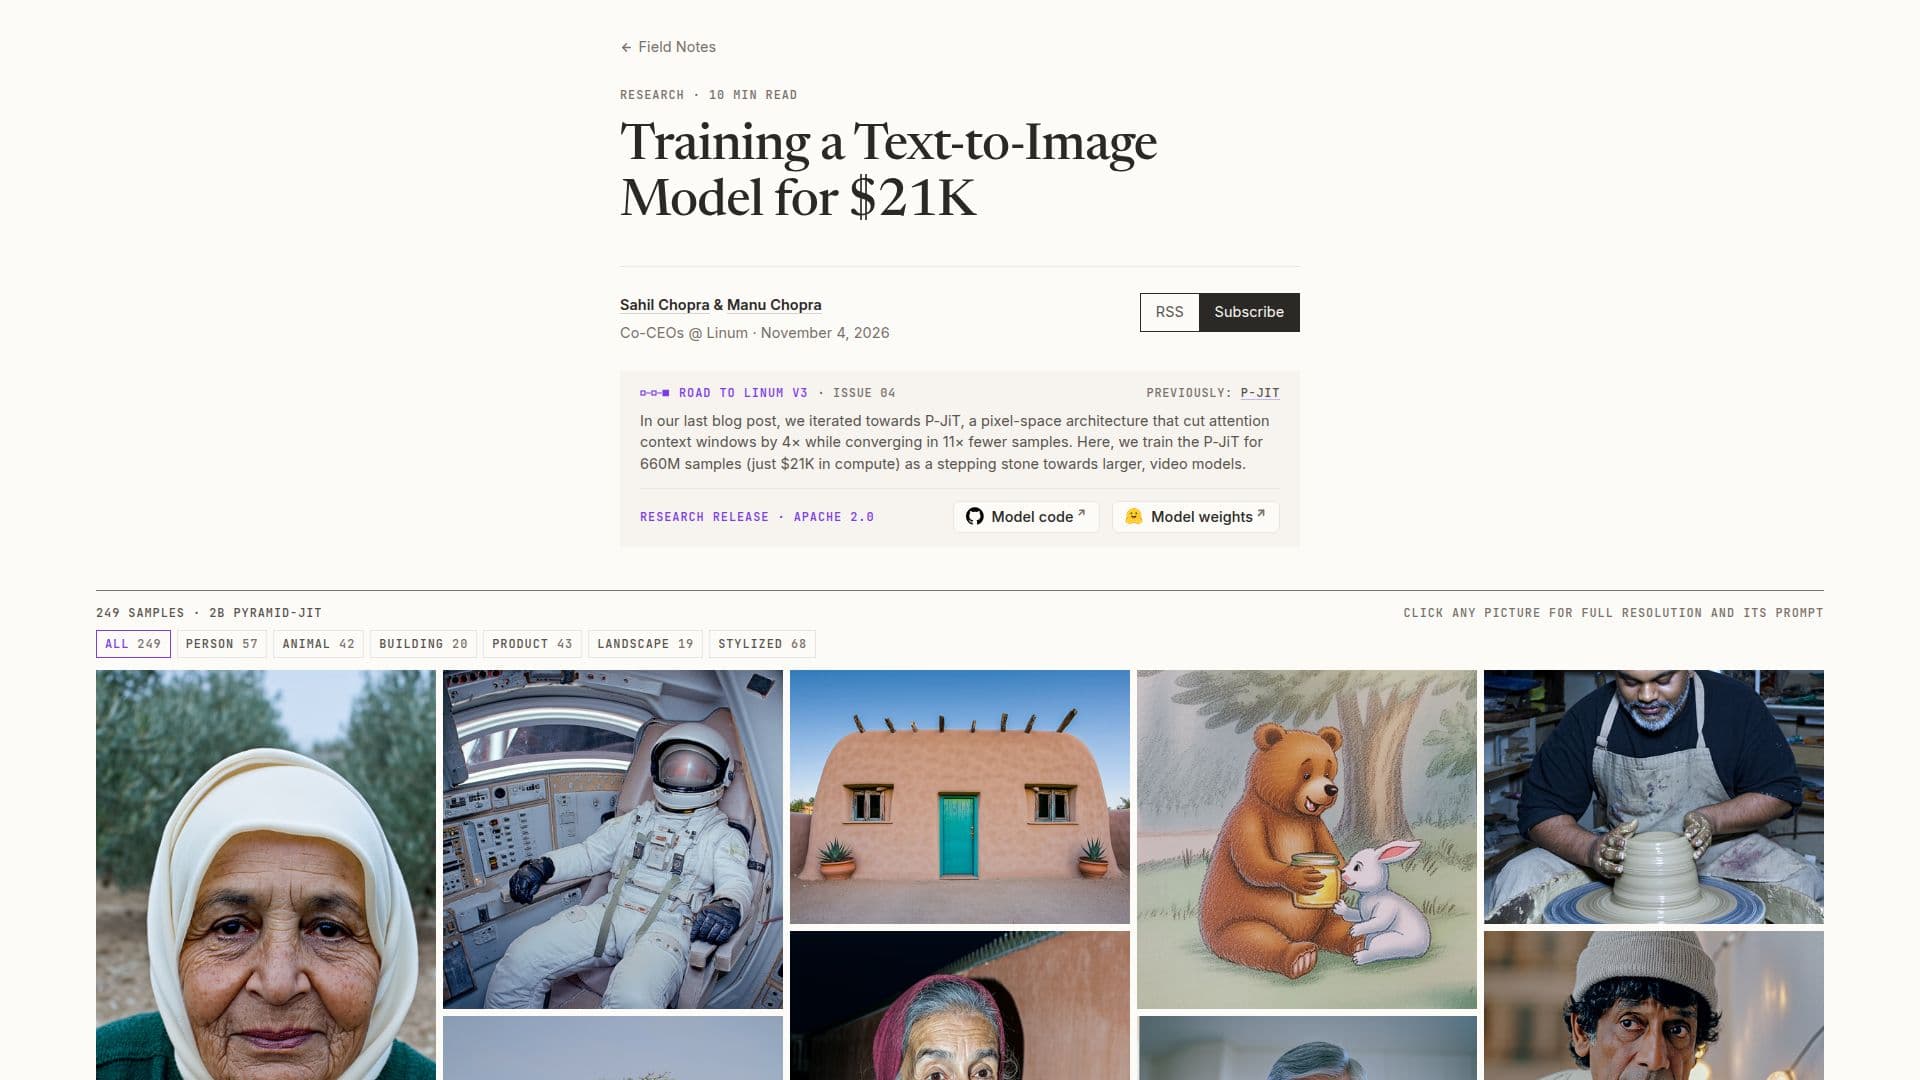
Linum P-JiT ist ein experimentelles Text-zu-Bild-Modell, das von Linum, einem zweiköpfigen Forschungslabor, das sich der Ausbildung generativer Videomodelle von Grund auf widmet, entwickelt wurde. Dieses spezielle Modell, ein 2B-Parameter Pyramid-JiT (P-JiT), dient als Proof-of-Concept für ihre laufende Forschung zur Demokratisierung des Zugangs zu Animation durch kostengünstige und kontrollierbare generative Werkzeuge. Der Trainingslauf für dieses Modell kostete etwa 21.038 USD und zeigt das Potenzial für qualitativ hochwertige Ergebnisse bei relativ geringen Rechenkosten.
Weiterlesen
Die zentrale Innovation hinter P-JiT ist die Fähigkeit, aggressivere Kompression und schnelleres Lernen zu erreichen, indem der traditionelle Variational Autoencoder (VAE) aus der Architektur des Diffusionsmodells entfernt wird. Stattdessen lernt das Diffusionsmodell einen latent space, der speziell für seinen Anwendungsfall entwickelt wurde, was eine größere Kompression und verbesserte Generierung ermöglicht. Dieses Pixelraum-Modell konvergiert in 11-mal weniger Proben als Linum v2 und bietet eine viermal aggressivere Token-Reduktion, was ein 512x512-Bild mit der gleichen Anzahl von Tokens darstellt, die zuvor für ein 256x256-Bild verwendet wurden. Dies führt zu einer vierfachen Reduzierung des Attention-Kontextfensters, was die Trainings- und Inferenzkosten erheblich senkt.
Die P-JiT-Architektur umfasst eine Text- und Bildverarbeitungspipeline, in der jede Modalität durch einzelne „Refiner“-DiT-Blöcke für die Einzelmodalität geht, bevor sie in einen Strom von 22 identischen DiT-Blöcken zusammengeführt wird. Die Textdarstellung stammt von einem eingefrorenen Qwen3.5-4B-Modell, während Bilder in 32x32-Patches unterteilt und in einen 1024-dimensionalen Raum komprimiert werden. Das Modell verfügt auch über PixelREPA-Ausgaben, die auf DINOv3-L ausgerichtet sind, sowie zusätzliche lineare Ausgabeköpfe entlang des Stammes, um die Konvergenz zu beschleunigen, indem niedrigauflösende Versionen des endgültigen Bildes vorhergesagt werden.
Das Training wurde in mehreren Phasen durchgeführt, beginnend mit einer Auflösung von 512x512 für 610 Millionen Proben und dann übergehend zu einer Auflösung von 1024x1024 für 50 Millionen Proben. Ein Curriculum über den Geräuschzeitplan wurde eingesetzt, das zunächst auf hohes Geräusch konzentrierte, um die grundlegende Struktur zu lernen, und dann die Verteilung für feinkörnige Details erweiterte. Nach dem Training wurde eine Variante der Finite Difference Flow Optimization (FDFO) mit JEV-Image und menschlichen Richtern in der Schleife verwendet. Während das Modell vielversprechende Ergebnisse zeigt, hat es Einschränkungen, insbesondere bei der Generierung von Ganzkörperbildern, mehreren Entitäten, Interaktionen zwischen mehreren Personen und Weltwissen, die für Modelle seiner Größe typisch sind. Es wurde nicht mit Bildern von gerendertem Text trainiert und kann daher keinen Text oder Poster generieren.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
Linum P-JiT's Kernfunktionen
Pyramid-JiT (P-JiT) Architektur: Neuartiges Pixelraum-Modell für effiziente Generierung
2B-Parameter DiT: Kern-Diffusions-Transformator-Modellgröße
4B Text-Encoder: Nutzt ein eingefrorenes Qwen3.5-4B-Modell für die Textdarstellung
VAE-freies Design: Beseitigt VAE für aggressivere Kompression und schnelleres Lernen
4x Token-Reduktion: Stellt 512x512-Bilder mit 4x weniger Tokens als Linum v2 dar
11x schnellere Konvergenz: Erreicht Ergebnisse mit deutlich weniger Trainingsproben
Multi-Stage-Training: Fortschritt von 512x512 zu 1024x1024 Auflösung
Curriculum-Geräuschzeitplan: Passt die Geräuschverteilung für Struktur- und Detaillernen an
PixelREPA-Ausgaben: Richtet den latenten Raum auf DINOv3-L aus, um das Detaillernen zu verbessern
Lineare Ausgabeköpfe: Vorhersage sauberer Bilder in Viertel- und Halbe-Auflösung zur beschleunigten Konvergenz
Finite Difference Flow Optimization (FDFO): Wird zur Nachbearbeitung verwendet
Apache 2.0 Lizenz: Gewichte werden unter einer Open-Source-Lizenz veröffentlicht
Kosteneffizientes Training: Erzielte qualitativ hochwertige Ergebnisse für etwa 21.000 USD
Fokus auf generative Video-Forschung: Ein Schritt in Richtung zukünftiger Videomodelle
Wie verwendet man Linum P-JiT?
Architektur verstehen: Überprüfen Sie die Details der P-JiT-Architektur, einschließlich der Text- und Bildverarbeitungsflüsse.
Trainingsregime untersuchen: Erfahren Sie mehr über den mehrstufigen Trainingsprozess, Geräuschzeitpläne und Auflösungsübergänge.
Modellbeschränkungen erkunden: Verstehen Sie die aktuellen Einschränkungen hinsichtlich der Ganzkörpergenerierung, mehrerer Entitäten und der Textgenerierung.
Zugriff auf Trainingseinstellungen: Verweisen Sie auf Anhang A für detaillierte Trainingsparameter und Konfigurationen.
Kostenaufstellung überprüfen: Sehen Sie sich die Aufschlüsselung der Vor- und Nachtraining-Rechenkosten an.
Beispielhafte Fehler analysieren: Studieren Sie die bereitgestellten Beispiele für Modellfehler, um die aktuellen Fähigkeiten und Verbesserungsbereiche zu verstehen.
Linum P-JiT's Anwendungsfälle
- Forschung zur Text-zu-Bild-Generierung
- Kosteneffizientes Modelltraining
- Entwicklung generativer Videomodelle
- Testen architektonischer Innovationen
- Open-Source KI-Experimentierung