Beschreibung
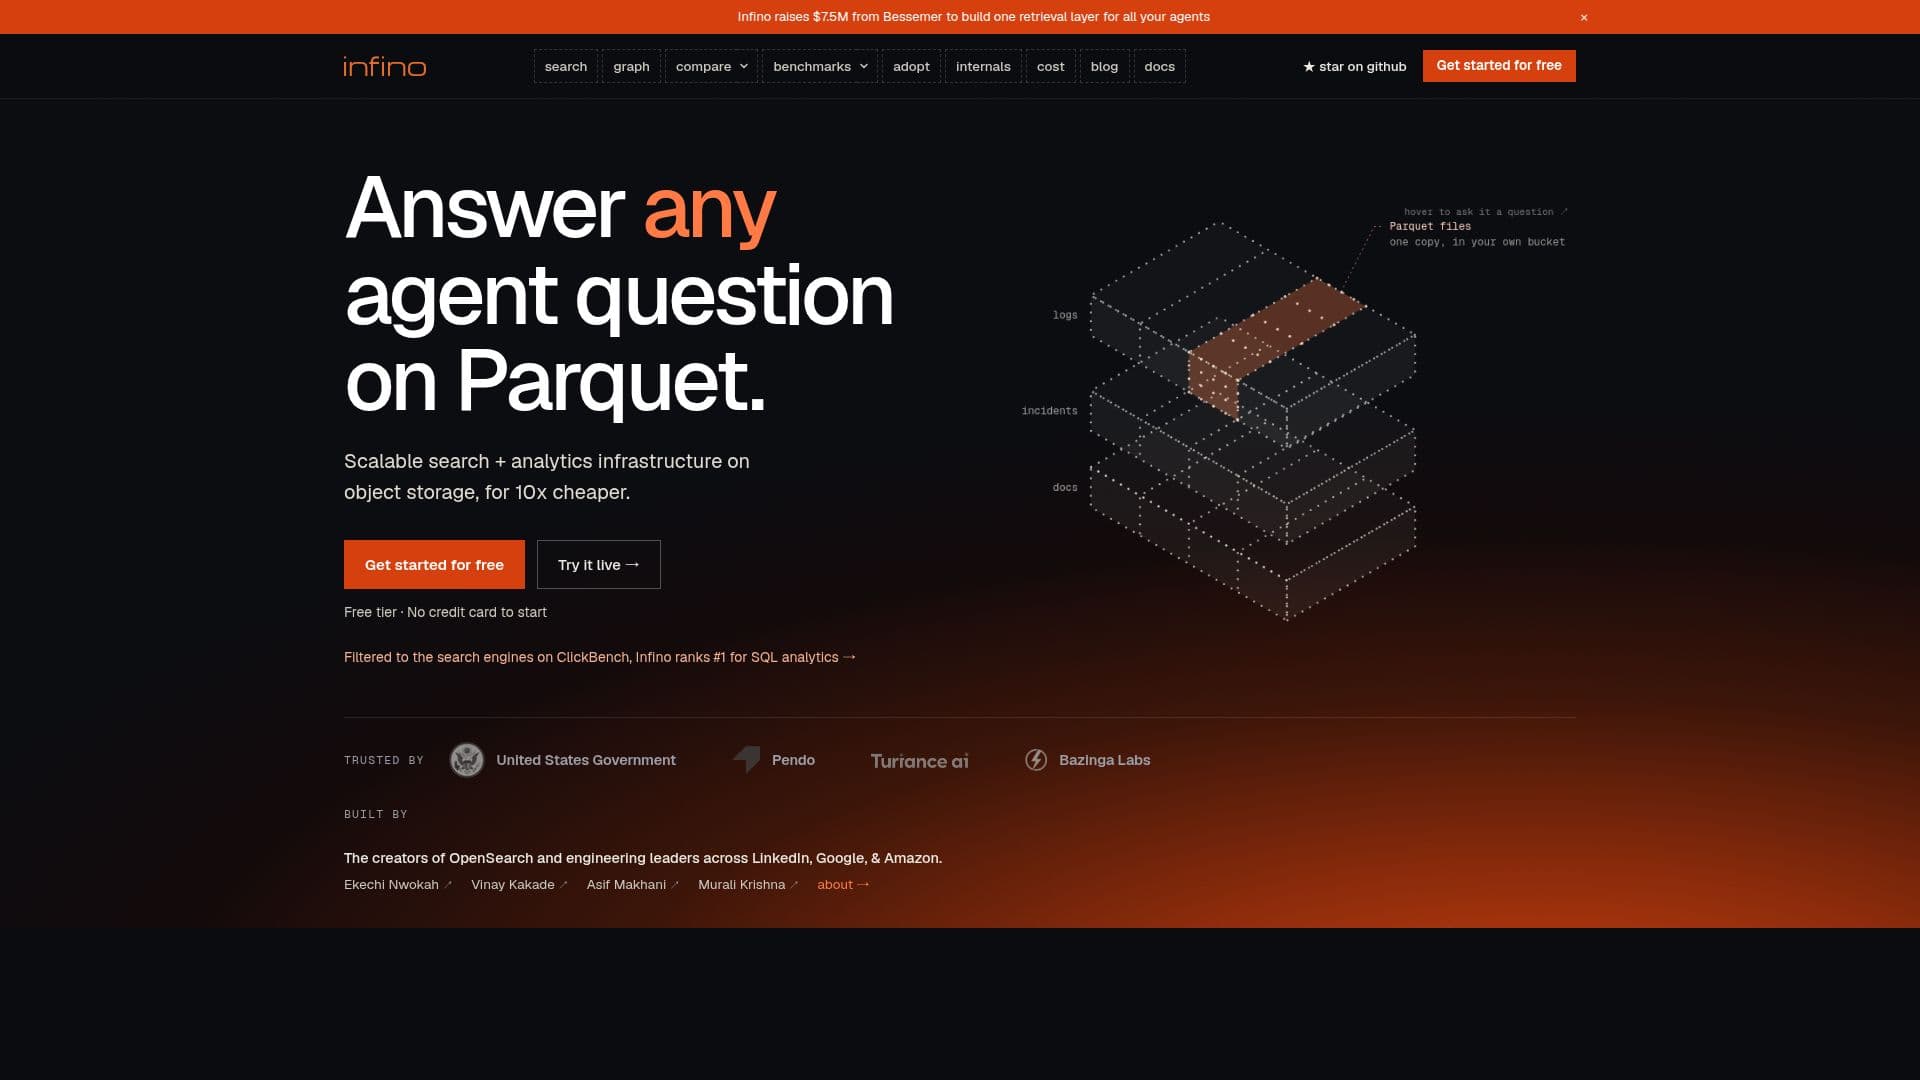
Infino ist eine Open-Source-Retrieval-Engine, die Volltext-, Vektor- und SQL-Suchfunktionen nativ über Apache Parquet-Dateien bereitstellt, die in Object Storage gespeichert sind. Diese Architektur ermöglicht eine skalierbare Such- und Analyseinfrastruktur zu einem erheblich niedrigeren Preis, oft als 10x günstiger als traditionelle Lösungen zitiert.
Weiterlesen
Der Kern der Funktionalität von Infino liegt in seiner Fähigkeit, verschiedene Suchfunktionen direkt in SQL-Abfragen einzubetten. Das bedeutet, dass KI-Agenten komplexe Fragen formulieren können, die typischerweise mehrere Schritte über verschiedene Datenbanken erfordern würden (z. B. Schlüsselwortsuche, semantische Suche, Graphsuche und SQL-Aggregationen), in einer einzigen, einheitlichen SQL-Anweisung. Infino übernimmt die zugrunde liegende Komplexität und führt diese kombinierten Suchmodi aus, um hochgenaue Retrieval-Ergebnisse zu liefern.
Die Engine unterstützt mehrere Suchtypen, einschließlich BM25 für die Volltextsuche, HNSW und OPANN + Sq16 für die Vektorisierung sowie hybride Suchen, die diese Methoden kombinieren. Sie integriert auch Graphsuchfunktionen, die die Identifizierung von verknüpften Datensätzen basierend auf gemeinsamen Schlüsseln ermöglichen. Dieser multimodale Ansatz verbessert die Genauigkeit und Effizienz des Retrievals.
Infino ist auf Leistung und Kosteneffizienz ausgelegt und nutzt weniger Speicher und Rechenressourcen, indem es Daten auf kostengünstigem Object Storage speichert und gleichzeitig hohe Abfragegeschwindigkeiten aufrechterhält. Es bietet flexible Bereitstellungsoptionen: Benutzer können die Open-Source-Kern-Engine selbst auf ihrem Object Storage (S3, GCS, Azure Blob oder lokale Festplatte) ausführen oder sich für Infino Cloud entscheiden, einen verwalteten Multi-Tenant-Serverless-Service. Eine Enterprise-Option bietet Single-Tenant-Bereitstellungen mit zusätzlichen Funktionen wie Multi-Node-Abfragen und kundenverwalteten Schlüsseln.
Für vorhandene Parquet-Daten kann Infino Retrieval-Indizes durch einen Prozess namens Hydration erstellen, der es aktuellen Tools wie DuckDB, pandas und Spark ermöglicht, die spaltenbasierten Daten weiterhin zu lesen, während Infino den indizierten Zugriff bereitstellt. Dies macht es zu einer ergänzenden Lösung für bestehende Datenplattformen, die in der Lage ist, dedizierte Retrieval-Pfade wie Elasticsearch oder Vektordatenbanken für spezifische Arbeitslasten zu ersetzen, während es nahtlos mit Data Warehouses und Lakehouses integriert wird.
- KategorieVektordatenbanken & Retrieval
- PreismodellFreemium
- BereitstellungCloud, On-Premise, Selbstgehostet
- PlattformenWeb
Infino's Kernfunktionen
Open-Source-Retrieval-Engine
Volltextsuche (BM25)
Vektorsuche (HNSW, OPANN + Sq16)
Hybride Suche, die mehrere Modi kombiniert
SQL-Abfragesupport (Apache DataFusion)
Native Operation auf Apache Parquet-Dateien
Kompatibilität mit Object Storage (S3, GCS, Azure Blob)
Graphsuchfunktionen
Funktionen in SQL für komplexe Abfragen eingebettet
Kosteneffiziente und skalierbare Architektur
Niedrige Latenz bei Abfragen
On-Premise- und gehostete Cloud-Bereitstellungsoptionen
SOC 2 Typ II konform (Infino Cloud)
TLS während der Übertragung und AES-256-Verschlüsselung im Ruhezustand
Datenhydration für vorhandene Parquet-Dateien
Wie verwendet man Infino?
Infino installieren: Verwenden Sie `pip install infino` oder `npm install @infino-ai/infino`, um die Open-Source-Kern-Engine einzurichten.
Daten speichern: Halten Sie Ihre Daten im Apache Parquet-Format in Ihrem eigenen Object Storage-Bucket (S3, GCS, Azure Blob) oder auf einer lokalen Festplatte.
Daten ingestieren: Fügen Sie neue JSON-, Arrow-, Spalten- oder Vektordaten über Infino hinzu oder hydratisieren Sie vorhandene Parquet-Dateien, um Retrieval-Indizes zu erstellen.
Abfragen formulieren: Stellen Sie komplexe Fragen mit einer einzigen SQL-Anweisung, indem Sie die eingebetteten Funktionen von Infino für Schlüsselwort-, semantische und Graphsuche nutzen.
Suchen ausführen: Führen Sie Abfragen aus, um Volltext-, Vektor- oder hybride Suchen durchzuführen und rangierte Ergebnisse direkt aus Ihren Parquet-Daten abzurufen.
Ergebnisse analysieren: Nutzen Sie die zurückgegebenen Daten für agentische Anwendungen oder integrieren Sie sie mit anderen Parquet-Readern wie DuckDB, Spark oder pandas für weitere Analysen.
Infino's Anwendungsfälle
- Agentische Fragenbeantwortung
- Kosteneffizientes Datenretrieval
- Vereinheitlichte Suche und Analyse
- Protokollanalyse und Vorfallreaktion
- Integration von Data Lakehouses
- Semantische Suche auf unstrukturierten Daten
- Echtzeit-Datenexploration